巨型魔方的一个常数从10⁴⁰降到了30.5
魔方刚满50岁,它或许是世界上最著名的益智玩具,而它的核心问题之一说起来很简单:在最坏的情况下,需要多少步才能复原?对于经典的3×3×3魔方,答案是精确已知的:20步,这一结果由一个团队于2014年发表,团队成员中就有这篇新论文的作者之一Tomas Rokicki。
对于更大的魔方,即每条棱上有n层的魔方,精确答案无法企及——最优地复原一个给定的n×n×n魔方甚至是NP完全问题。但在2011年,Erik Demaine和同事们证明了最坏情况如何增长:与n² / lg n成正比,其中lg是以2为底的对数。这比标准方法好了一个对数因子,标准方法基本上是逐个复原各个块。
一个带着荒谬常数的证明
但这里有个问题。2011年的结果保证的是增长速度,而不是它前面的系数。作者们仔细推演了那个算法,发现它的常数约为1.01 × 10⁴⁰。罪魁祸首是一项计算机验证:它证明了某些操作可以到达一组24个块的每一种排列,却没有说明能多快到达。这一长度唯一稳妥的上界就是这组排列的数量,约3.1 × 10²³步,而公式最终在两个地方用到了巨大的数24!(1 × 2 × … × 24,约6.2 × 10²³)。相比之下,下界——几乎每个被打乱的魔方都需要的步数——的常数相当温和,约为12.88。因此,该领域的许多人认为,对于合理的尺寸,这样的算法永远不可能实用。
来自MIT、慕尼黑工业大学和帕洛阿尔托的Jeremy Mrzyglocki、Tomas Rokicki、Maxine Perroni-Scharf和Erik Demaine,如今把这个常数变得明确,而且很小。
用于魔方块的排序网络
在大魔方上,中心块占主导:它们的数量按n²增长,而角块和棱块只贡献与n成正比的项。中心块分成若干个24块一组的家族,每个家族的块只能在内部相互交换。基本工具是交换子(commutator),即形如A B A′ B′的操作序列,它几乎让一切保持原位,只置换同一家族中的三个块。团队为全部4,000种可用的三块交换都找到了操作序列,每个序列最多12步。
有两个想法让步数降了下来。第一,同一个交换子可以同时作用于许多家族,跨越整组的行和列。第二,不再单独复原每个家族,而是让每个家族都遵循同一个固定的、由交换组成的通用序列(universal sequence),只需跳过自己不需要的那些交换。一条引理把一切联系在一起:一个L个阶段的通用序列会给出L/2的首项常数。
缩短这个序列,借助的是计算机科学中排序网络(sorting networks)的工具:排序网络是固定的比较模式,可以对任何输入进行排序。一个最优的六输入排序网络给出96个阶段,因此常数为48。通过计算机搜索找到的网络先把24个位置分成12个一组,再分成4个一组,把阶段数降到72(常数36)。最后,允许一次打乱三个以上块的操作,并以不同方式划分位置,把它降到了61个阶段。
三十点五
定理:任何n×n×n魔方都可以在至多30.5 n²/lg n步内复原,外加对大n可以忽略不计的项。常数改进了超过3.30 × 10³⁸倍,并且与下界只差2.37倍(30.5 / 12.88)。对于作为热身的平面n×n×1版本,常数从12或18降到了1.5。
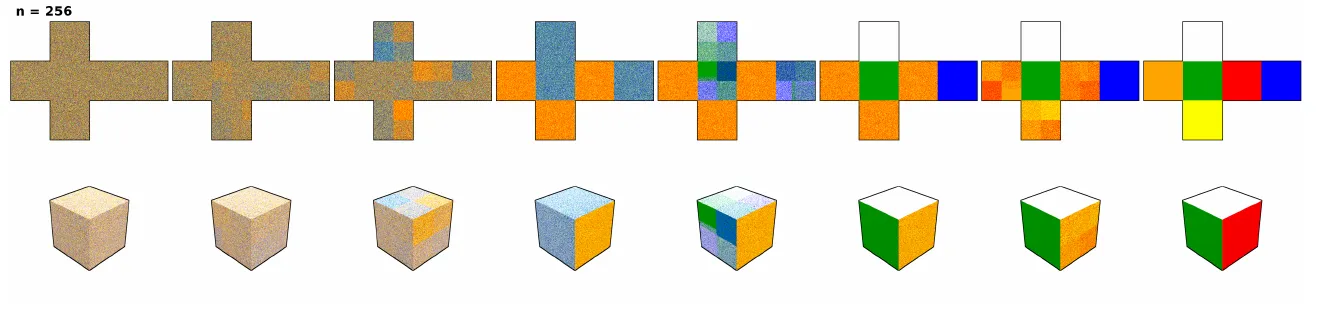
一个每边256层的魔方在复原过程中等间隔选取的八帧画面:打乱的各个面逐渐变成纯色。——图1.1,Mrzyglocki等(2026),arXiv:2611.11018。
该算法的运行时间与块的数量成正比,作者还提供了一个开源求解器,附有脚本,可以穷举检查它所依赖的每一个网络。他们自己的比较发现,从大约n = 840起,它就领先于现有的求解器;他们已经渲染了每边256层和65,536层的魔方的复原过程。
2.37是一个渐近性的结论:公式中的较小项并没有被确定下来,因此它无法给出某个具体魔方的精确步数。作者认为,未来的改进可能来自把块分组到排序网络中的其他方式,以及更好的三块交换——而同一套机制还可以用来对付其他巨型谜题,或者四维和五维的超立方体。