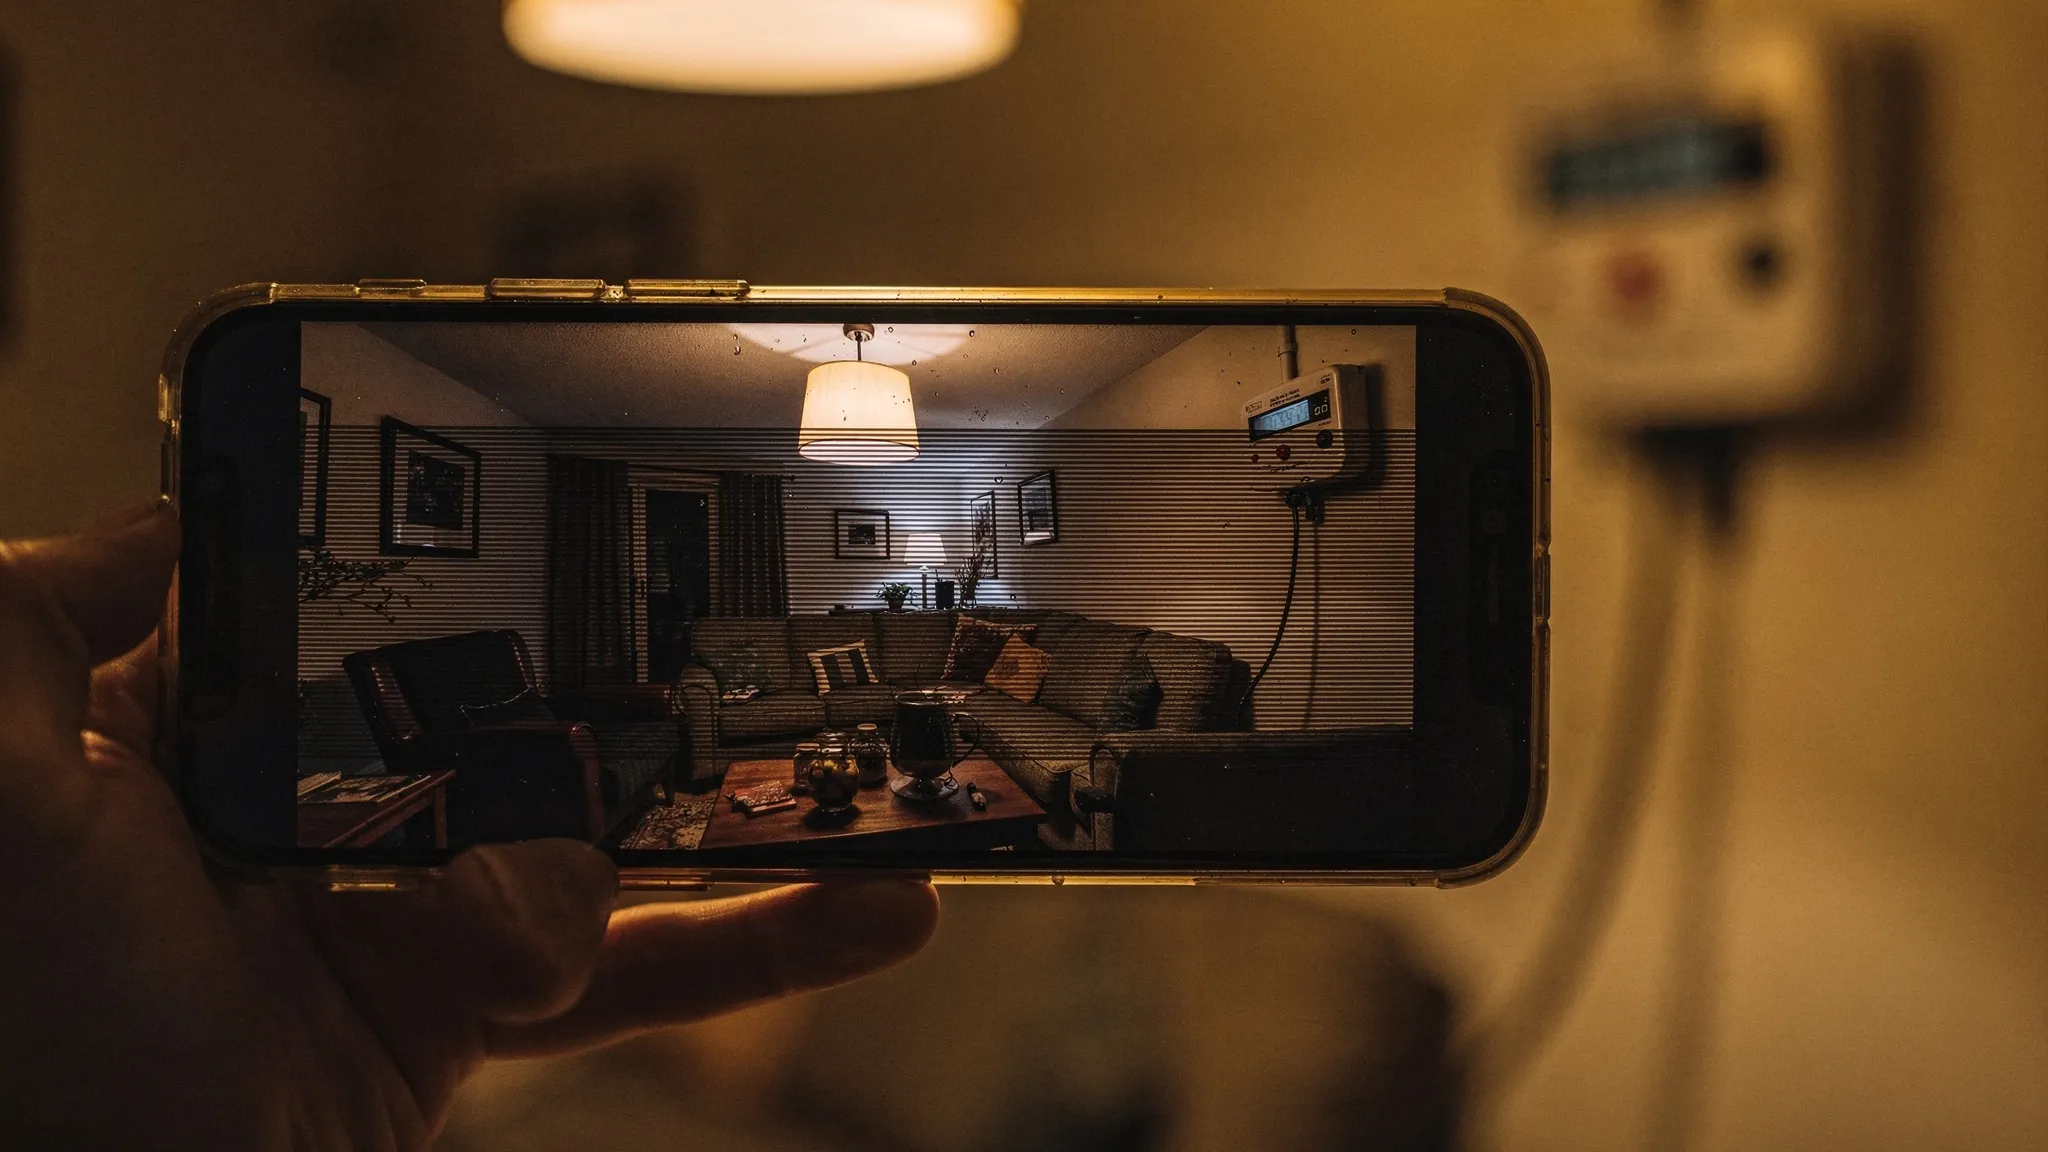
وزوز شبکهٔ برق، شاهدی علیه ویدیوهای هوش مصنوعی
تشخیص ویدیوهای ساختهٔ هوش مصنوعی به یک مسابقهٔ تسلیحاتی تبدیل شده است، و به گفتهٔ رایان وایتون (Ryan Wyton) و باچا رحمان (Bacha Rehman) از دانشگاه ساوتهمپتون سولنت، مسابقهای است که «آشکارساز در حال باختن آن است». بیشتر آشکارسازها اثر انگشتهای لودهندهٔ مولدهایی را یاد میگیرند که با آنها آموزش دیدهاند. در یک محک تازه با شش میلیون کلیپ، بهترینها روی هم رفته تنها به حدود 80٪ دقت میرسند و روی مولدهایی که هرگز ندیدهاند تا نزدیک سطح شانس یا پایینتر از آن سقوط میکنند.
این دو پژوهشگر به جای آن سراغ سیگنالی رفتند که مولدها کنترلش نمیکنند: فرکانس شبکهٔ برق (electric network frequency) یا ENF.
اثر انگشت شبکه
برق شهری بهطور اسمی 50 یا 60 هرتز است، اما فرکانس دقیقش با تغییر عرضه و تقاضا به مقدار اندکی جابهجا میشود. چون یک شبکهٔ برق بهشدت به هم پیوسته است، این جابهجایی در هر لحظه در سراسر شبکه، با اختلافی در حد چند میلیثانیه، یکسان است — پس مانند یک مهر زمانی عمل میکند. این سیگنال از دو راه وارد ضبطها میشود. میکروفونها آن را به شکل یک وزوز دریافت میکنند. و لامپهایی که از برق شهری تغذیه میشوند با دو برابر فرکانس شبکه، یعنی 100 یا 120 هرتز، سوسو میزنند. دوربینی که حسگرش تصویر را خط به خط میخواند («شاتر غلتان»، rolling shutter) این سوسو را به صورت نوارهایی کمرنگ در ویدیو ثبت میکند.
فرضی که دوام نیاورد
کار با ایدهای ساده آغاز شد: ویدیوی مصنوعی سوسوی شبکه نخواهد داشت و میتوان آن را از روی همین نبود شناسایی کرد. به نوشتهٔ نویسندگان، این ایده «در برخورد با شواهد دوام نیاورد». در 600 کلیپ از شش مولد متنبهویدیو، سوسو به همان قوت تصاویر واقعی ظاهر شد — با فرکانسی ظاهری که نرخ فریم مولد آن را تعیین میکرد، نه هیچ شبکهٔ واقعی. اگر فقط شدت سوسو سنجیده شود، کلیپهای واقعی و ساختگی از هم تمیز داده نمیشدند: امتیاز 0.51، که در آن 0.5 یعنی حدس محض.
پس پرسش عوض شد. سامانه به جای اینکه بپرسد آیا ویدیو سیگنال شبکه دارد، میپرسد آیا این سیگنال با ثبتی مستقل از شبکه در زمان و مکان ادعاشده جور درمیآید یا نه. ردی که جور درآید شاهد محکمی بر واقعی بودن ضبط است. نبودِ رد چیزی را ثابت نمیکند، زیرا بسیاری از ضبطهای واقعی — در فضای باز، در نور کم، یا با تجهیزات صوتی حرفهای — هیچ وزوز قابلاستفادهای ندارند.
سامانه چگونه کار میکند
- یک شبکهٔ عصبی کوچک (حدود 157,600 پارامتر) سیگنال شبکه را هم در صدا و هم در تصویر میخواند.
- نمونههای واقعیِ برچسبخورده کمیاباند، پس گروه آن را با نمونههای مصنوعی آموزش داد: آنها مدل کردند که فرکانس شبکه چگونه سرگردان میشود و به سمت مقدار اسمیاش بازکشیده میشود، سپس این جابهجایی را به گفتار بدون وزوز و ویدیوی بدون سوسو تزریق کردند، همراه با پنج نوع سیگنال ناسازگار (غایب، صاف، گسسته، شبکهٔ اشتباه، پیوندخورده).
- مرحلهای جداگانه سیگنال ضبط را با یک ثبت مرجع از شبکه مطابقت میدهد، یا برای بررسی زمانی ادعاشده یا برای یافتن زمانی ناشناخته.
- یک گراف تصمیم ثابت — بخش «عاملمحور» (agentic) — این را با آشکارسازهای موجود برای چهرههای دستکاریشده، همگامی لب و فراداده ترکیب میکند و آشکارسازهای کند را فقط وقتی فرا میخواند که بررسیهای سریع به نتیجه نرسند.
نتایج
- روی ضبطهای واقعی از منابعی که هرگز در آموزش دیده نشده بودند، سامانه 93٪ از صداهای واقعی و 100٪ از ویدیوهای واقعی را پذیرفت، در برابر 53٪ و 15٪ برای آزمون سادهٔ «آیا وزوزی هست؟».
- بررسی زمانِ ادعاشدهٔ ضبط، روی ضبطهایی که میشد ردی از آنها استخراج کرد، مهرهای زمانی واقعی را بینقص از جعلی جدا کرد؛ یک جستوجوی کور زمانِ ناشناختهٔ یک ضبط را تا حدود یک ثانیه در یک مرجع 24 ساعته پیدا کرد.
- در یک صحنهٔ واقعی، سوسوی ویدیو هم با مرجع شبکهاش و هم با صدای همان ضبط جور بود. دو بازسازی هوش مصنوعی از آن صحنه با 60 هرتز سوسو زدند؛ شبکهٔ اشتباه برای مکانی که ادعا میشود با 50 هرتز کار میکند.
- در میان 91 ضبط واقعی که با شبکهٔ واقعیشان سنجیده شدند، هیچ اتهام نادرستی وارد نکرد.
- اجرای آشکارسازهای کند فقط در صورت نیاز، زمان محاسبه را بدون از دست رفتن دقت 54٪ کاهش داد.
مورد دشوار
سیگنال شبکه ضبط را تأیید میکند، نه آنچه را نشان میدهد. اگر کسی از صحنهای واقعی فیلم بگیرد و سپس چهرهای را در آن جایگزین کند، وزوز واقعی میماند. این کار بر عهدهٔ آشکارسازهای چهره و همگامی لب است که روی تصاویر فشرده از جابهجاییهای واقعی چهره عملکردی نزدیک به شانس داشتند: کل مجموعه حدود 50٪ امتیاز گرفت. این روش همچنین به ثبتهای مرجع شبکه نیاز دارد که نویسندگان آنها را برای بریتانیا و اروپای قارهای عمومی، اما در جاهای دیگر محدود یا منتشرنشده توصیف میکنند، و نمیتواند جاعلی را متوقف کند که یک ضبط واقعی از شبکه در زمان و مکان درست را به میان آن پیوند بزند.
نویسندگان سامانهٔ خود را ابزاری برای غربالگری اولیه معرفی میکنند، یک رشته شاهد در کنار دیگر شواهد. به نوشتهٔ آنها، هدفش «اعلام جعلی بودن یک کلیپ نیست، بلکه گفتن این است، با اطمینانی سنجیده، که چه وقت یک ضبط همان است که ادعا میکند.»