SCHÄDELIMPLANTATE, DIE RICHTIG AUSSEHEN, ABER NICHT EINGESETZT WERDEN KÖNNEN
Nach einer dekompressiven Kraniektomie – einer Operation, bei der ein Teil des Schädels entfernt wird, um ein anschwellendes Gehirn zu entlasten –, einer Kopfverletzung oder der Entfernung eines Tumors, die Knochen mitnimmt, bleibt bei einem Patienten eine Öffnung im Schädel. Sie wird mit einem an die Anatomie dieses Patienten angepassten Implantat verschlossen, das das Gehirn schützen und die Form des Schädels wiederherstellen muss. Ob es passt, entscheidet sich im Operationssaal.
Diese Implantate werden noch immer von Fachleuten von Hand im computergestützten Design gezeichnet. Jeder Fall ist langsam und teuer, was begrenzt, wie viele Patienten eines bekommen können. Netze, die speziell für diese Aufgabe trainiert sind, schneiden in öffentlichen Benchmarks gut ab, brauchen dafür aber Trainingsdaten. Foundation-Modelle (Basismodelle) – große Modelle, die auf riesigen Sammlungen von 3D-Formen vortrainiert sind – versprechen, diesen Schritt zu überspringen: Ein Schädel mit einem Loch ist einfach eine zu vervollständigende Form.
Beurteilt wie von einem Chirurgen
Marek Wodzinski und Kollegen von der AGH-Universität Krakau und dem Sano Centre for Computational Medicine in Polen prüften drei öffentlich veröffentlichte Modelle, so wie sie geliefert werden:
- MSN-FM, das sich als erstes multimodales Foundation-Modell zur Vervollständigung medizinischer 3D-Punktwolken beschreibt – eine Form, die als Streuung von Punkten übergeben wird, ohne Oberfläche und ohne Inneres –, vortrainiert auf 100.000 medizinischen Formen und in der Lage, Text aufzunehmen;
- MGPC, trainiert auf einer Million Paaren, mit Text- und Bildeingaben;
- AdaPoinTr, trainiert auf 55 Kategorien von Alltagsgegenständen – keiner davon ein Schädel – als nichtmedizinische Kontrolle.
Sie nutzten 239 Schädel: 210 mit Löchern, die künstlich aus Scans vollständiger Schädel herausgeschnitten wurden, und 29 echte Fälle nach Kraniektomie mit dem Implantat, das ein Experte tatsächlich entworfen hatte. Bevor sie auch nur ein Modell laufen ließen, legten sie zwei Kriterien fest:
- Besser als nichts tun: Jedes Ergebnis wird damit verglichen, einfach den verbliebenen Knochen des Patienten zurückzugeben. Der entfernte Knochen ist eine dünne Schale neben dem Knochen, der bleibt, und die Bewertung zählt den fehlenden Bereich überall dort als abgedeckt, wo Material weniger als 2 mm von ihm entfernt liegt; schon die bloße Nähe zu den Rändern des Lochs bringt also umsonst Punkte.
- Physisch passen: Das vorhergesagte Material muss im Loch sitzen, ohne in den verbliebenen Knochen zu schneiden (Toleranz 1 Millimeter), und mindestens so viel abdecken wie das Nichtstun.
Als Maßstab bauten sie ein Modell, das genau für diese Aufgabe trainiert war, aus 138 Varianten nach seinem Ergebnis an genau diesen 210 Fällen ausgewählt, was es begünstigt – eine Obergrenze im besten Fall, kein fairer Konkurrent – und nur mit künstlichen Löchern trainiert, anders als die 29 echten Schädel –, und verbrachten die zweite Hälfte der Studie damit, ihre eigene Schlussfolgerung zu widerlegen.
Null von 239
- Bei den 210 künstlichen Löchern war keines besser als das Nichtstun. Gemessen als Anteil des fehlenden Bereichs, der auf 2 mm genau wiederhergestellt wird, war ihr medianer Vorteil gegenüber dem verbliebenen Knochen negativ: AdaPoinTr −0,036 (3,6 % des fehlenden Bereichs weniger als der Knochen allein), MGPC −0,130, MSN-FM −0,156. Das aufgabenspezifische Modell gewann +0,745.
- Medizinisches Vortraining half nicht: MSN-FM landete auf dem letzten Platz, hinter einem auf Alltagsgegenständen trainierten Modell.
- Bei den 29 echten Fällen war MGPC tatsächlich besser als das Nichtstun, bei 24 von 29 – das einzige Ergebnis jenseits des Zufalls. Die Autoren sagen, dass ein Modell, das bei künstlichen Löchern verliert, aber bei 29 echten Schädeln gewinnt, die klinische Frage nicht entscheidet.
- Einsetzbare Ergebnisse: 0 von 239 für jedes der drei Modelle, gegenüber 238 von 239 für das aufgabenspezifische Modell. Über 2.868 Kombinationen aus Modell, Einstellung und Schädel blieb keine bei 1 mm vom Knochen frei. Das Material der Modelle drang im Median 5,4 bis 6,6 mm in den eigenen Knochen des Patienten ein, gegenüber 0,55 mm beim aufgabenspezifischen Modell.
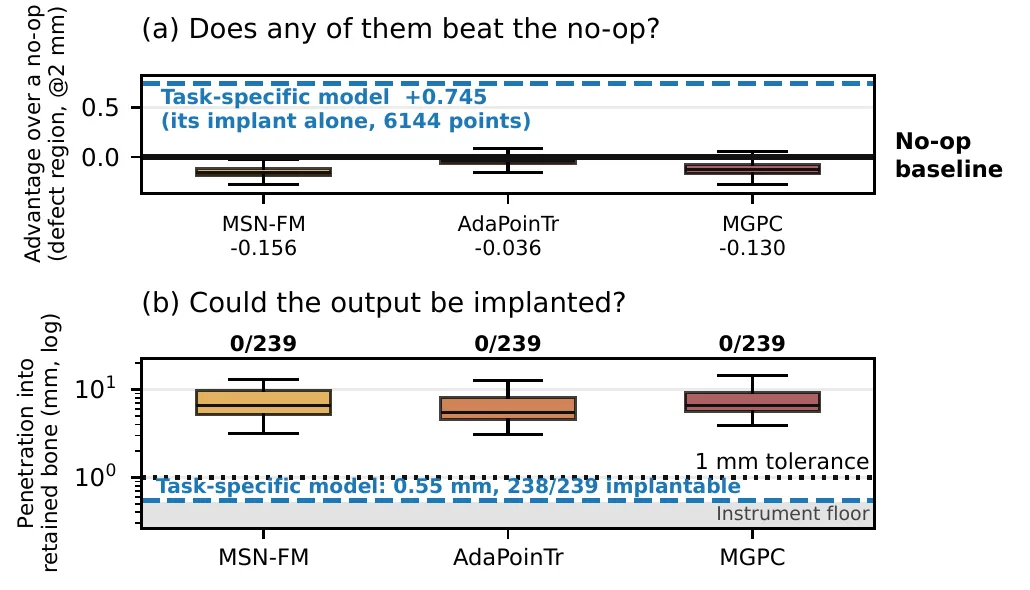
(a) Gewinn gegenüber dem Nichtstun: Die drei Modelle liegen unter null, das aufgabenspezifische Modell weit darüber. (b) Eindringtiefe in den verbliebenen Knochen, mit 0/239 einsetzbar für jedes. — Abbildung 1, Wodzinski et al. (2026), arXiv:2610.30035, CC BY-SA 4.0.
Die Kollisionen liegen in der Form der Ergebnisse, nicht in ihrer Platzierung: Sie zu verschieben änderte fast nichts.
Hübsch ist nicht einsetzbar
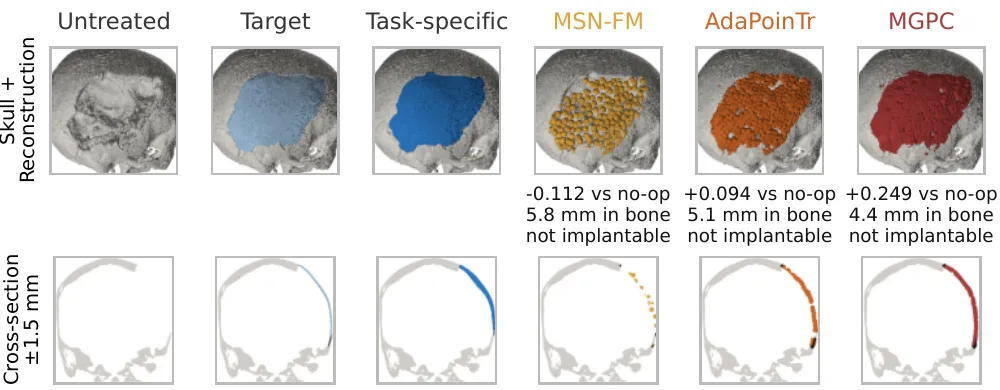
Ein echter Fall von außen und im Querschnitt. Die drei Modelle decken das Loch ab, aber alle dringen in Knochen ein, den der Patient noch hat. — Abbildung 2, Wodzinski et al. (2026), arXiv:2610.30035, CC BY-SA 4.0.
AdaPoinTr liefert eine saubere Oberfläche, die ein Betrachter als Schädel akzeptieren würde, und ist doch nicht besser einsetzbar als die anderen. Und die Dicke geht von Anfang an verloren: Bei 6.144 über einen Schädel verteilten Punkten liegen benachbarte Punkte im Mittel 2,56 mm auseinander, sodass sich die beiden Seiten einer 3-mm-Platte nicht unterscheiden lassen. Das ist eine Eigenschaft des Punktwolkenformats, nicht eines einzelnen Modells. Echte Implantate sind dünn: 11 der 29 waren dünner als 3 mm.
Die Texteingaben, mit denen diese Modelle werben, erwiesen sich als dekorativ. Bei MSN-FM sind 97,5 % des Textsignals genau null.
Ein Vertrauensproblem
„Betrachtet man die Bilder, haben die Modelle ihre Arbeit getan: Der Defekt ist bedeckt, der Kopf hat seine Form zurück“, schreiben die Autoren. Misst man dieselben Ergebnisse, kann keines in einen Patienten eingesetzt werden. Eine diffuse Wolke warnt einen; eine saubere Kappe, die unauffällig abschneidet und trotzdem in den Knochen schneidet, tut das nicht. Diese Ergebnisse von Hand, Schädel für Schädel, zu korrigieren, ist genau die Handarbeit, die die Modelle überflüssig machen sollten.
Ihr Fazit: So, wie sie veröffentlicht sind, „kann man“ den Foundation-Modellen zur Formvervollständigung, die sie beschaffen konnten, „nicht vertrauen“, und sie „sind in der klinischen Praxis nicht nutzbar“. Die Studie testete kein Nachtrainieren (fine-tuning) auf Schädeln, kein Kliniker begutachtete die Ergebnisse, und 29 echte Fälle können eine klinische Frage allein nicht entscheiden. Die Arbeit wurde bei einem Workshop der Konferenz ACCV 2026 angenommen.