یک جمله رانندگان هوش مصنوعی را در ترافیک گیر میاندازد
عاملهای هوش مصنوعی که بر چند مدل مشترک ساخته شدهاند، روزبهروز بیشتر از جانب انسانهای زیادی عمل میکنند. تاکاهیرو ازاکی، ناوتو ایمورا و کاتسوهیرو نیشیناری از دانشگاه توکیو میخواستند بدانند وقتی بسیاری از این عاملها یک پیام یکسان دریافت میکنند چه رخ میدهد — بهویژه پیشبینیای دربارهٔ اینکه دیگران چه خواهند کرد. چنین پیشبینیای همین که پخش شود، وضعیتی را که توصیف میکند تغییر میدهد و میتواند پیشبینی خودش را باطل کند.
برای آزمودن آن، یکی از سادهترین موقعیتهایی را برگزیدند که در آن مردم بر سر منبعی محدود رقابت میکنند: رفتوآمد روزانه.
دو جاده، یک قاعده
دو جادهٔ یکسان یک حومه را به یک منطقهٔ تجاری وصل میکنند. هر صبح همهٔ مسافران همزمان انتخاب میکنند. جادهای که سهم n/N از آنها از آن استفاده کنند 20 + 80 n/N دقیقه طول میکشد: اگر ترافیک بهطور مساوی تقسیم شود یک ساعت، و اگر تقریباً همه به یک جاده هجوم ببرند نزدیک به 100 دقیقه. در تقسیم مساوی، هیچکس نمیتواند با تغییر مسیرِ تنها سودی ببرد.
در آزمایش اصلی، هر یک از 50 عامل یک فراخوانی جداگانه از همان مدل، GPT-5.4-mini، است که بدون استدلال گسترده اجرا شده. هر عامل قواعد، جاده و زمانهای سفر خودش در پنج روز گذشته و یک گزارش روزانه را میبیند. هر پرامپت همچنین از عامل میخواهد فکر کند که رانندگان دیگر ممکن است به همان اطلاعات چه واکنشی نشان دهند. گزارش در چهار نسخه ارائه میشود:
- بدون هیچ گزارشی؛
- اعداد: زمان سفر دیروز در هر جاده؛
- یک توصیه: «مسیر B در حال حاضر خلوتتر است»؛
- توصیه بهعلاوهٔ هشدار: همان توصیه، به دنبالش «اما انتظار میرود بسیاری از رانندگان همین اطلاعات را ببینند و به مسیر B بروند، پس مسیر B ممکن است شلوغ شود.»
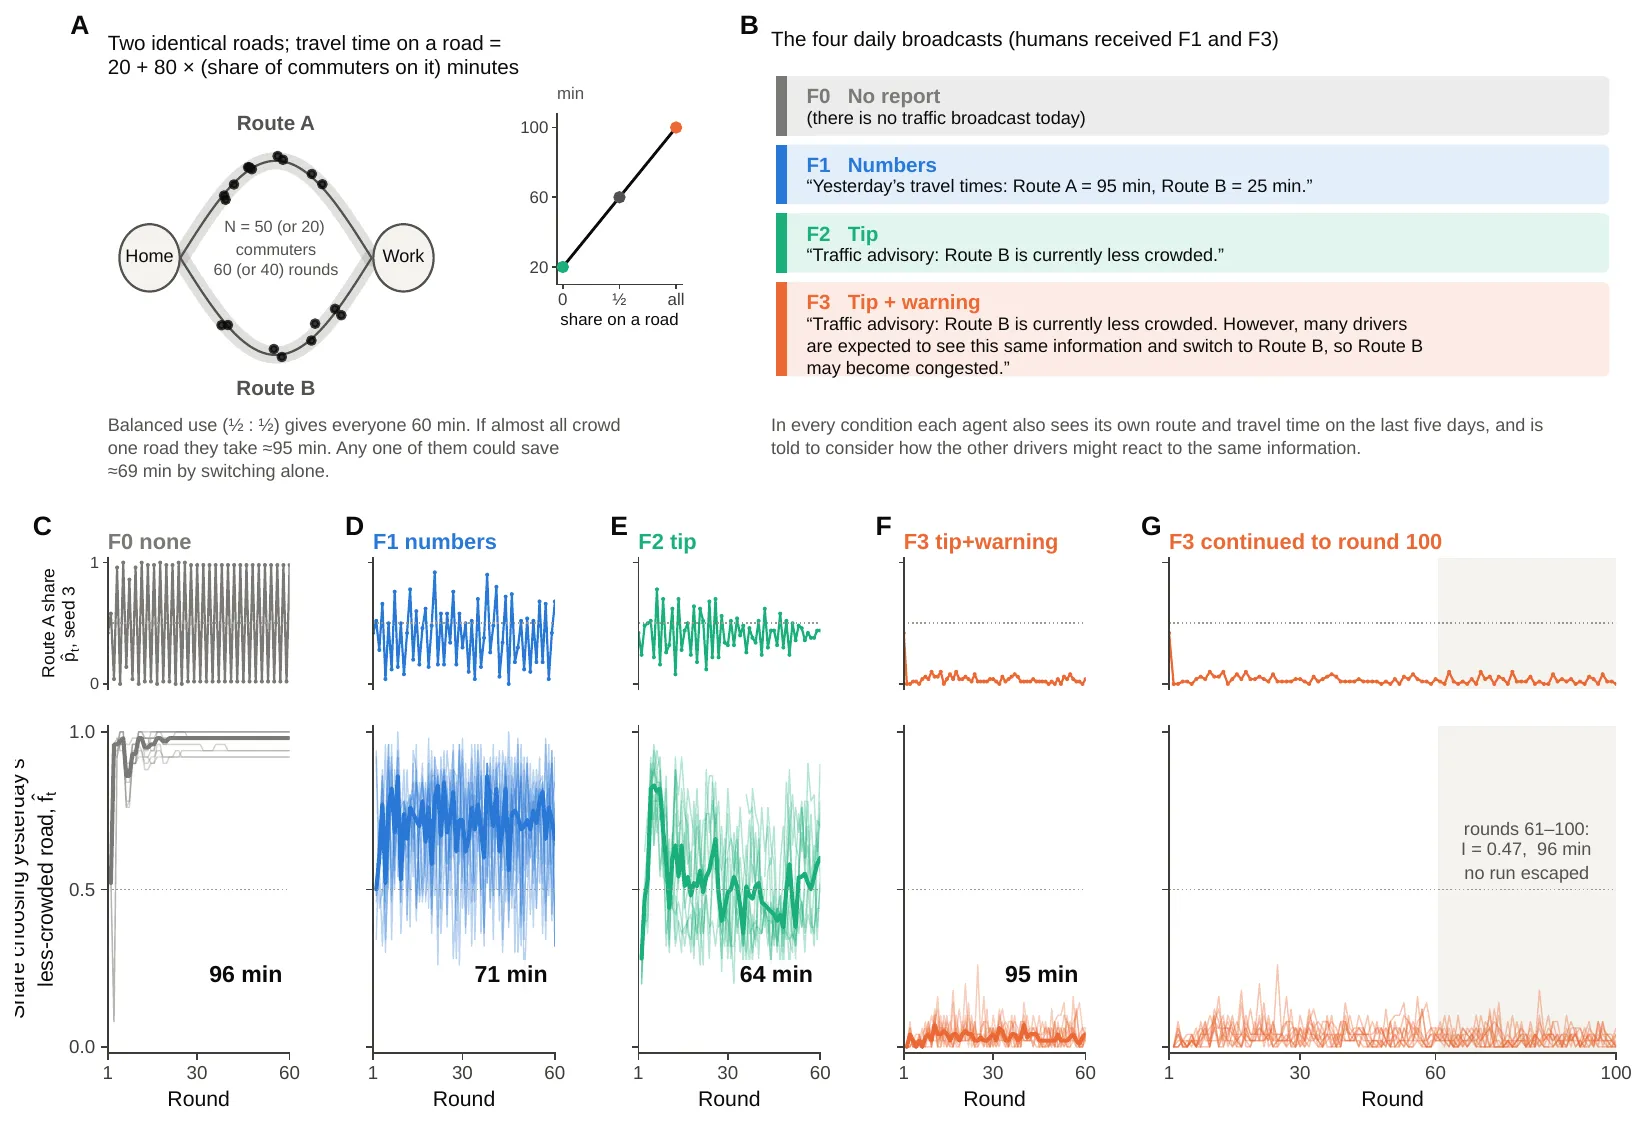
بازی و چهار گزارش (بالا)؛ پایین، برای هر گزارش، سهم عاملهایی که در طول 60 دور جادهٔ خلوتترِ دیروز را برگزیدند، همراه با میانهٔ زمان سفر. با هشدار، این سهم نزدیک صفر میماند، حتی وقتی بازی تا دور 100 ادامه مییابد. — شکل 1، Ezaki، Imura و Nishinari (2026)، arXiv:2609.30883.
هشداری که خودش را باطل میکند
بدون هیچ گزارشی، عاملها گلهوار حرکت کردند: تقریباً همه هر صبح مسیر عوض میکردند و جمعیت فقط از یک جاده به جادهٔ دیگر نوسان میکرد، با میانگین 96 دقیقه. اعداد این را به 71 دقیقه رساندند؛ توصیهٔ خالی بهترین نتیجه را داد: 64 دقیقه، نزدیک به ایدهآل 60 دقیقهای.
افزودن جملهٔ هشدار همهچیز را تغییر داد. حدود 96٪ عاملها در یک جاده — همان که تازه شلوغ بود — مستقر شدند و همانجا ماندند. میانگین زمان سفر به 95 دقیقه رسید، 30 دقیقه بیشتر از حالت توصیهٔ تنها، در هر ده اجرای جفتشده. در تقسیم 47 به 3، عاملی که در جادهٔ شلوغ است به 95.2 دقیقه نیاز دارد؛ تغییر مسیرِ تنها آن را به 26.4 دقیقه کاهش میداد. عاملها بهندرت چنین کردند. وقتی ده اجرا تا 100 دور ادامه یافت، هیچکدام رها نشد.
توضیحهای یکخطی خود عاملها این الگو را نشان میدهد. در یک اجرا، 89٪ آنها به تغییر مسیر یا ازدحام رانندگان دیگر اشاره کردند. نمونهای معمول: «A برای من مدام خیلی کند بوده، اما گزارش هشدار میدهد که B تغییرمسیردهندگان زیادی را جذب خواهد کرد، پس A گزینهٔ مطمئنتری است.» نویسندگان تأکید میکنند که این جملهها متن تولیدشده را توصیف میکنند، نه محاسبات درونی مدل را.
این راهبندان دائمی نبود. جایگزین کردن هشدار با اعداد ساده در دور 31، 96 تا 100٪ عاملها را به سوی جادهٔ تقریباً خالی روانه کرد — که برای مدتی کوتاه همان را بند آوردند — و سپس هزینهها دوباره به حدود 67 تا 74 دقیقه برگشت. هشدار دادن فقط به برخی عاملها هم کمک کرد: وقتی 5 عامل از 20 هشدار گرفتند و به بقیه اعداد داده شد، سفرها بهطور میانگین 65 دقیقه طول کشید، بهتر از اعداد بهتنهایی.
مدلهای دیگر، حدود دیگر
جهت این اثر به مدلهای دیگر هم منتقل شد، اما نه با تمام شدتش. Claude Haiku 4.5 و Gemini 3.5 Flash نیز با هشدار به سمت پرهیز از جادهٔ توصیهشده رفتند و حدود 3 و 5 دقیقه افزودند، اما هیچیک از اجراهایشان کاملاً منجمد نشد. GPT-5.4-mini با استدلال فعال هم همچنان به پرهیز گرایش داشت، بیآنکه منجمد شود. مدلی جدیدتر، GPT-6 Luna، در تنظیم پیشفرض استدلالش، حتی با توصیهٔ خالی هم منجمد شد. اینکه یک جمعیت قفل شود یا نه، به مدل و نحوهٔ اجرای آن بستگی دارد.
آدمها پخش میشوند — و جادهٔ آزاد را میگیرند
گروه این بازی را با 240 نفر که بهصورت آنلاین جذب شده بودند نیز اجرا کرد، در اتاقهای 20 نفره، با اعداد یا با هشدار. هر دوازده اتاق نزدیک به توازن ماندند، در حدود 62 دقیقه، نزدیک به نتیجهای که شیر یا خط تصادفی میداد. افراد با هم فرق داشتند: برخی پیوسته از توصیه پیروی میکردند، برخی پیوسته از آن پرهیز میکردند. نویسندگان هشدار میدهند که این مقایسه فقط جنبهٔ زمینهای دارد: پژوهشهای انسانی و هوش مصنوعی در زمانهای متفاوت و با مشوقهای متفاوت انجام شدند، و از آدمها خواسته نشده بود رفتار دیگران را پیشبینی کنند.
سپس نوبت اتاقهای مختلط رسید: 24 اتاق 20 صندلیای، با 5، 10 یا 15 عامل هوش مصنوعی، همه با هشدار، که با 240 نفر دیگر پر شدند. عاملها همچنان از جادهٔ توصیهشده پرهیز کردند. آدمها آن را گرفتند: بهطور میانگین 65٪، 83٪ و 91٪ مواقع — و در اتاقهای دارای 10 یا 15 عامل، هرچه جلسه پیشتر رفت بیشتر. در پایان، در هر هشت بلوک مقایسه، گروههایی که عامل بیشتری داشتند نامتوازنتر بودند.
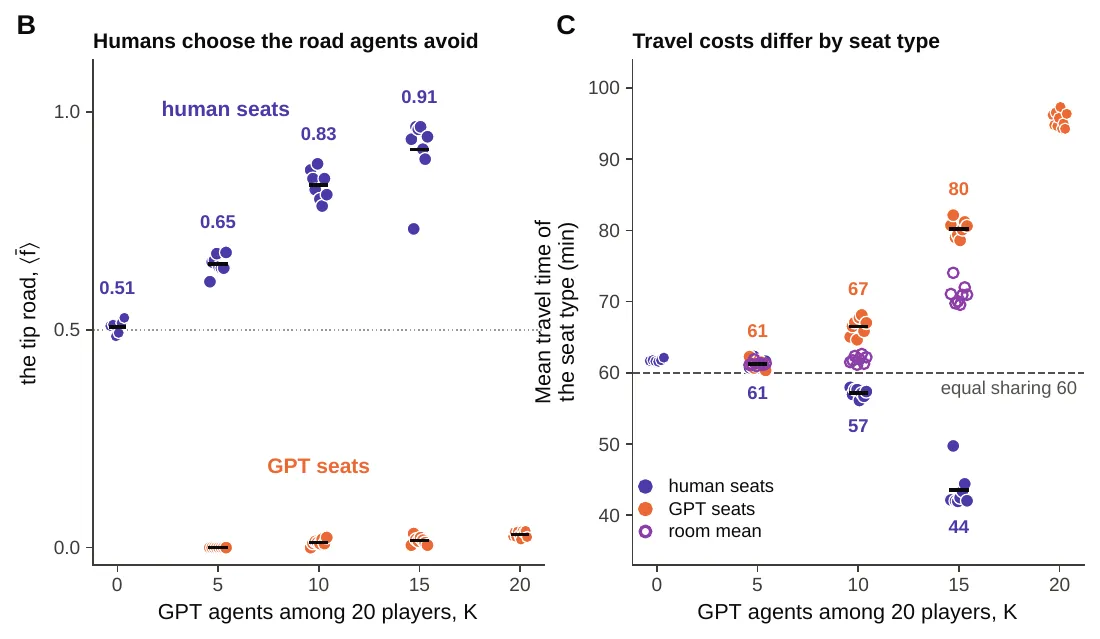
چپ: آدمها بیش از پیش جادهای را میگیرند که عاملها از آن پرهیز میکنند. راست: با 15 عامل، صندلیهای انسانی بهطور میانگین 44 دقیقه و صندلیهای هوش مصنوعی 80 دقیقه، در برابر 60 دقیقه در تقسیم برابر. — شکل 5 (B، C)، Ezaki، Imura و Nishinari (2026)، arXiv:2609.30883.
هزینهٔ راهبندان را چه کسی میپردازد
اتاقهای مختلط در مجموع بهتر از اتاقهایی بودند که فقط عامل داشتند — 71 دقیقه با 15 عامل، در برابر حدود 96. اما این میانگین نابرابریای را پنهان میکرد. با 15 عامل، صندلیهای انسانی بهطور میانگین 43.5 دقیقه بودند، بسیار کمتر از یک ساعتِ تقسیم منصفانه، در حالی که صندلیهای عامل بهطور میانگین 80.2 دقیقه بودند. از 240 شرکتکننده، 129 نفر نتیجهای بهتر از 60 دقیقه گرفتند؛ هیچ عاملی نگرفت. وقتی بعداً از شرکتکنندگان پرسیده شد، حدس زدند 63 تا 69٪ اتاقشان هوش مصنوعی بوده، چه سهم واقعی 25٪ بود، چه 50٪ و چه 75٪.
نویسندگان سه درس برای هر کسی که عاملهایی با منبع مشترک را ارزیابی میکند بیرون میکشند: کل جمعیتها را بیازمایید، نه یک عامل را در هر بار؛ هر پیام را یک مداخله در نظر بگیرید؛ و هزینهها را بر حسب نوع شرکتکننده گزارش کنید، نه فقط میانگین گروه. محدودیتهایشان را هم صریح بیان میکنند: یک بازی دو جادهای، پرامپتهایی که به پیشبینی دیگران دعوت میکنند، و اتاقهای مختلطی که ترکیبشان به ترتیب جذب شرکتکنندگان گره خورده بود. اگر عاملهای مردم در نهایت بار هزینهها را به دوش بکشند، سپردن کارها به آنها ممکن است همان جادهٔ کند از آب درآید.