ОДНА ФРАЗА ЗАПИРАЕТ ИИ-ВОДИТЕЛЕЙ В ПРОБКЕ
ИИ-агенты, построенные на горстке общих моделей, всё чаще действуют от имени множества людей. Такахиро Эзаки, Наото Имура и Кацухиро Нисинари из Токийского университета хотели узнать, что происходит, когда многие такие агенты получают одно и то же сообщение — особенно прогноз о том, что будут делать все остальные. Будучи разосланным, такой прогноз меняет ту самую ситуацию, которую описывает, и может опровергнуть сам себя.
Чтобы это проверить, они выбрали одну из простейших ситуаций, в которых люди соперничают за ограниченный ресурс: дорогу на работу.
Две дороги, одно правило
Две одинаковые дороги соединяют пригород с деловым районом. Каждое утро все водители выбирают одновременно. Дорога, которой пользуется доля n/N из них, занимает 20 + 80 n/N минут: час, если поток делится поровну, и около 100 минут, если почти все набиваются на одну дорогу. При равном разделении никто не выигрывает, перестроившись в одиночку.
В основном эксперименте каждый из 50 агентов — это отдельный вызов одной и той же модели, GPT-5.4-mini, работающей без расширенных рассуждений. Каждый агент видит правила, свою дорогу и время в пути за последние пять дней, а также ежедневную сводку. В каждом промпте агента также просят подумать, как другие водители могут отреагировать на ту же информацию. Сводка бывает в четырёх вариантах:
- никакой сводки;
- цифры: вчерашнее время в пути по каждой дороге;
- совет: «Маршрут B сейчас менее загружен»;
- совет плюс предупреждение: тот же совет, а затем «Однако ожидается, что многие водители увидят эту же информацию и перейдут на маршрут B, поэтому на маршруте B может возникнуть пробка».
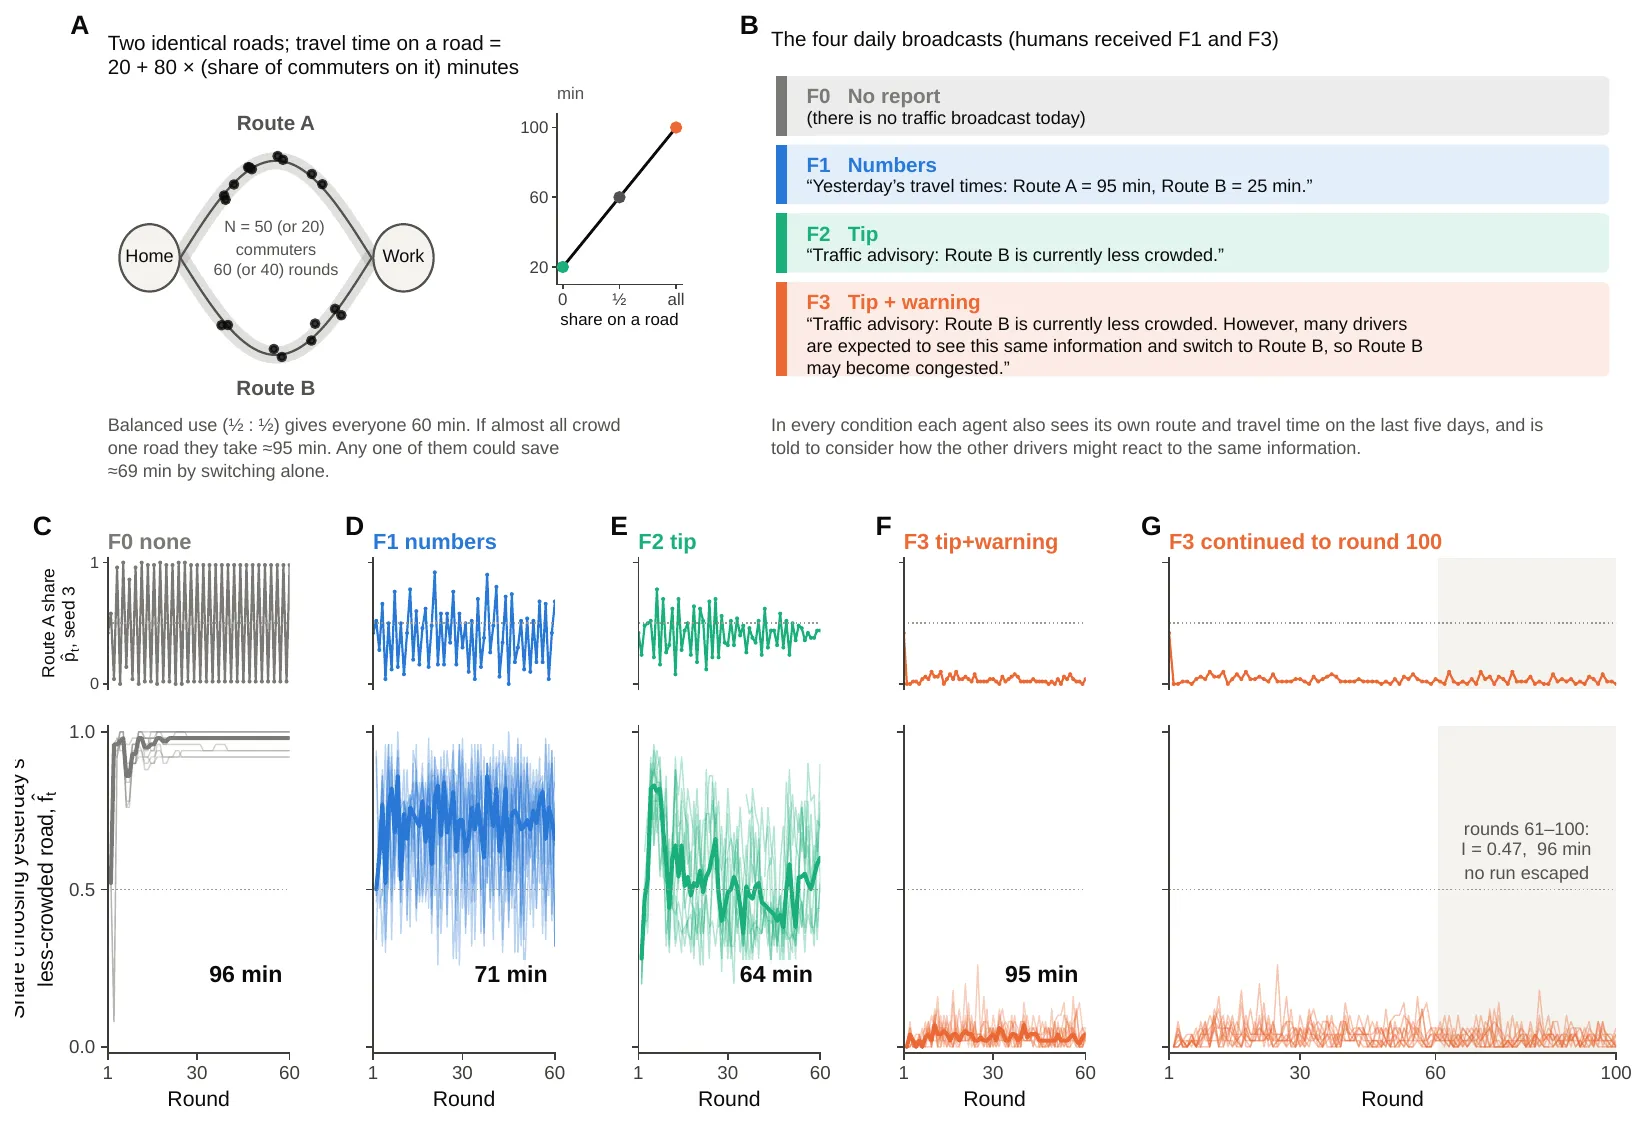
Игра и четыре варианта сводки (вверху); внизу для каждой сводки — доля агентов, выбирающих вчерашнюю менее загруженную дорогу, за 60 раундов, с медианным временем поездки. При предупреждении доля остаётся около нуля, даже когда игру продлевают до 100-го раунда. — Рисунок 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Предупреждение, которое опровергает само себя
Без сводки агенты двигались стадом: почти все каждое утро меняли дорогу, и толпа просто качалась с одной дороги на другую, в среднем 96 минут. Цифры снизили это до 71 минуты; лучше всего сработал один лишь совет — 64 минуты, близко к идеальным 60 минутам.
Добавление фразы-предупреждения изменило всё. Около 96% агентов обосновались на одной и той же дороге — той, что только что была забита, — и остались на ней. Среднее время поездки выросло до 95 минут, на 30 минут больше, чем при одном совете, во всех десяти парных прогонах. При раскладе 47 к 3 агенту на забитой дороге нужно 95,2 минуты; перейди он в одиночку — понадобилось бы 26,4 минуты. Агенты делали это редко. Когда десять прогонов продлили до 100 раундов, ни один не вырвался.
Собственные однострочные объяснения агентов показывают закономерность. В одном прогоне 89% из них упоминали других водителей, которые перестраиваются или создают толчею. Типичное: «A для меня всё время была очень медленной, но сводка предупреждает, что B привлечёт много перестраивающихся, так что A — более надёжный вариант». Авторы подчёркивают, что эти фразы описывают сгенерированный текст, а не внутренние вычисления модели.
Пробка не была вечной. Когда на 31-м раунде предупреждение заменили простыми цифрами, 96–100% агентов ринулись на почти пустую дорогу — ненадолго забив уже её, — после чего затраты вернулись примерно к 67–74 минутам. А предупреждение лишь части агентов помогло: когда предупреждены были 5 из 20 агентов, а остальные получали цифры, поездка занимала в среднем 65 минут — лучше, чем при одних цифрах.
Другие модели, другие пределы
Направление эффекта сохранилось, но не вся его сила. Claude Haiku 4.5 и Gemini 3.5 Flash под предупреждением тоже стали избегать рекомендованной дороги, прибавив около 3 и 5 минут, но ни один их прогон не застыл полностью. GPT-5.4-mini с включёнными рассуждениями по-прежнему склонялся к избеганию, не застывая. Более новая модель, GPT-6 Luna, при настройках рассуждений по умолчанию застывала даже при простом совете. Застрянет ли популяция, зависит от модели и от того, как её запускают.
Люди расходятся — и занимают свободную дорогу
Команда провела игру и с 240 людьми, набранными онлайн, в комнатах по 20 человек, с цифрами или с предупреждением. Все двенадцать комнат держались близко к равновесию, около 62 минут — примерно столько дало бы случайное подбрасывание монетки. Люди различались: одни последовательно следовали совету, другие последовательно его избегали. Авторы предупреждают, что это сравнение лишь контекстное: исследования с людьми и с ИИ проводились в разное время, с разными стимулами, и людей не просили предугадывать действия других.
Затем последовали смешанные комнаты: 24 комнаты по 20 мест с 5, 10 или 15 ИИ-агентами, все под предупреждением, остальные места заняли ещё 240 человек. Агенты продолжали избегать рекомендованной дороги. Люди её выбирали: в среднем в 65%, 83% и 91% случаев — а в комнатах с 10 или 15 агентами всё чаще по ходу сессии. В итоге группы с бо́льшим числом агентов оказывались более несбалансированными — во всех восьми блоках сравнения.
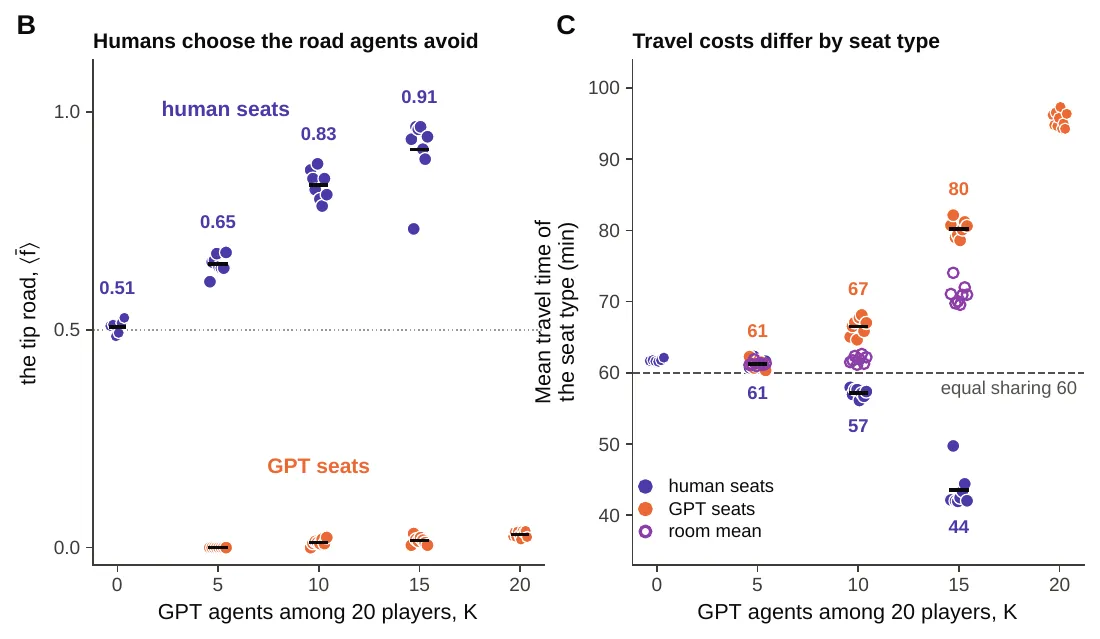
Слева: люди всё чаще выбирают дорогу, которой избегают агенты. Справа: при 15 агентах места людей тратят в среднем 44 минуты, а места ИИ — 80, против 60 при равном разделении. — Рисунок 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Кто платит за пробку
В целом смешанные комнаты справлялись лучше, чем комнаты из одних агентов, — 71 минута при 15 агентах против примерно 96. Но среднее скрывало перекос. При 15 агентах места людей тратили в среднем 43,5 минуты — намного меньше часа при справедливом разделении, — а места агентов в среднем 80,2. Из 240 участников 129 уложились быстрее чем в 60 минут; ни один агент этого не добился. На вопрос после игры участники предполагали, что ИИ составлял 63–69% их комнаты, — независимо от того, была ли реальная доля 25%, 50% или 75%.
Авторы выводят три урока для всех, кто оценивает агентов, делящих общий ресурс: тестировать целые популяции, а не по одному агенту; считать каждое сообщение вмешательством; и сообщать о затратах по типам участников, а не только среднее по группе. Ограничения тоже названы явно: игра с двумя дорогами, промпты, побуждающие к предугадыванию, и смешанные комнаты, состав которых был связан с порядком набора участников. Если издержки в итоге лягут на агентов, действующих от имени людей, поручать им дела может оказаться медленным путём.