一句话就让AI司机困在拥堵中
基于少数几个共享模型构建的AI智能体,正越来越多地代表众多人行事。东京大学的江崎贵裕(Takahiro Ezaki)、井村直人(Naoto Imura)和西成活裕(Katsuhiro Nishinari)想知道,当许多这样的智能体收到同一条信息——尤其是关于其他所有人将如何行动的预测——时,会发生什么。这样的预测一旦广播出去,就会改变它所描述的局面,甚至可能让自己的预言落空。
为了检验这一点,他们选择了人们争夺有限资源的最简单场景之一:通勤。
两条路,一条规则
两条完全相同的道路连接着一个郊区和一个商务区。每天早上,所有通勤者同时做出选择。一条被其中n/N比例的人使用的道路,通行时间为20 + 80 n/N分钟:如果车流平均分配,需要一小时;如果几乎所有人都挤到一条路上,则接近100分钟。在平均分配时,没有人能通过独自改道而获益。
在核心实验中,50个智能体中的每一个都是对同一模型GPT-5.4-mini的一次独立调用,且未开启扩展推理。每个智能体都能看到规则、自己过去五天所走的道路和通行时间,以及一条每日广播。每条提示词还要求智能体思考其他司机面对同样的信息可能会如何反应。广播有四个版本:
- 不发布任何报告;
- 数字:昨天每条路的通行时间;
- 一条建议:“B路目前较为通畅”;
- 建议加警告:同样的建议,后面再加一句“不过,预计许多司机都会看到同样的信息并改走B路,因此B路可能会拥堵。”
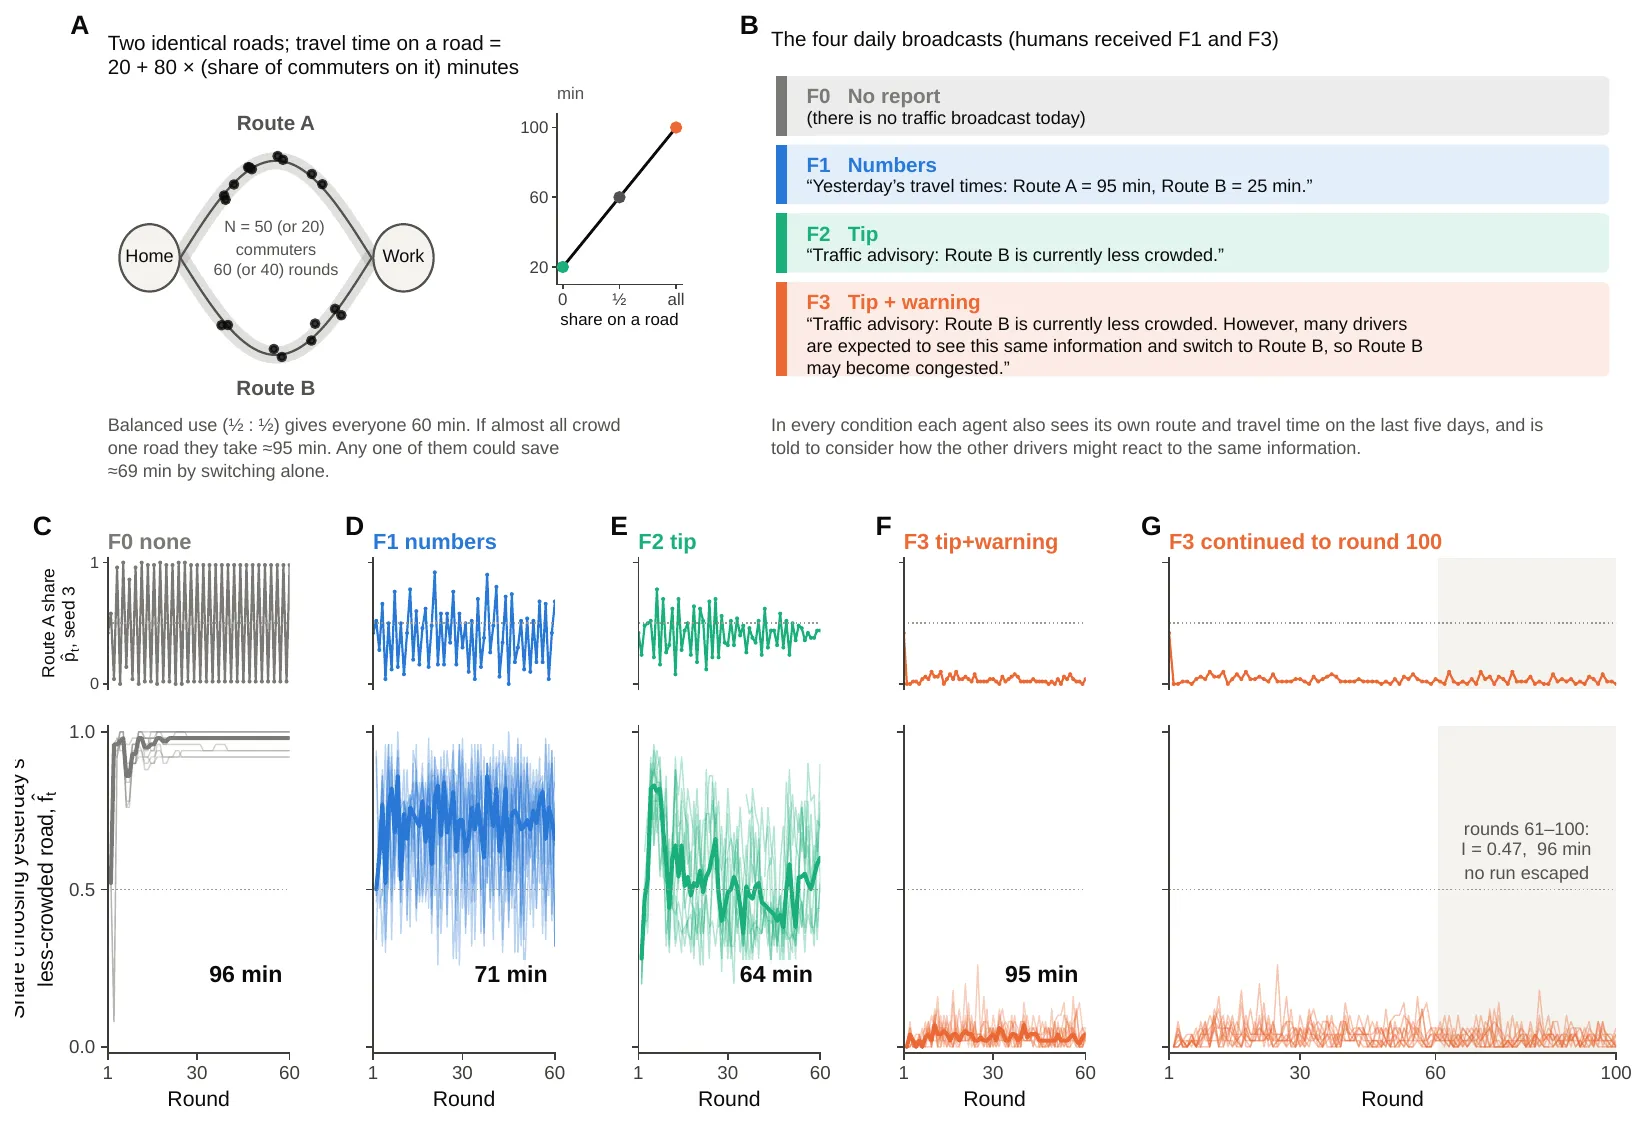
博弈规则和四种广播(上);下方为每种广播下,60轮中选择前一天较通畅道路的智能体比例,以及通行时间的中位数。在警告之下,这一比例始终接近于零,即使博弈延长到第100轮也是如此。——图1,Ezaki、Imura和Nishinari(2026),arXiv:2609.30883。
一条自我挫败的警告
在没有任何报告的情况下,智能体们像羊群一样行动:几乎所有智能体每天早上都会换路,于是车流只是在两条路之间来回摇摆,平均用时96分钟。提供数字后,用时降到71分钟;仅提供建议的效果最好,为64分钟,接近60分钟的理想值。
加上那句警告后,一切都变了。约96%的智能体停留在同一条路上——恰恰是刚刚拥堵的那条——而且一直不走。在全部十组配对实验中,平均通行时间升至95分钟,比只有建议时多出30分钟。在47比3的分配下,堵在路上的智能体需要95.2分钟;只要它独自改道,用时就能降到26.4分钟。但智能体们很少这样做。当这十组实验延长到100轮时,没有一组摆脱困境。
智能体自己给出的一句话解释揭示了这种模式。在一组实验中,89%的智能体提到了其他司机会改道或道路会拥堵。一个典型的说法是:“A路对我来说一直很慢,但广播警告B路会吸引很多改道的人,所以A路更稳妥。”作者强调,这些句子描述的是生成的文本,而不是模型的内部计算。
这种拥堵并非一成不变。在第31轮把警告换成单纯的数字后,96%至100%的智能体蜂拥冲向几乎空着的那条路——短暂地让它堵了起来——随后成本回落到约67至74分钟。只警告部分智能体也有帮助:在20个智能体中只警告5个、其余只看数字时,平均用时为65分钟,比只看数字的效果更好。
其他模型,其他局限
效应的方向在其他模型上依然成立,但强度不尽相同。在警告之下,Claude Haiku 4.5和Gemini 3.5 Flash也倾向于回避被推荐的道路,分别多花约3分钟和5分钟,但它们的实验都没有完全僵住。开启推理的GPT-5.4-mini仍然倾向于回避,但没有僵住。一个更新的模型GPT-6 Luna在默认推理设置下,即使只有建议也会僵住。一个群体是否会陷入僵局,取决于模型本身以及它的运行方式。
人类会分散开——并走上畅通的路
团队还招募了240名网上参与者,以20人一组进行同样的博弈,提供数字或警告。所有十二个组都保持在接近均衡的状态,约62分钟,接近随机抛硬币所能达到的结果。个体之间存在差异:有些人始终听从建议,另一些人则始终回避。作者提醒,这一比较仅供参考:人类实验和AI实验是在不同时间、以不同激励条件进行的,而且并未要求人们预判他人的行为。
接下来是混合组:24个20座的房间,分别有5、10或15个AI智能体,全部处于警告条件下,其余座位由另外240人填满。智能体们继续回避被推荐的道路,人类则走上了这条路:平均分别有65%、83%和91%的时间——而且在有10或15个智能体的房间里,随着实验进行,这一比例越来越高。最终,在全部八个比较区组中,智能体越多的组越不均衡。
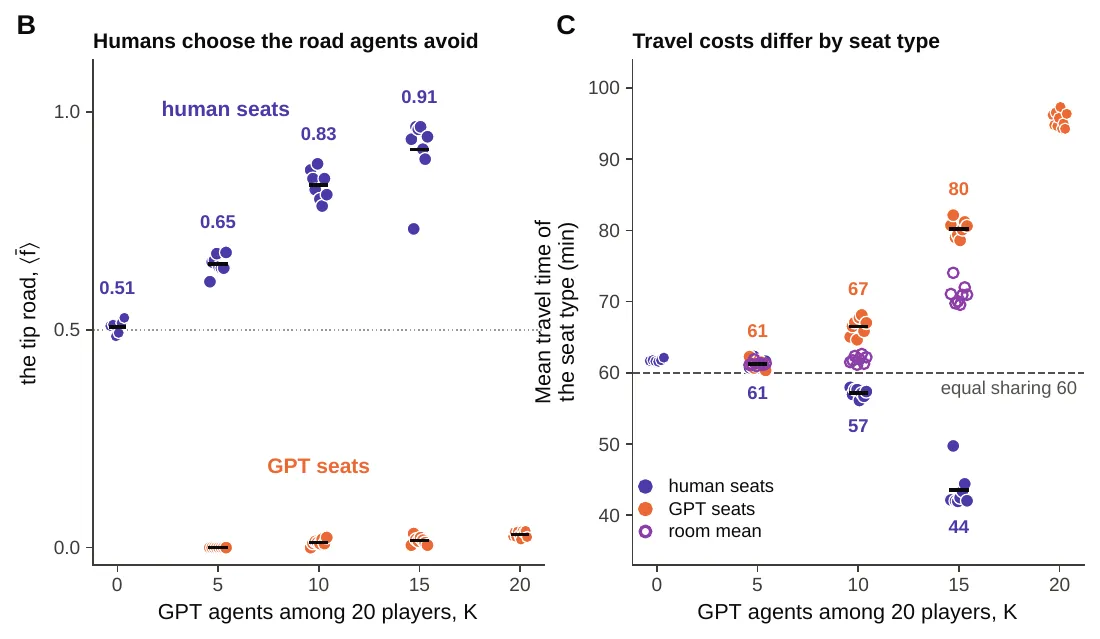
左:人类越来越多地走上智能体回避的道路。右:有15个智能体时,人类座位平均用时44分钟,AI座位为80分钟,而平均分配时为60分钟。——图5(B、C),Ezaki、Imura和Nishinari(2026),arXiv:2609.30883。
谁为拥堵买单
总体而言,混合组的表现优于纯智能体组——有15个智能体时为71分钟,而纯智能体组约为96分钟。但平均值掩盖了不平衡。有15个智能体时,人类座位平均用时43.5分钟,远低于公平分配下的一小时,而智能体座位平均为80.2分钟。在240名参与者中,有129人的用时少于60分钟;没有一个智能体做到。事后被问及时,无论实际比例是25%、50%还是75%,参与者都猜测自己房间里有63%至69%是AI。
作者为评估共享资源的智能体的人总结了三条经验:测试整个群体,而不是一次只测一个智能体;把每条信息都当作一次干预;按参与者类型报告成本,而不仅仅是群体平均值。他们也明确指出了局限:只是一个双路博弈,提示词会引导智能体去预判他人,而混合组的构成与招募顺序有关。如果人们的智能体最终承担了成本,那么把事情委托给它们,可能反倒是那条慢路。