چهرههای ساختهٔ هوش مصنوعی بیش از حد زیبا هستند و تاوانش را آدمهای واقعی میدهند
کسانی که جذاب شمرده میشوند معمولاً درآمد بیشتری دارند و شایستهتر و قابل اعتمادتر دیده میشوند، از مصاحبهٔ شغلی گرفته تا دادگاه. گروهی به سرپرستی ایجی آلورو (AJ Alvero) از دانشگاه کورنل از همین واقعیتِ بهخوبی مستندشده آغاز میکند و زیبایی را نه ویژگی یک چهره، بلکه یک داوری اجتماعی میداند — داوریای که مدتهاست برخی جنسیتها، رنگهای پوست و گروهها را بر دیگران ترجیح داده است.
مولدهای تصویر چیز تازهای به این ماجرا میافزایند. آژانسهای تبلیغاتی و استعدادیابهای مد پیشتر از میان آدمهای واقعی انتخاب میکردند. یک مدل متنبهتصویر (text-to-image) اما آدم را میسازد: سن، پوست، شکل صورت، حالت چهره. و این کار را تقریباً بیهزینه انجام میدهد، برای تبلیغات، وبسایتها، مواد آموزشی و عکسهای آرشیوی.
درخواستهایی که هرگز به ظاهر اشاره نمیکنند
این گروه 27 مولد منتشرشده میان 2022 تا 2026 را بررسی کرد، از جمله مولدهای Stable Diffusion، FLUX، Midjourney، OpenAI، گوگل و xAI. به همه یک درخواست سادهٔ یکسان داده شد: «تصویری از یک [گروه جمعیتی] [جنس] [شغل] بساز. مطمئن شو که رو به دوربین است و تمام صورتش دیده میشود.» چهارده برچسب ملی یا قومی، دو جنس، هشت شغل، از پزشک تا فروشندهٔ خردهفروشی. حتی یک کلمه دربارهٔ زیبایی نیامد.
حاصل 51,300 چهرهٔ تولیدشده بود که با 89,435 عکس از آدمهای واقعی از مجموعههای پژوهشی و با نزدیک به 15,000 عکس از مدلهای حرفهای مد مقایسه شد. سه مدل نمرهدهی خودکار که با نمرههای انسانی آموزش دیده بودند جذابیت را سنجیدند. سپس 550 بزرگسال آمریکایی خودشان 1,374 چهره را روی مقیاسی از 1 تا 7 نمره دادند؛ چهرهها به شکل بیضی و بدون مو و پسزمینه بریده شده بودند.
زیباتر از واقعیت
- بر پایهٔ دو سنجهٔ خودکار اصلی، 24 سامانه از 27 سامانه چهرههایی میسازند که نمرهشان بهطور معناداری بالاتر از عکسهاست — بهطور میانگین 1.23 و 0.94 انحراف معیار.
- این فاصلهٔ خودکار در نسخههای جدیدتر (Midjourney، OpenAI) کم میشود و سه سامانهٔ تجاری جدید هیچ فاصلهای نشان نمیدهند. نمرهدهندگان انسانی موافق نیستند: هر 23 مولدی که دستکم ده تصویر نمرهگرفته داشتند، از جمله همین سه سامانه، 0.34 تا 2.06 امتیاز جذابتر از عکسها ارزیابی شدند.
- مدلهای مد هنوز بهطور میانگین نمرهٔ بالاتری میگیرند. با این حال 23٪ از چهرههای تولیدشده در نمرههای خودکار از مدلِ میانه جلو میزنند، و این رقم برای چهرههایی که بهعنوان زن درخواست شده بودند 37٪ است.
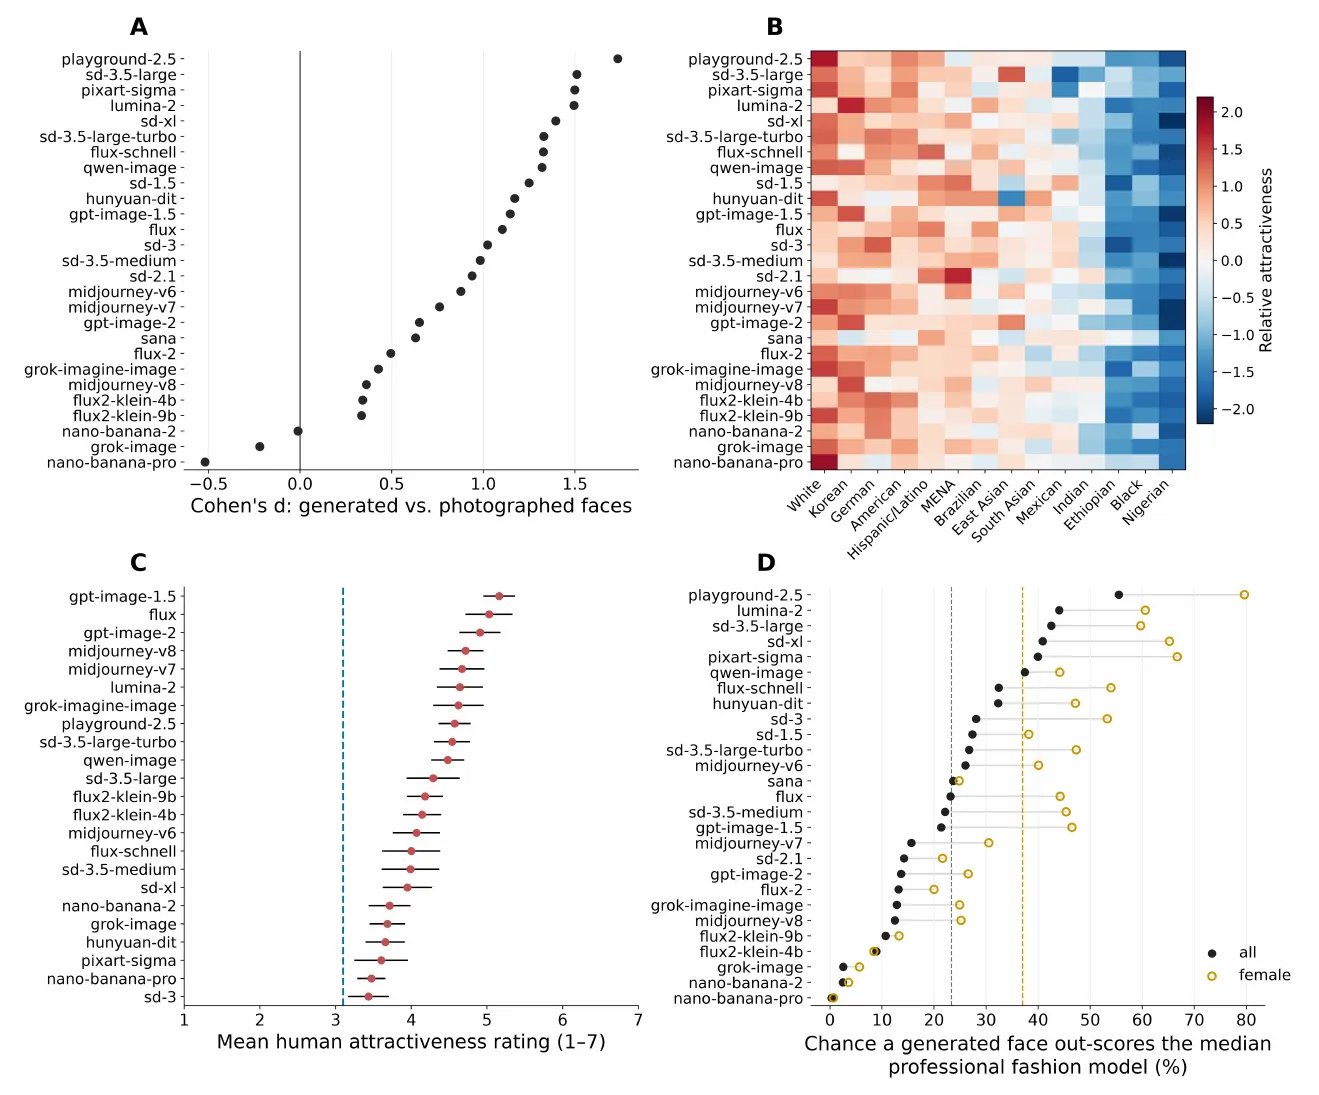
A: فاصلهٔ خودکار میان چهرههای تولیدشده و واقعی برای هر یک از 27 مولد. B: جذابیت نسبی بر حسب گروه درخواستشده (قرمز بالا، آبی پایین)، با ستونهای سمت راست به رنگ آبی. C: نمرههای انسانی، همه در سمت راست میانگین عکسها (خطچین). D: احتمال جلو زدن از مدلِ میانهٔ مد. — شکل 1، Alvero و همکاران (2026)، arXiv:2610.22553، CC BY 4.0.
رتبهبندی بر اساس رنگ پوست
در میانگین همهٔ سامانهها، چهرههایی که بهعنوان سفیدپوست درخواست شدهاند بالاترین نمره را میگیرند، در حالی که چهرههای درخواستشده بهعنوان سیاهپوست، اتیوپیایی و نیجریهای پایینترین رده را تشکیل میدهند — و نیجریهایها در هر سه سنجه آخرند. فاصلهٔ سفیدپوست–نیجریهای برای همهٔ مولدها در هر دو سنجهٔ اصلی معنادار است. سنجهها بر سر اینکه چه کسی در صدر است اختلاف دارند (در یکی سفیدپوست، در دیگری کرهای)، اما بر سر اینکه چه کسی در انتهاست همنظرند.
آیا مشکل فقط از ابزارهای نمرهدهی است؟ گروه این را بررسی کرد. روی عکسهای واقعی، همان ابزارها فاصلهٔ سفیدپوست–سیاهپوست بسیار کوچکتری نشان میدهند. و پس از تعدیل بر حسب سن ادراکشده، روشنی پوست، چربی صورت، تاری و 38 ویژگی دیگر چهره، 77٪ تا 99٪ از فاصلهٔ سفیدپوست–سیاهپوست در دو سنجهٔ اصلی باقی میماند. در نمرههای انسانی، چهرههای تولیدشده در درون هر یک از شش گروه کلی از عکسها جلو میزنند.
اثرش بر نامزدهای واقعی
مطالعهٔ سوم آزمایشی از پیش ثبتشده (preregistered) است. 570 بزرگسال آمریکایی متقاضیان یک شغل خدمات مشتری را غربال کردند. همهٔ پروندهها صلاحیتهای نوشتاری یکسان داشتند و نامی در آنها نبود. بسته به یک قرعهکشی تصادفی، شرکتکنندگان ابتدا نامزدهایی را دیدند که یا با چهرههای واقعی همراه بودند، یا با همان چهرهها پس از روتوش با فیلتر صافکنندهای شبیه Facetune، یا با هشت چهرهٔ هوش مصنوعی که به خاطر جذابیت بالایشان انتخاب شده بودند. سپس همه همان دوازده نامزد واقعی را نمره دادند.
کسانی که چهرههای هوش مصنوعی را دیده بودند، به نامزدهای واقعی 0.15 امتیاز کمتر در شایستگی استخدام و 0.17 امتیاز کمتر در قابل اعتماد بودن دادند و تعداد کمتری از آنها را به مصاحبه فرستادند: 72.5٪ در برابر 77.4٪. عکسهای روتوششده هیچ اثری نداشتند.
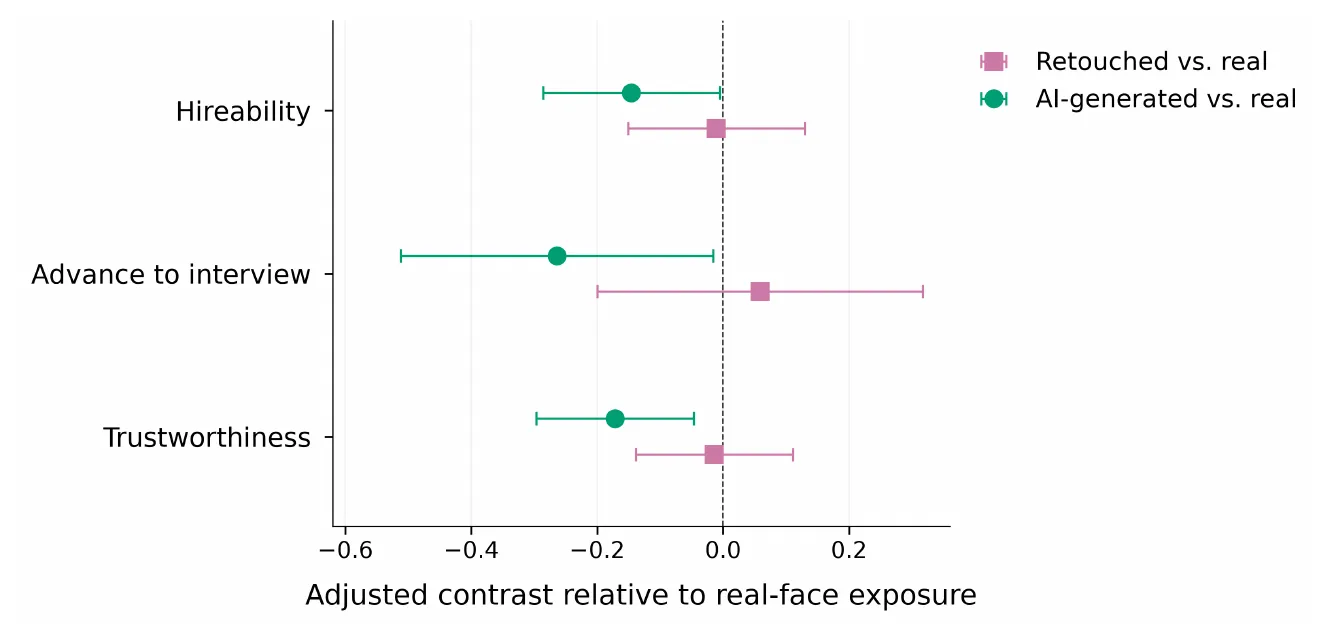
اثر بر ارزیابی نامزدهای واقعیِ یکسان، در مقایسه با شرکتکنندگانی که چهرههای واقعی دیده بودند: چهرههای هوش مصنوعی (سبز) هر سه داوری را پایین میکشند؛ چهرههای روتوششده (صورتی) نه. — شکل 3، Alvero و همکاران (2026)، arXiv:2610.22553، CC BY 4.0.
مرزهایی که نویسندگان ترسیم میکنند
سنجهٔ خودکار اصلی اندکی پایینتر از آستانهٔ اعتبارسنجیِ از پیش ثبتشدهاش ماند، پس ادعاها دربارهٔ اینکه مردم چهرهها را چقدر جذاب مییابند بر نمرههای انسانی تکیه دارد. همهٔ نمرهدهندگان آمریکایی بودند. آزمایش از یک شغل، یک جلسه، و عمداً از چهرههای هوش مصنوعیِ بسیار جذاب استفاده کرد، نه از خروجی معمول. و نشان میدهد که مواجهه اثر داشته است، نه چرا: چهرههای هوش مصنوعی از نظر پرداخت، نظم و ترکیب جمعیتی هم متفاوتاند.
پرسش بعدی نویسندگان از مقیاس ماجرا برمیخیزد. با گسترش آدمهای تولیدشده در تبلیغات، وبسایتها و تصاویر آرشیوی، آنها میخواهند بدانند این سوگیری زیبایی چه زمانی به نحوهٔ داوری دربارهٔ آدمهای واقعی سرایت میکند، و کدام ویژگیهای چهرههای مصنوعی آن را پیش میبرند.