隠れたAI訓練を見抜く電力計
人工知能を統治するための協定は、いつの日か、訓練できるモデルの大きさを制限するかもしれない。その履行を確保するには、監視対象の計算クラスターがモデルを訓練しているかどうかを、運営者が隠そうとしている場合でも見分けられる外部の検証者が必要になる。
確認の方法の多くは信頼を必要とする。チップ上に残されるログ、チップ間のネットワークの盗聴、スタッフへの聞き取り、内部告発者。どれも、運営者が管理するハードウェアか運営者側の人間に頼っている。チップの外にある物理センサーはそうではない。施設の入力ケーブルにクランプで取りつける電力計なら、既存のデータセンターに後付けでき、改ざんできないよう封印することもできる。
以前の研究で、訓練が電力に痕跡を残すことは示されていた。しかしそうした研究は、1枚の基板に当てたプローブで毎秒数百万回サンプリングするか、チップ自身の遠隔測定データを使っていた。現実的な計器はラック(サーバーを収める棚)や施設のレベルに置かれ、約100万倍遅く、しかも信号をならして薄める電源装置の向こう側にある。
訓練の鼓動
メルボルン大学とMATSプログラムのTom Kimpson、オックスフォード大学のMauricio Baker、MATSのEmlyn Grahamは、単純な事実から出発する。多数のチップが一緒にモデルを訓練するとき、各ステップは高電力の計算フェーズと、チップが結果を交換する低電力のフェーズを交互に繰り返す。これがおよそ1秒に1回起こり、施設の電力のスペクトルに細い線を描く。プリズムが光を分けるように電力の信号をリズムごとに分解すると、1秒に1回の拍は、ある一つの周波数に立つ鋭いピークとして現れるのだ。
その線を見つけるのは、思うより難しい。実際の訓練は完璧な拍子を刻むわけではない。遅い部品、過熱するチップ、温度の変化がリズムをさまよわせる。そして運営者が意図的にリズムをさまよわせたり、ぼかしたりすることもできる。
そこでチームは、パッシブソナーと連続重力波の探索から道具を借りてきた。スペクトログラム(どのリズムがその時々に含まれているかを示す地図)の中をゆっくりずれていくかすかな線を追いかけるビタビ追跡器(Viterbi tracker)である。
シミュレーションのデータセンターで試す
実際の訓練施設の電力データは公開されていない。そこで著者たちは、電力網の安定のために使われている訓練電力の既発表モデルをもとに、施設のモデルを組み立てた。主となる訓練に、背景で走る小さなジョブが加わる。もう一つの「潔白な」シナリオでは、主となる訓練を申告済みの推論――モデルの回答を利用者に提供すること――に置き換える。著者たちは、検定をより難しくするために、この推論をわざと雑音の多いものにした。
隠そうとまったくしない運営者に対しては、追跡器は5分間の窓で訓練の**少なくとも96%**を検出し、**誤警報は1%**で、どんな検定でも理論上達成しうる最良値を下回るのは、最大でも4パーセントポイントだった。一つの固定周波数の線を探す古典的な検定は、リズムがずれ始めたとたんに崩れてしまう。
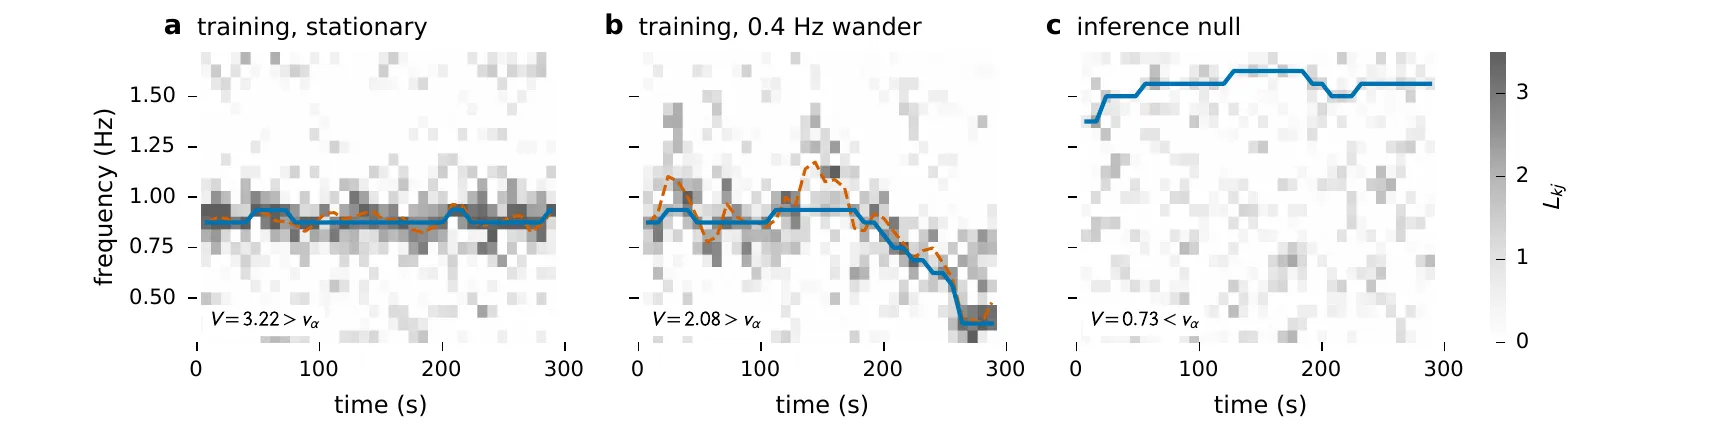
3つの5分間の記録上の追跡器(青):一定の訓練(a)、リズムが0.4 Hz、つまり1秒あたり0.4拍さまよう訓練(b、破線は真のリズム)、そして推論(c)。推論では追跡器は雑音をつなぎ合わせるだけで、検出しきい値を下回ったままだ。— Figure 4, Kimpson et al. (2026), arXiv:2610.30182.
計器は高級である必要はない。少なくとも1秒に2回サンプリングし、0.5秒以内で平均し、電源装置がリズムを深くまでろ過しすぎないことが条件だ。
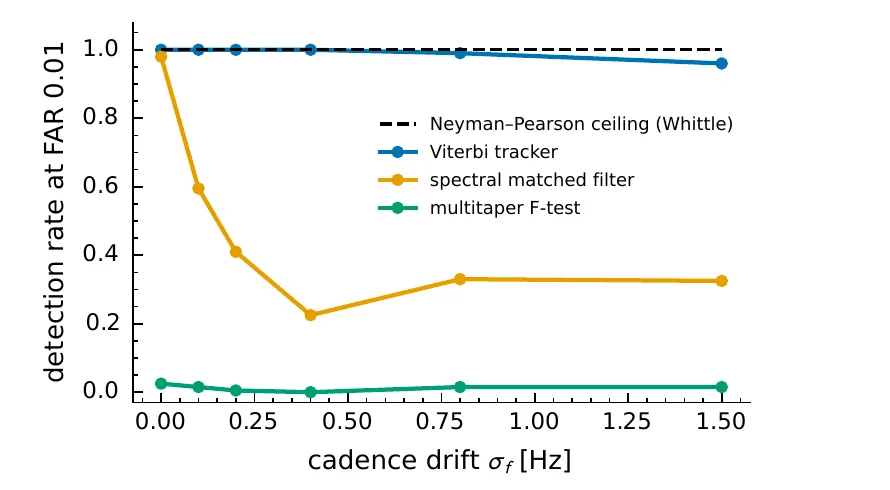
訓練リズムがずれるときの、誤警報1%での検出率:追跡器(青)は理論上の上限(破線)の近くにとどまる。— Figure 5, Kimpson et al. (2026), arXiv:2610.30182.
隠れることの代償
次にチームは、ずるをする側を演じた。8通りの隠し方を試した。ランダムなアイドル時間を加える、リズムをずらす、各ステップの形を変える、訓練を他のジョブの中に薄める、などである。固定周波数の検定に対しては、その大半が功を奏した。追跡器に対しては、ほとんど効かなかった。追跡器は、試した46の設定のうち43で訓練の少なくとも95%を捕らえた。
本当に効いたのは一つの方法だけだった。各ステップの作業量を変えることである。その最も強い形は、速度を犠牲にすることなく、5分間の窓の最大73%で訓練を隠した。だが、別の代償がある。小規模な実際の訓練――1枚のA100チップ上の3,000万パラメータの言語モデル――では、同じ品質に達するのに、変種によって93%から267%多くの計算が必要になった。
そして時間はずるをする側に不利に働く。誤警報率を1回の訓練あたり0.1%として丸1日監視すると、検証者はこの最良の手口を使った訓練の**87%**を捕らえ、44%は最初の1時間以内に見つかった。逃れたのはおよそ7件に1件だった。
次は実物の計器で
著者たちは明確な限界を挙げている。記録はすべて合成されたものである。実際の多数チップ施設での試験は計画されているが、まだ持っていない装置が必要だ。計器が検出するのは規則的なリズムであって、訓練そのものではない。ほかの周期的なジョブや、チップ自身の電力管理ループが反応を引き起こすこともありうる。また、チップと計器の間に十分大きなエネルギー貯蔵があれば信号を平らにできてしまう――もっとも、その場合は検証者がチップにより近い位置に2台目の計器を置けばよい。