能揪出秘密人工智能训练的电表
治理人工智能的协议或许有一天会限制可训练模型的规模。要执行这类协议,就需要一个外部核查方,能够判断受监控的计算集群是否在训练模型——即使运营方试图隐瞒。
大多数核查方式都需要信任:芯片上保存的日志、芯片之间网络上的监听、对员工的访谈、举报人。这些方式全都依赖运营方控制的硬件或运营方的人员。而芯片之外的物理传感器则不然。夹在设施进线电缆上的电表可以加装到现有的数据中心,并加封以防篡改。
早先的研究表明,训练会在功率上留下痕迹。但那些研究使用的是单块电路板上的探头,每秒采样数百万次,或者用的是芯片自身的遥测数据。一个现实的电表会装在机架(服务器机柜)或设施层面,采样速度慢约一百万倍,而且位于电源之后,电源会平滑并稀释信号。
训练的心跳
墨尔本大学和MATS项目的汤姆·金普森(Tom Kimpson)、牛津大学的毛里西奥·贝克(Mauricio Baker)以及MATS的埃姆林·格雷厄姆(Emlyn Graham)从一个简单的事实出发。当许多芯片一起训练一个模型时,每一步都在高功率计算阶段与低功率阶段之间交替,在低功率阶段芯片相互交换结果。这大约每秒发生一次,并在设施功率的频谱中画出一条窄窄的谱线——把功率信号按节奏分解开来,就像棱镜把光分解开一样,每秒一次的节拍就会在某个单一频率上显现为一个尖锐的峰。
发现这条谱线比听起来要难。真实的训练并不严格守时:慢速部件、过热的芯片和温度变化都会让节奏飘移。运营方也可以故意让它飘移,或把它抹平。
于是团队从被动声呐和连续引力波搜寻中借来了一件工具:维特比追踪器(Viterbi tracker),它能在频谱图(一张逐时显示存在哪些节奏的图)中跟随一条缓慢漂移的微弱谱线。
在模拟数据中心上测试
目前没有来自真实训练设施的公开功率数据,因此作者构建了一个这样的设施模型,其基础是一个已发表的、用于电网稳定性研究的训练功率模型:一个主训练任务,加上后台一些较小的作业。作为对照的“清白”情景则用申报的推理——向用户提供模型的回答——取代主训练任务;为了加大检验难度,作者有意让这种推理充满噪声。
面对一个毫不掩饰的运营方,追踪器在五分钟窗口内能检测出**至少96%**的训练任务,误报率为1%,比理论上任何检验所能达到的最佳水平最多低4个百分点。在单一固定频率上寻找谱线的经典检验,一旦节奏发生漂移便会失效。
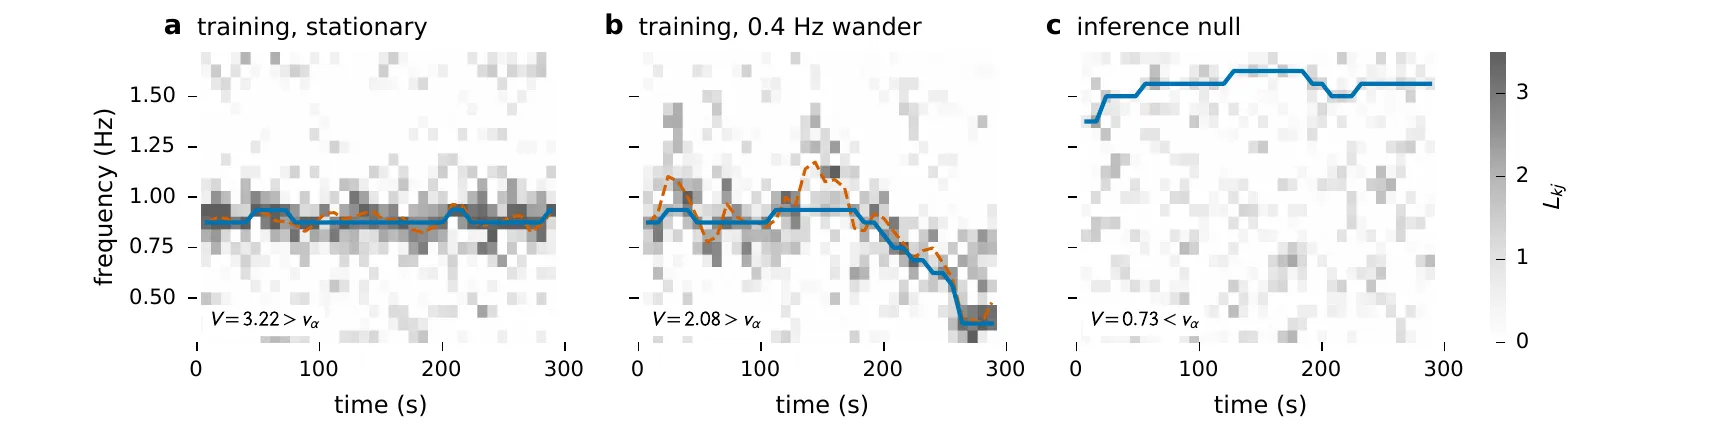
追踪器(蓝色)在三段五分钟记录上的表现:稳定的训练(a),节奏漂移0.4 Hz(即每秒0.4拍)的训练(b;虚线为真实节奏),以及推理(c),此时它只是把噪声串在一起,始终低于检测阈值。——图4,Kimpson 等(2026),arXiv:2610.30182。
电表不需要多么精密:它必须每秒至少采样两次,平均时间不超过半秒,而且电源不能把节奏滤除得太厉害。
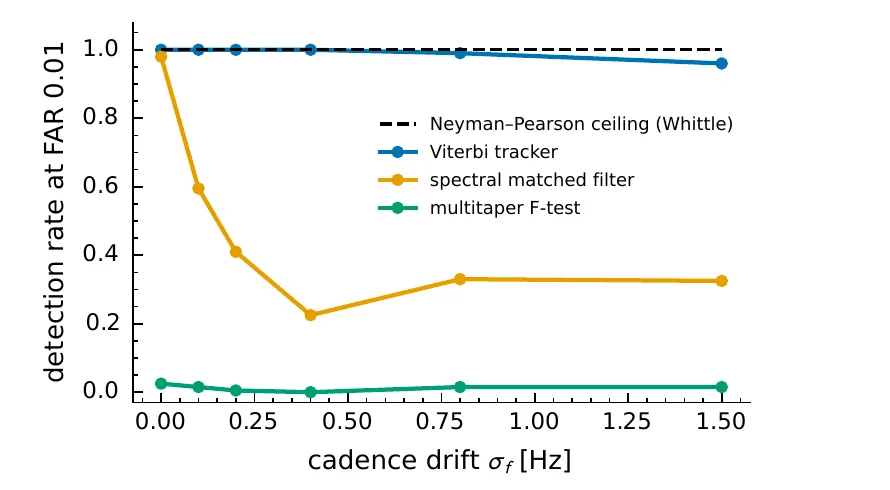
误报率为1%时,检测率随训练节奏漂移的变化:追踪器(蓝色)始终接近理论上限(虚线)。——图5,Kimpson 等(2026),arXiv:2610.30182。
隐藏的代价
接着,团队扮演起作弊者。他们尝试了八种隐藏方法:加入随机空闲时间、改变节奏、重塑每一步的形态、把训练掺杂在其他作业中,等等。面对固定频率检验,大多数方法都奏效了。面对追踪器,几乎都不奏效——在测试的46种设置中,有43种设置下它都抓住了至少95%的训练任务。
只有一种方法真正有效:改变每一步的工作量。其最强的形式在多达73%的五分钟窗口中隐藏了训练,而且不损失速度。但它有另一种代价。在一次小型真实训练中——在单块A100芯片上训练一个3,000万参数的语言模型——要达到同样的质量,视变体不同,需要多花93%到267%的算力。
时间也对作弊者不利。观察一整天、每个任务的误报率设为0.1%时,核查方抓住了**87%**使用这一最佳花招的训练任务,其中44%在第一个小时内被抓住。约七分之一逃过了检测。
下一步:真实的电表
作者列出了明确的局限。每一条记录都是合成的;在真实的多芯片设施上进行测试已在计划之中,但需要他们尚未拥有的设备。电表检测的是一种规律的节奏,而不是训练本身:其他周期性作业,或芯片自身的功率管理回路,都可能触发它。而在芯片和电表之间如果有足够大的储能装置,就可能把信号抹平——不过核查方届时只需在更靠近芯片的地方再装一个电表。