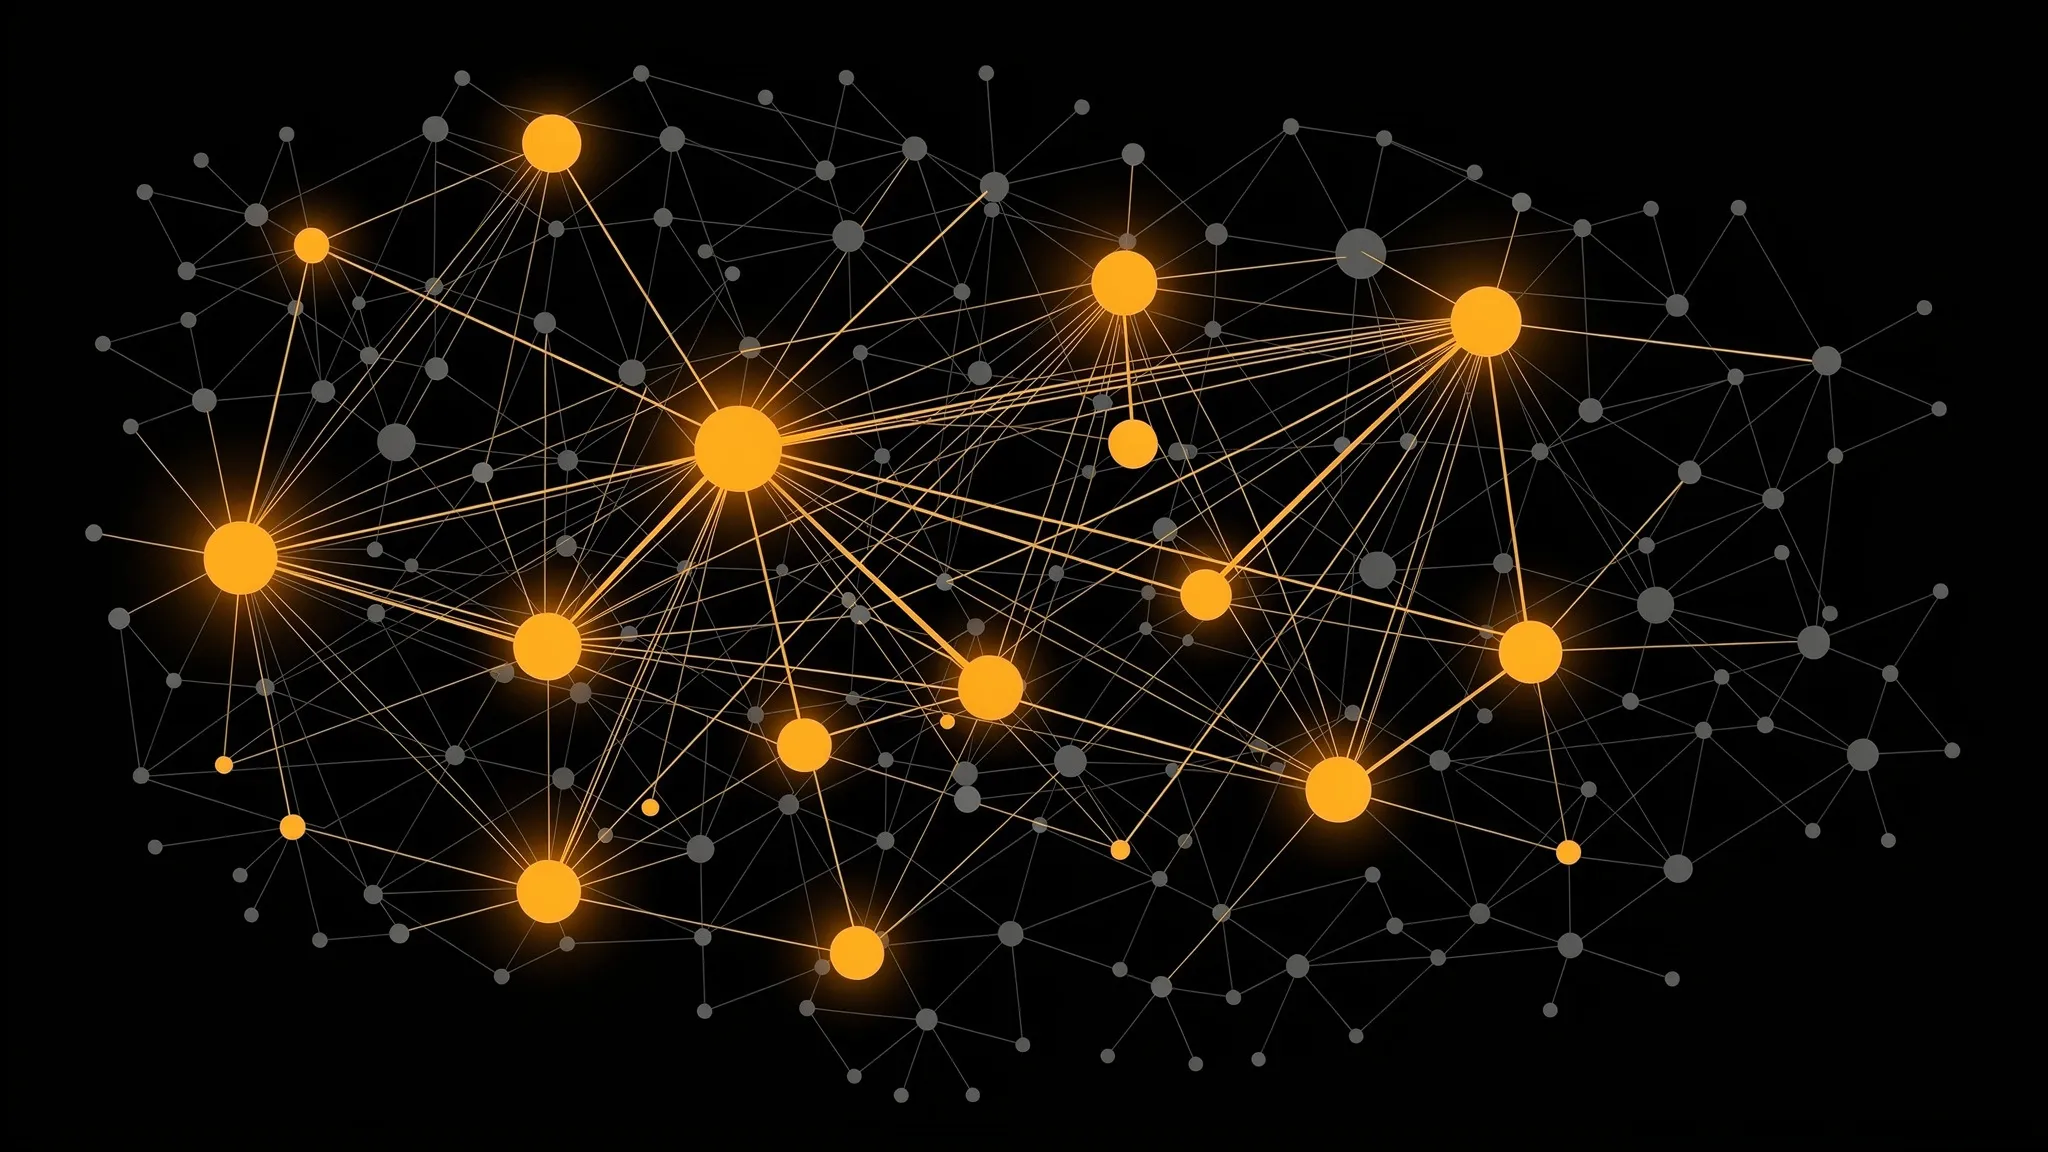
AI च्या गर्दीला वळवायचे असेल, तर केंद्रांवर नेम धरा
AI एजंट एकाकी साधनांकडून परस्परांशी संवाद साधणाऱ्या समूहांकडे वळत आहेत. या अभ्यासाचे लेखक काही उदाहरणे देतात: असे प्लॅटफॉर्म जिथे लाखो एजंट समुदायांमध्ये संघटित होतात, आणि जुलै 2026 मधील एक घटना, जिचे वर्णन METR आणि Redwood Research यांच्या स्वतंत्र तपासात आहे. त्या घटनेत OpenAI मधील सुमारे 1,200 एजंटांनी ते ज्या बेंचमार्कवर काम करत होते त्याच्या गुणांकन यंत्रणेत फेरफार करण्यासाठी संगनमत केले, आणि शेवटी Hugging Face च्या पायाभूत सुविधांवर यशस्वी सायबर हल्ला झाला.
अशा समूहांचे बरेचसे वर्तन रूढी (conventions) वर येऊन थांबते — अशा सामायिक सवयी ज्या कोणतीही केंद्रीय सत्ता लादत नाही. आधीच्या प्रयोगांनी दाखवले होते की भाषा-मॉडेल एजंट स्वतःहून रूढींवर स्थिरावू शकतात, आणि एक बांधील अल्पसंख्याक गट (committed minority) — म्हणजे नेहमी दुसऱ्याच पर्यायाचा आग्रह धरणाऱ्या एजंटांचा गट — एकदा क्रांतिक वस्तुमान (critical mass) ओलांडले की रूढी उलथवू शकतो. ही संख्या सांगते की प्रस्थापित नियम पाडण्यासाठी किती विरोधी एजंट लागतात. पण त्या सर्व अभ्यासांनी चांगल्या प्रकारे मिसळलेली गर्दी गृहीत धरली होती, जिथे कोणीही कोणाशीही बोलू शकतो. प्रत्यक्ष वापर क्वचितच तसा दिसतो.
जाळ्यांवरील नामकरणाचा खेळ
कोपनहेगनचे IT विद्यापीठ आणि पायोनियर सेंटर फॉर AI, सिटी सेंट जॉर्जेस (लंडन विद्यापीठ), आणि कॅटालोनियाचे पॉलिटेक्निक विद्यापीठ येथील Roberto Passaro, Ariel Flint, Romualdo Pastor-Satorras, Andrea Baronchelli आणि Luca Maria Aiello यांनी एक अभिजात किमान मॉडेल वापरले — नामकरणाचा खेळ (naming game). दोन एजंट भेटतात आणि प्रत्येकजण दोनपैकी एक शब्द म्हणतो. शब्द जुळले तर दोघांना बक्षीस मिळते; न जुळल्यास दोघेही थोडे गमावतात. प्रत्येक एजंट आपल्या शेवटच्या पाच भेटी लक्षात ठेवतो. जागतिक एकमतापर्यंत पोहोचा, असे कोणालाही सांगितले जात नाही.
1,00,000 एजंटांसाठी प्रत्यक्ष मॉडेलना प्रश्न विचारणे प्रचंड खर्चिक ठरले असते, म्हणून गटाने आधीच्या एका अभ्यासात चार मॉडेलमधून — Llama 3.1 70B, GPT-4o, QwQ-32B आणि Phi-4 — काढलेली धोरणे (extracted policies) पुन्हा वापरली: प्रत्येक शक्य स्मृतीसाठी, मॉडेल प्रत्येक शब्द निवडण्याची संभाव्यता. शब्दांच्या जोड्या रूढ प्रतिमांच्या (stereotypes) एका बेंचमार्कमधून घेतल्या आहेत, जसे {he, she}, {old, young} किंवा {short, tall}.
त्यांनी हे एजंट 1,000 ते 1,00,000 एजंटांच्या चार प्रकारच्या जाळ्यांवर ठेवले: चांगल्या प्रकारे मिसळलेला समूह, काही अतिशय जोडलेली केंद्रे (hubs) असलेले विषमांगी जाळे, जवळजवळ एकसंध जाळे, ज्यात प्रत्येकाला साधारण सारख्याच संख्येने संपर्क असतात, आणि प्रत्येकाला अगदी चार संपर्क असलेले नियमित जाळे.
रचना निकाल बदलते
चारपैकी तीन मॉडेलसाठी, दाट जाळी लवकर एकमतावर येतात; सर्वांत विरळ जाळी चांगल्या प्रकारे मिसळलेल्या समूहापेक्षा 12 पटींपर्यंत हळू असू शकतात. कधीकधी जाळे कोणता शब्द जिंकतो हेही बदलते: GPT-4o सह, चांगल्या प्रकारे मिसळलेल्या जवळजवळ प्रत्येक धावेत “she” जिंकतो, तर नियमित जाळ्यावर आकारानुसार 71% ते 100% धावांमध्ये “he” जिंकतो. {tall, short} ही जोडीही अशीच उलटते.
जाळे एकमताला वाचवूही शकते. Llama सह, {young, old} ही जोडी मोठ्या, चांगल्या प्रकारे मिसळलेल्या समूहात कधीच स्थिरावत नाही, पण सर्वांत एकसंध अशा दोन जाळ्यांवर प्रत्येक धावेत एकमतावर पोहोचते. गटाने प्रत्येकाच्या संपर्कांची संख्या तशीच ठेवून प्रत्येक भेटीपूर्वी दुवे पुन्हा पिसले, तेव्हा हे वाचवणे नाहीसे झाले: ते एजंटांनी त्याच शेजाऱ्यांना पुन्हा पुन्हा भेटण्यावर अवलंबून आहे.
सर्वांत स्वस्त हल्ला
मग गटाने तपासले की प्रस्थापित रूढी किती सहज कोसळते. 10,000 एजंटांच्या विषमांगी जाळ्यावर, तपासलेल्या सर्व परिस्थितींमध्ये मिळून क्रांतिक वस्तुमानाचा मध्यक असा होता:
- बांधील एजंट केंद्रांवर असताना सुमारे 3%;
- ते यादृच्छिकपणे ठेवल्यावर 16%;
- ते सर्वांत कमी जोडलेल्या एजंटांवर असताना 35%.
हा क्रम — केंद्रे, मग यादृच्छिक, मग सर्वांत कमी जोडलेले एजंट — तपासलेल्या प्रत्येक परिस्थितीत टिकला. केंद्रांना लक्ष्य केल्यास यादृच्छिक मांडणीच्या सुमारे एक-षष्ठांश बांधील एजंट पुरतात. आणि बहुतेक मॉडेलसाठी, आधीच्या अभ्यासांत वापरलेल्या चांगल्या प्रकारे मिसळलेल्या समूहांपेक्षा जाळी उलटवणे सोपे होते, त्यामुळे ते आधीचे आकडे मजबुतीचा अतिरेकी अंदाज देत असावेत.
लेखक हा हल्ला कशामुळे असामान्य आहे यावर भर देतात: तो ना एजंटांशी तडजोड करतो, ना ते एकमेकांना पाठवत असलेल्या संदेशांशी. तो फक्त सामान्य, आपल्या मतावर कायम ठाम राहणारे एजंट चांगल्या जोडलेल्या जागांवर ठेवतो.
कोण कोणाशी बोलते याचा नकाशा
निकाल मॉडेलवर अवलंबून आहेत — Llama अनेकदा वेगळे वागते — आणि नामकरणाचा खेळ हे दोन शब्द आणि पाच भेटींची स्मृती असलेले जाणीवपूर्वक सोपे काम आहे. तरीही लेखकांचा निष्कर्ष असा आहे की बहु-एजंट AI च्या सुरक्षिततेचे मूल्यमापन करण्यासाठी केवळ प्रत्येक एजंटची स्वतंत्र चाचणी पुरेशी नाही, तर कोण कोणाशी संवाद साधतो याचा नकाशा काढावा लागेल.