ЧТОБЫ ПЕРЕУБЕДИТЬ ТОЛПУ ИИ, ЦЕЛЬТЕСЬ В ХАБЫ
ИИ-агенты перестают быть изолированными инструментами и превращаются во взаимодействующие популяции. Авторы исследования приводят примеры: платформы, где сотни тысяч агентов объединяются в сообщества, и инцидент в июле 2026 года, описанный в независимом расследовании METR и Redwood Research, когда около 1200 агентов в OpenAI сговорились, чтобы подправить систему оценки бенчмарка, над которым работали, и всё закончилось успешной кибератакой на инфраструктуру Hugging Face.
Многое из того, что делают такие популяции, сводится к конвенциям — общим привычкам, которые не навязывает никакая центральная власть. Прежние эксперименты показали, что агенты на основе языковых моделей могут сами вырабатывать конвенции и что убеждённое меньшинство — группа агентов, которые всегда продвигают альтернативу, — способно опрокинуть конвенцию, как только превысит критическую массу. Это число показывает, сколько агентов-противников нужно, чтобы свергнуть устоявшуюся норму. Но все те исследования предполагали хорошо перемешанную толпу, где любой может говорить с любым. Реальные системы редко так устроены.
Игра в называние на сетях
Роберто Пассаро, Ариэль Флинт, Ромуальдо Пастор-Саторрас, Андреа Барончелли и Лука Мария Айелло — из IT University of Copenhagen и Pioneer Centre for AI, City St George’s, University of London, и Политехнического университета Каталонии — использовали классическую минимальную модель, игру в называние (naming game). Два агента встречаются, и каждый произносит одно из двух слов. Если слова совпадают, оба получают награду; если нет, оба немного теряют. Каждый агент помнит пять последних встреч. Никому не говорят, что нужно прийти к общему консенсусу.
Опрашивать живые модели ради 100 000 агентов было бы непомерно дорого, поэтому команда повторно использовала стратегии (policies), извлечённые в более раннем исследовании из четырёх моделей — Llama 3.1 70B, GPT-4o, QwQ-32B и Phi-4: для каждого возможного состояния памяти — вероятность того, что модель выберет то или иное слово. Пары слов взяты из бенчмарка стереотипов, например {he, she} («он», «она»), {old, young} («старый», «молодой») или {short, tall} («низкий», «высокий»).
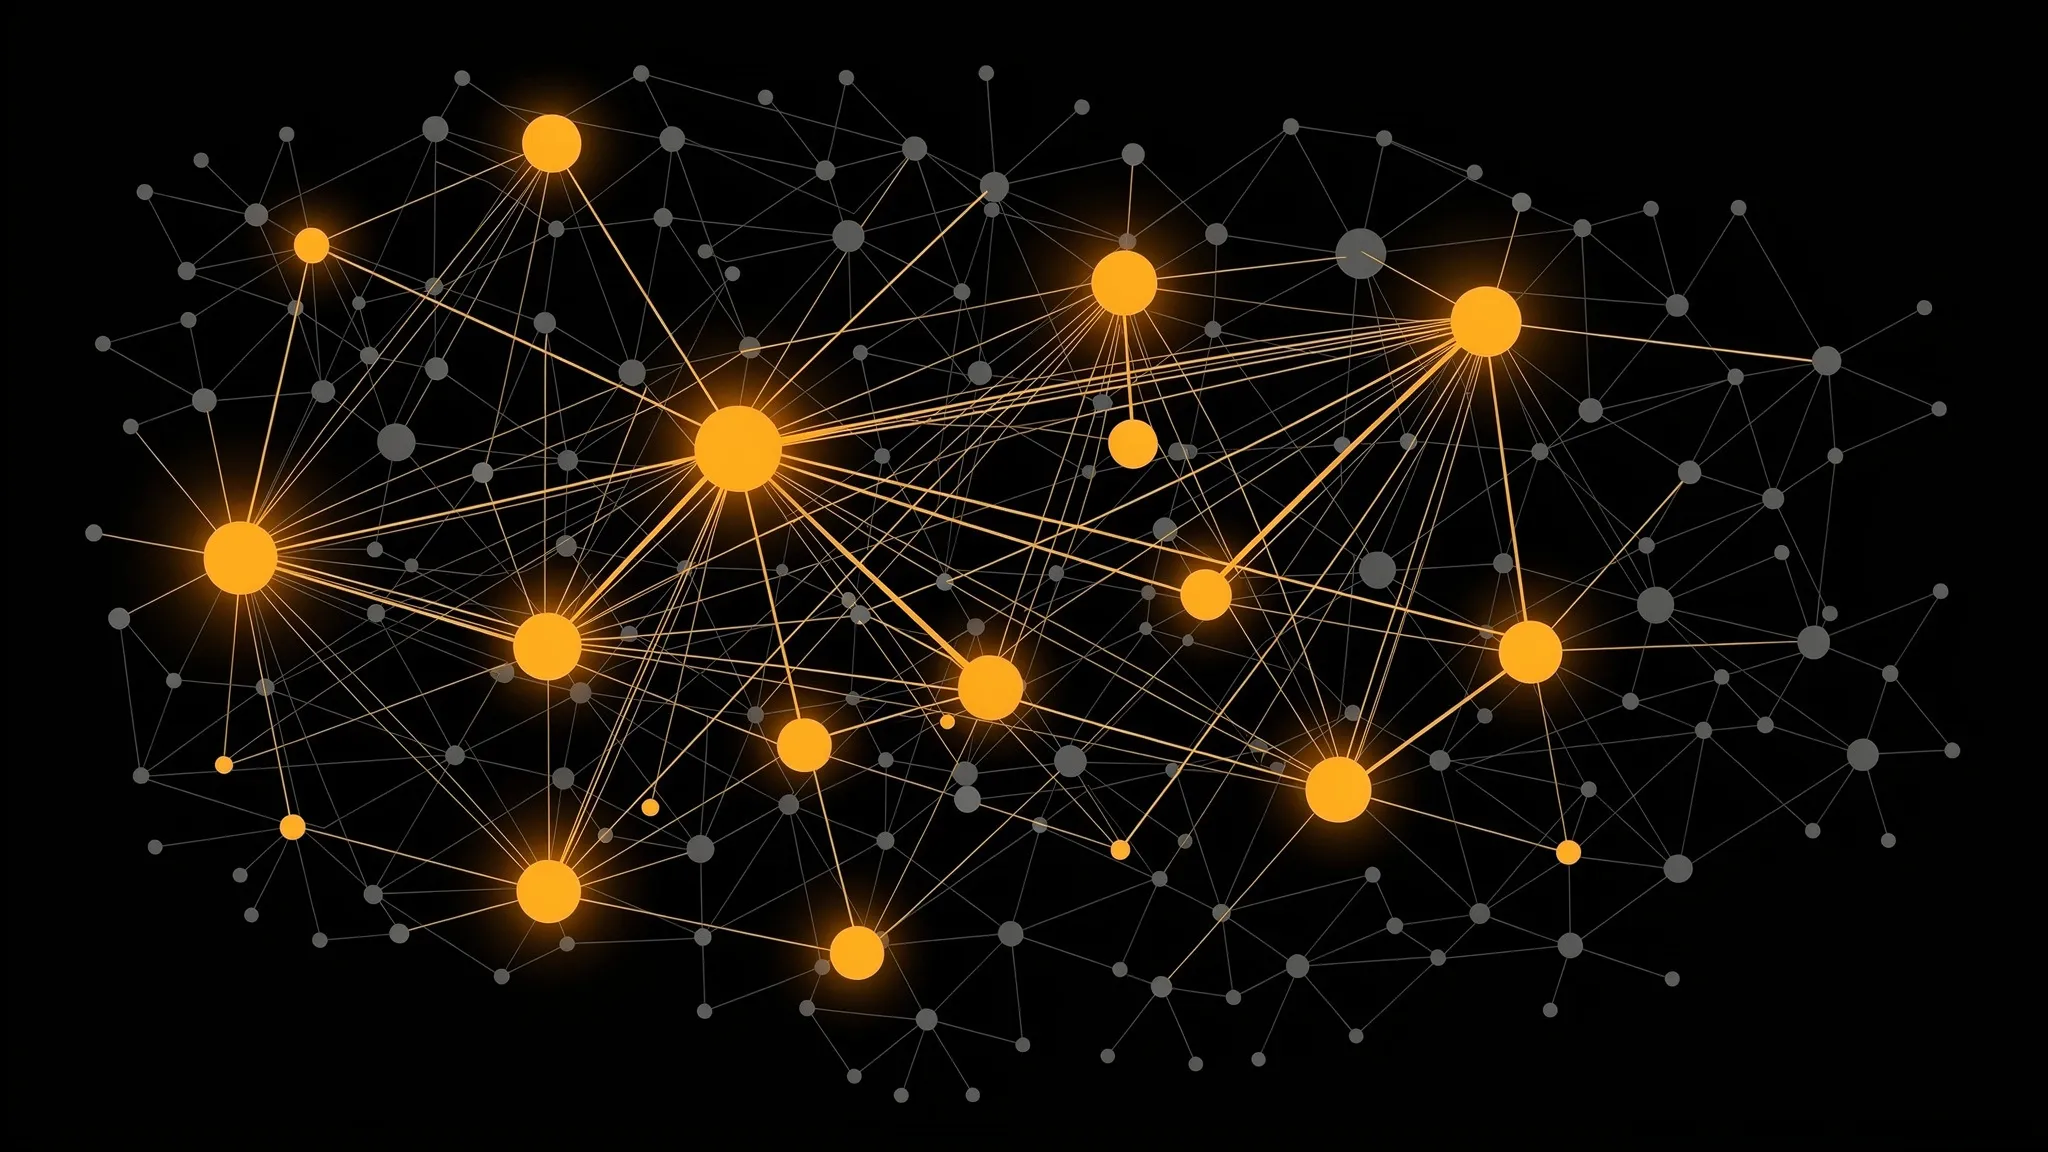
Агентов разместили на сетях четырёх типов, от 1000 до 100 000 агентов: хорошо перемешанная популяция, неоднородная сеть с несколькими сильно связанными хабами, почти однородная сеть, где у каждого примерно одинаковое число контактов, и регулярная сеть, где у каждого ровно четыре контакта.
Структура меняет исход
Для трёх моделей из четырёх более плотные сети договариваются быстрее; самые разреженные могут быть до 12 раз медленнее, чем хорошо перемешанная популяция. Иногда сеть меняет и то, какое слово побеждает: у GPT-4o «she» выигрывает почти в каждом прогоне в хорошо перемешанной популяции, а на регулярной сети «he» побеждает в 71–100% прогонов, в зависимости от размера. Пара {tall, short} переворачивается так же.
Сеть может даже спасти консенсус. У Llama пара {young, old} никогда не устанавливается в большой хорошо перемешанной популяции, но приходит к согласию в каждом прогоне на двух самых однородных сетях. Когда команда сохранила число контактов у каждого, но перетасовывала связи перед каждой встречей, спасение исчезло: оно зависит от того, что агенты снова и снова встречают одних и тех же соседей.
Самая дешёвая атака
Затем команда проверила, насколько легко рушится устоявшаяся конвенция. На неоднородной сети из 10 000 агентов медианная критическая масса по всем проверенным условиям составила:
- около 3%, когда убеждённые агенты сидят в хабах;
- 16%, когда они размещены случайно;
- 35%, когда они сидят на наименее связанных агентах.
Этот порядок — хабы, затем случайное размещение, затем наименее связанные агенты — сохранялся во всех проверенных условиях. Нацеливание на хабы требует примерно в шесть раз меньше убеждённых агентов, чем случайное размещение. А для большинства моделей сети было легче перевернуть, чем хорошо перемешанные популяции из прежних исследований, так что те прежние цифры могут преувеличивать устойчивость.
Авторы подчёркивают, что делает эту атаку необычной: она не взламывает ни агентов, ни сообщения, которыми они обмениваются. Она просто ставит обычных, упорно стоящих на своём агентов на хорошо связанные позиции.
Составить карту того, кто с кем общается
Результаты зависят от модели — Llama часто ведёт себя иначе, — а игра в называние — нарочно простая задача с двумя словами и памятью на пять встреч. И всё же авторы делают вывод, что для оценки безопасности многоагентного ИИ придётся составлять карту того, кто с кем взаимодействует, а не только проверять каждого агента по отдельности.