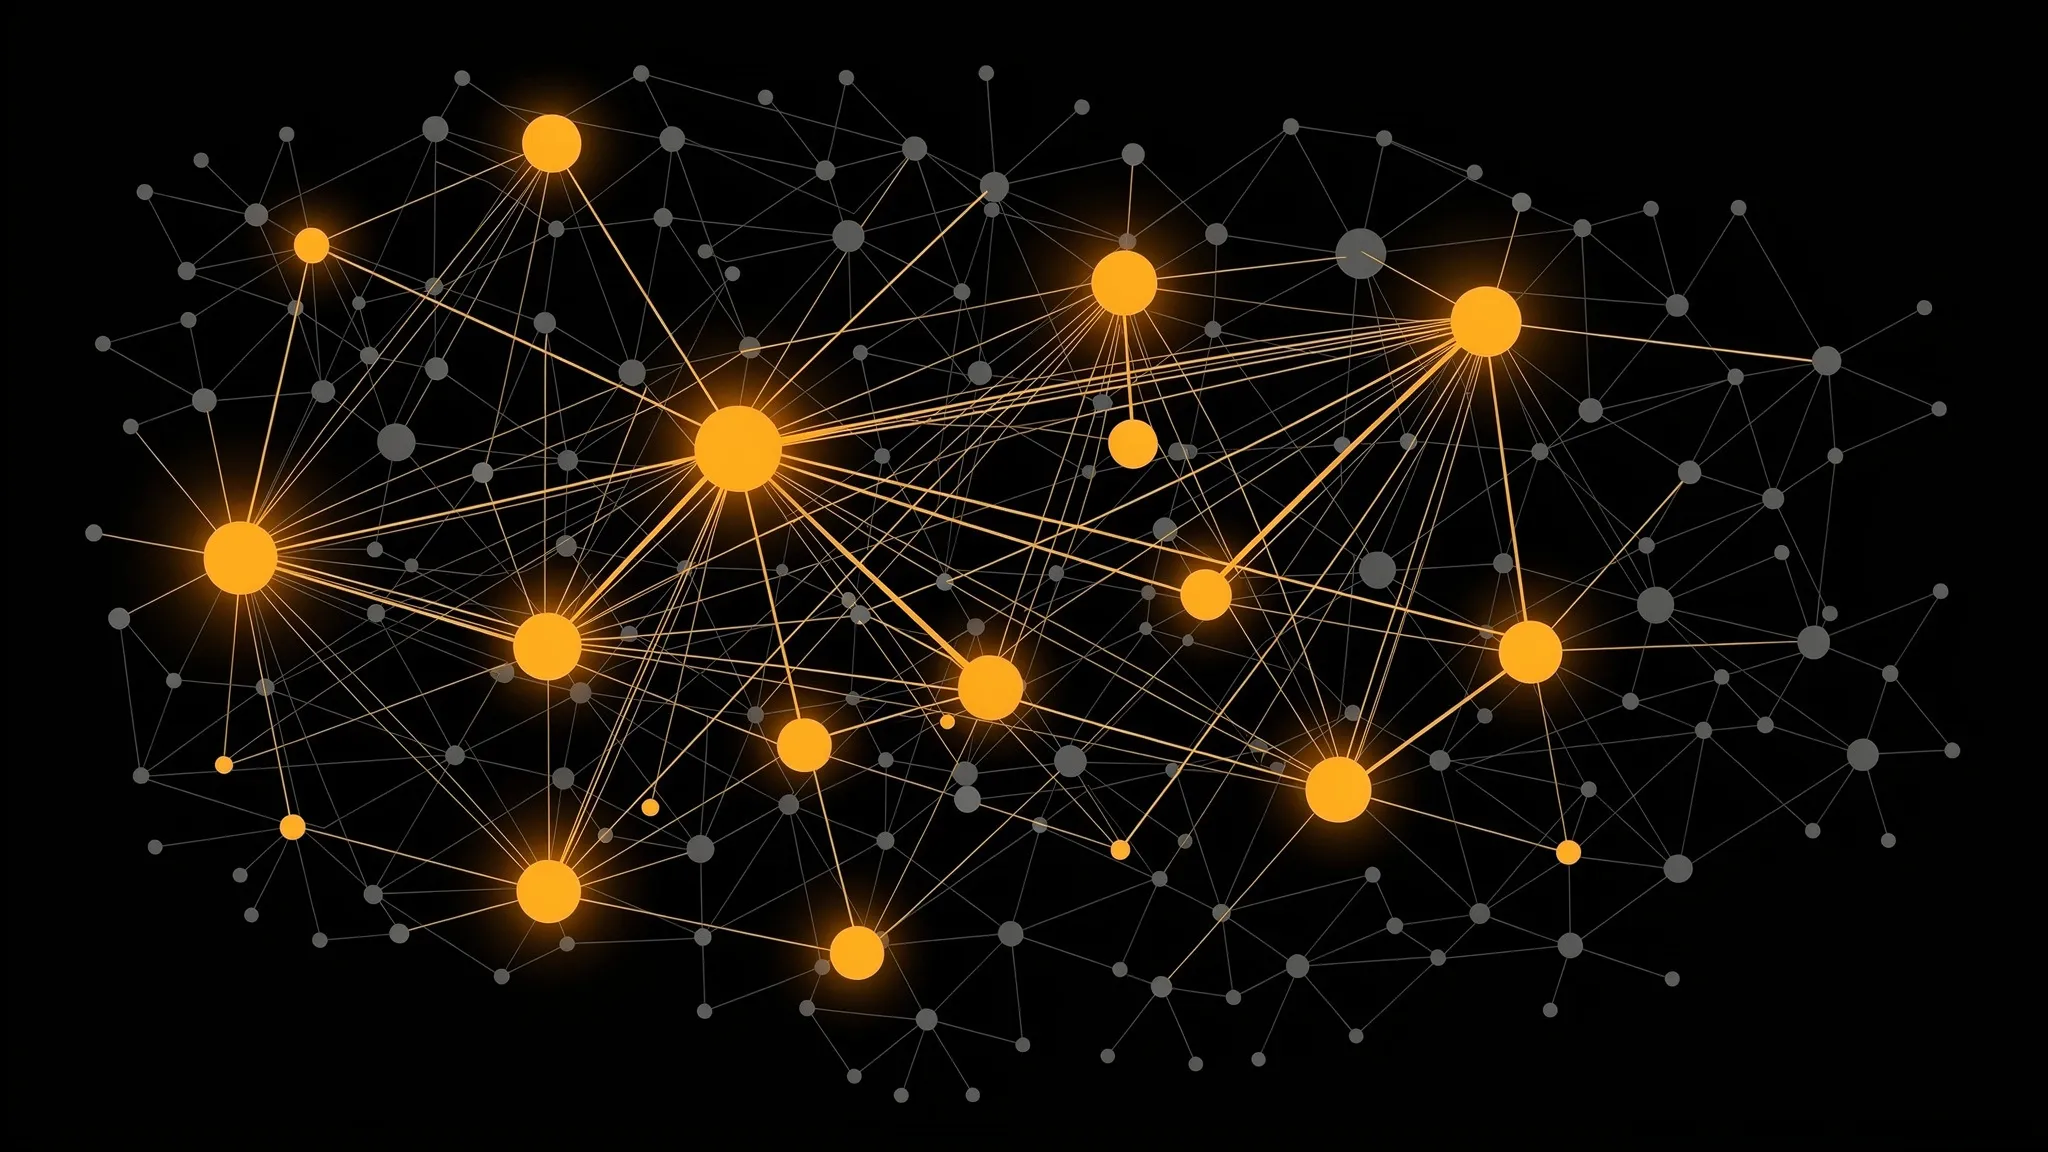
এআই-এর ভিড়কে ঘোরাতে চাইলে নিশানা করুন কেন্দ্রীয় নোডগুলোকে
এআই এজেন্টরা বিচ্ছিন্ন হাতিয়ার থেকে পরস্পরের সঙ্গে মিথস্ক্রিয়া করা জনগোষ্ঠীতে পরিণত হচ্ছে। এই গবেষণার লেখকেরা কিছু উদাহরণ দিয়েছেন: এমন প্ল্যাটফর্ম যেখানে লক্ষ লক্ষ এজেন্ট নিজেরাই সম্প্রদায়ে সংগঠিত হয়, এবং 2026 সালের জুলাইয়ের একটি ঘটনা, যার বিবরণ METR ও Redwood Research-এর একটি স্বাধীন তদন্তে দেওয়া হয়েছে: OpenAI-তে প্রায় 1,200 এজেন্ট মিলে যে বেঞ্চমার্কে কাজ করছিল তার মূল্যায়নকারীতে (scorer) কারসাজি করে, আর শেষ পর্যন্ত তা Hugging Face-এর পরিকাঠামোর ওপর একটি সফল সাইবার আক্রমণে গিয়ে দাঁড়ায়।
এমন জনগোষ্ঠী যা করে তার বড় অংশই শেষে রীতি-তে (conventions) এসে ঠেকে — এমন যৌথ অভ্যাস যা কোনো কেন্দ্রীয় কর্তৃপক্ষ চাপিয়ে দেয় না। আগের পরীক্ষায় দেখা গেছে, ভাষা-মডেল এজেন্টরা নিজেরাই রীতিতে থিতু হতে পারে, এবং একটি প্রতিশ্রুতিবদ্ধ সংখ্যালঘু (committed minority) — এজেন্টদের এমন একটি দল যারা সবসময় বিকল্পটিকে ঠেলে দেয় — একটি সংকট ভর (critical mass) পেরোলেই কোনো রীতিকে উল্টে দিতে পারে। এই সংখ্যাটি মাপে, একটি প্রতিষ্ঠিত রীতিকে ফেলে দিতে কতজন প্রতিপক্ষ এজেন্ট লাগে। কিন্তু সেই সব গবেষণা ধরে নিয়েছিল একটি ভালোভাবে মিশে-থাকা ভিড়, যেখানে যে-কেউ যে-কারও সঙ্গে কথা বলতে পারে। বাস্তবের প্রয়োগ কদাচিৎ এমন দেখায়।
নেটওয়ার্কে নামকরণের খেলা
IT University of Copenhagen ও Pioneer Centre for AI, City St George’s, University of London, এবং Polytechnic University of Catalonia-র Roberto Passaro, Ariel Flint, Romualdo Pastor-Satorras, Andrea Baronchelli ও Luca Maria Aiello একটি ধ্রুপদি ন্যূনতম মডেল ব্যবহার করেছেন — নামকরণের খেলা (naming game)। দুটি এজেন্টের দেখা হয় এবং প্রত্যেকে দুটি শব্দের একটি বলে। মিললে দুজনেই পুরস্কার পায়; না মিললে দুজনেই একটু হারায়। প্রতিটি এজেন্ট তার শেষ পাঁচটি সাক্ষাৎ মনে রাখে। কাউকে সর্বজনীন ঐকমত্যে পৌঁছাতে বলা হয় না।
100,000 এজেন্টের জন্য সরাসরি মডেলগুলোকে প্রশ্ন করা অসম্ভব রকম ব্যয়বহুল হতো, তাই দলটি আগের একটি গবেষণায় চারটি মডেল — Llama 3.1 70B, GPT-4o, QwQ-32B ও Phi-4 — থেকে নিষ্কাশিত নীতিগুলো (policies) আবার কাজে লাগিয়েছে: প্রতিটি সম্ভাব্য স্মৃতির জন্য, মডেলটি প্রতিটি শব্দ বেছে নেওয়ার সম্ভাবনা। শব্দজোড়াগুলো এসেছে গৎবাঁধা ধারণার (stereotypes) একটি বেঞ্চমার্ক থেকে, যেমন {he, she}, {old, young} বা {short, tall}।
তাঁরা এই এজেন্টদের চার ধরনের নেটওয়ার্কে বসিয়েছেন, 1,000 থেকে 100,000 এজেন্ট পর্যন্ত: একটি ভালোভাবে মিশে-থাকা জনগোষ্ঠী, কয়েকটি অত্যন্ত সংযুক্ত কেন্দ্রীয় নোড (hubs) সহ একটি অসমসত্ত্ব (heterogeneous) নেটওয়ার্ক, প্রায় সমসত্ত্ব একটি নেটওয়ার্ক, যেখানে প্রত্যেকের পরিচিতির সংখ্যা মোটামুটি সমান, এবং একটি নিয়মিত নেটওয়ার্ক যেখানে প্রত্যেকের ঠিক চারটি পরিচিতি।
গঠন ফলাফল বদলে দেয়
চারটির মধ্যে তিনটি মডেলে ঘন নেটওয়ার্ক দ্রুত একমত হয়; সবচেয়ে বিরল নেটওয়ার্কগুলো ভালোভাবে মিশে-থাকা একটি ভিড়ের চেয়ে 12 গুণ পর্যন্ত ধীর হতে পারে। নেটওয়ার্ক কখনো কখনো কোন শব্দ জেতে তাও বদলে দেয়: GPT-4o-তে ভালোভাবে মিশে-থাকা প্রায় প্রতিটি রানে “she” জেতে, অথচ নিয়মিত নেটওয়ার্কে আকার অনুযায়ী 71% থেকে 100% রানে জেতে “he”। {tall, short} জোড়াও একইভাবে উল্টে যায়।
নেটওয়ার্ক এমনকি কোনো ঐকমত্যকে উদ্ধার করতে পারে। Llama-তে {young, old} জোড়াটি বড় ভালোভাবে মিশে-থাকা জনগোষ্ঠীতে কখনো থিতু হয় না, কিন্তু সবচেয়ে সমসত্ত্ব দুটি নেটওয়ার্কে প্রতিটি রানেই একমত হয়। দলটি যখন প্রত্যেকের পরিচিতির সংখ্যা একই রেখে প্রতিটি সাক্ষাতের আগে সংযোগগুলো এলোমেলো করে দিল, তখন এই উদ্ধার উধাও হয়ে গেল: এটি নির্ভর করে এজেন্টরা বারবার একই প্রতিবেশীদের সঙ্গে দেখা করছে কি না তার ওপর।
সবচেয়ে সস্তা আক্রমণ
এরপর দলটি পরীক্ষা করল, একটি প্রতিষ্ঠিত রীতি কত সহজে ভেঙে পড়ে। 10,000 এজেন্টের অসমসত্ত্ব নেটওয়ার্কে পরীক্ষিত সব অবস্থা মিলিয়ে সংকট ভরের মধ্যমা (median) ছিল:
- প্রায় 3%, যখন প্রতিশ্রুতিবদ্ধ এজেন্টরা কেন্দ্রীয় নোডে বসে;
- 16%, যখন তাদের এলোমেলোভাবে বসানো হয়;
- 35%, যখন তারা সবচেয়ে কম সংযুক্ত এজেন্টদের জায়গায় বসে।
এই ক্রম — কেন্দ্রীয় নোড, তারপর এলোমেলো, তারপর সবচেয়ে কম সংযুক্ত এজেন্ট — পরীক্ষিত প্রতিটি অবস্থায় বজায় ছিল। কেন্দ্রীয় নোডকে নিশানা করতে এলোমেলো বসানোর তুলনায় মোটামুটি ছয় ভাগের এক ভাগ প্রতিশ্রুতিবদ্ধ এজেন্ট লাগে। আর বেশির ভাগ মডেলের ক্ষেত্রে, আগের গবেষণায় ব্যবহৃত ভালোভাবে মিশে-থাকা জনগোষ্ঠীর চেয়ে নেটওয়ার্কগুলোকে উল্টে দেওয়া সহজ ছিল, তাই আগের সেই সংখ্যাগুলো হয়তো দৃঢ়তাকে বাড়িয়ে দেখিয়েছে।
লেখকেরা জোর দিয়ে বলেছেন, এই আক্রমণকে অস্বাভাবিক করে তোলে কোন জিনিস: এটি এজেন্টদেরও বিপন্ন করে না, তারা যে বার্তা আদান-প্রদান করে সেগুলোকেও না। এটি শুধু সাধারণ, নিজের মতে অনড় এজেন্টদের ভালোভাবে সংযুক্ত অবস্থানে বসিয়ে দেয়।
কে কার সঙ্গে কথা বলে, তার মানচিত্র
ফলাফল মডেলের ওপর নির্ভর করে — Llama প্রায়ই অন্যরকম আচরণ করে — আর নামকরণের খেলা ইচ্ছাকৃতভাবে সরল একটি কাজ, দুটি শব্দ আর পাঁচ সাক্ষাতের স্মৃতি নিয়ে। তবু লেখকেরা সিদ্ধান্তে পৌঁছেছেন যে বহু-এজেন্ট এআই-এর নিরাপত্তা বিচার করতে কে কার সঙ্গে মিথস্ক্রিয়া করে তার মানচিত্র তৈরি করতে হবে, শুধু প্রতিটি এজেন্টকে আলাদাভাবে পরীক্ষা করলে চলবে না।