LOS MODELOS METEOROLÓGICOS DE IA SIGUEN MEJOR LOS CICLONES, PERO LOS SIGUEN HACIENDO DEMASIADO DÉBILES
Los modelos meteorológicos entrenados con datos compiten ya en promedio con los mejores sistemas de predicción basados en la física, por una fracción del coste de cómputo. Si eso se mantiene para los eventos raros y extremos —aquellos en los que un buen pronóstico importa más— es motivo de debate. Evaluaciones anteriores encontraron fallos graves ante fenómenos meteorológicos récord y ciclones tropicales intensos, pero sobre todo probaban modelos deterministas, que emiten un único pronóstico. Los modelos más recientes son probabilísticos: producen un conjunto de futuros posibles, cada uno de ellos un «miembro».
Los ciclones tropicales son una prueba exigente. Figuran entre los fenómenos meteorológicos más destructivos, y las evacuaciones dependen de pronósticos de su posición y su intensidad con varios días de antelación, acompañados de una medida honesta de la incertidumbre. Sin embargo, ocupan solo alrededor del 0,5 % de los puntos de malla en las simulaciones climáticas globales.
178 tormentas, de nuevo en pantalla
Nathan Chalumeau y sus colegas —del INRIA, la Universidad de la Sorbona y el CNRS, y de AXA en París— compararon tres modelos de IA: GenCast, que genera muestras del tiempo futuro con un modelo de difusión; FourCastNet 3, publicado por NVIDIA; y FGN, que construye su conjunto a partir de cuatro redes entrenadas por separado. Su vara de medir fue IFS-ENS, el conjunto operativo basado en la física del ECMWF, usado como referencia numérica.
Seleccionaron 178 ciclones que alcanzaron al menos 64 nudos de viento sostenido, en todas las cuencas oceánicas, en dos configuraciones: 125 tormentas de 2021–2023 con modelos entrenados con el reanálisis ERA5, y 53 tormentas de 2025 con versiones operativas ajustadas con los análisis de alta resolución del ECMWF. Cada pronóstico abarcó 15 días con 49 o 50 miembros, a partir de 12 horas antes del primer informe de viento de la tormenta: 26 541 pronósticos de miembros en total. Volver a ejecutar los pronósticos de 2021–2023 llevó más de 6000 horas de procesadores gráficos H100.
Puntuar una nube de posiciones posibles
Las trayectorias pronosticadas suelen juzgarse por la posición media del conjunto. Los autores muestran por qué eso puede engañar con el tifón Bualoi de 2025: los miembros de IFS-ENS se dividen en grupos separados que ningún promedio puede representar.
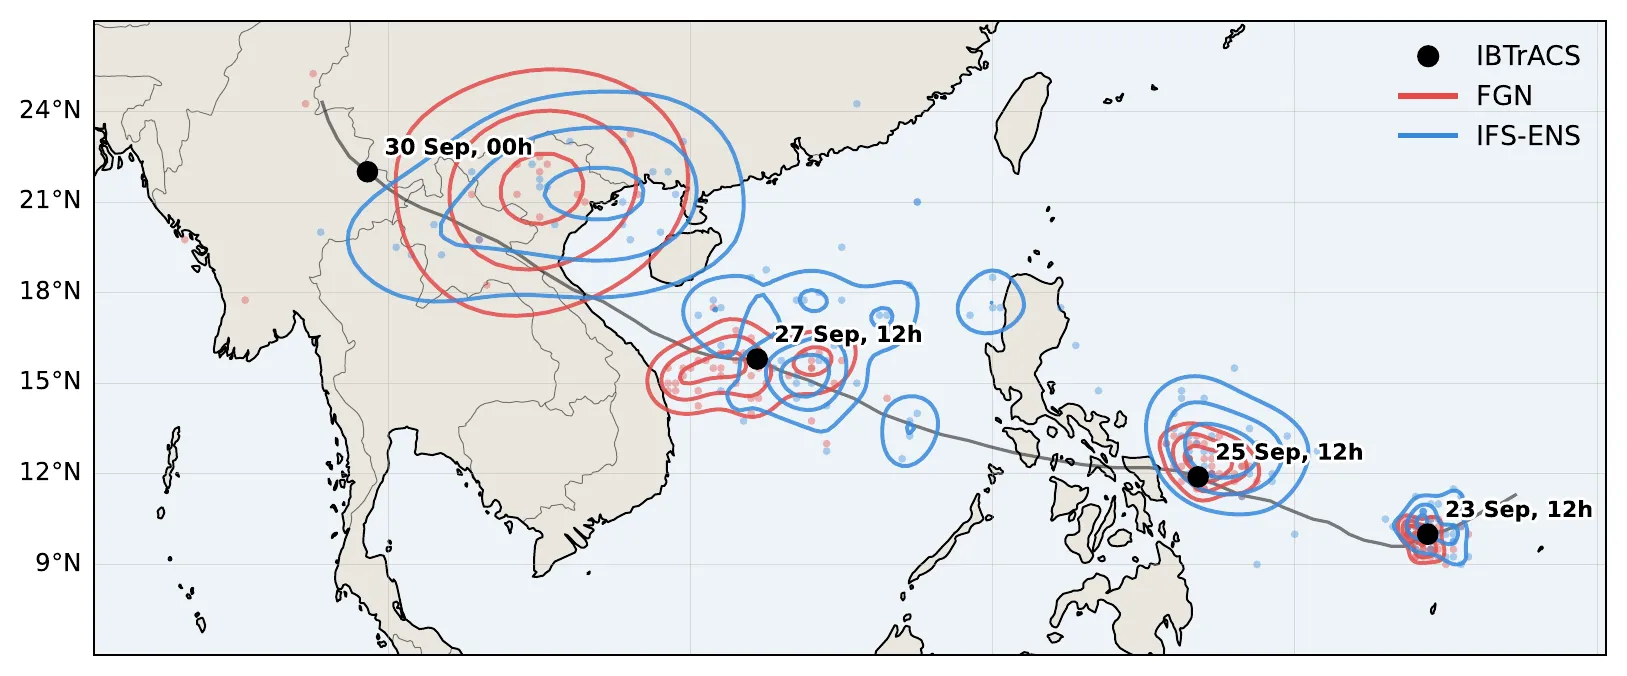
Tifón Bualoi (2025): posiciones pronosticadas por FGN (rojo) e IFS-ENS (azul) para cuatro plazos de previsión, alrededor de la trayectoria observada (puntos negros). — Figura 2, Chalumeau et al. (2026), arXiv:2610.22077.
En lugar de eso, convierten cada conjunto en un mapa de probabilidad y se preguntan qué parte de él cae sobre la posición observada de la tormenta. Una puntuación más baja significa un pronóstico mejor.
En las tormentas de 2021–2023, GenCast superó a IFS-ENS en el 68 % de los ciclones y FourCastNet 3 en el 58 %: márgenes modestos. En las tormentas de 2025, la distancia aumentó: FGN superó a IFS-ENS en cerca del 90 % de las 41 tormentas consideradas, y quedó primero de los tres modelos en el 59 % de ellas, frente al 34 % de GenCast y el 7 % de IFS-ENS. FGN obtuvo también la mejor puntuación en los campos meteorológicos completos, y ambos modelos de IA ganaron más terreno a IFS-ENS alrededor de los ciclones que en el conjunto del globo. Cuando se compararon las regiones de viento más fuerte y presión más baja solo por su forma y su posición, el orden se mantuvo: FGN, luego GenCast, luego IFS-ENS.
Tormentas demasiado suaves
Situarlas mejor no significó acertar mejor su fuerza. En las tormentas de 2025, FGN y GenCast subestimaron los vientos máximos a corto y medio plazo, mientras que IFS-ENS se mantuvo dentro de un 10 % de la referencia. El ajuste con datos operativos no había eliminado este sesgo. En la configuración anterior, GenCast tenía la mejor puntuación local y, sin embargo, el mayor déficit de viento. Los conjuntos estaban además mal calibrados, con una dispersión insuficiente en algunos lugares.
Hay un giro. Las tormentas de la IA son más débiles, pero la relación entre viento y presión en su interior parece correcta. Una vez eliminado mediante una clasificación por rangos el sesgo de intensidad de cada modelo, la correlación entre el viento máximo y la presión mínima es de −0,83 para FGN y −0,84 para GenCast, frente a −0,88 para el análisis de alta resolución y −0,87 para IFS-ENS. En FGN, entrenado variable a variable y lugar a lugar, ese vínculo nunca se impuso. Surgió de todos modos.
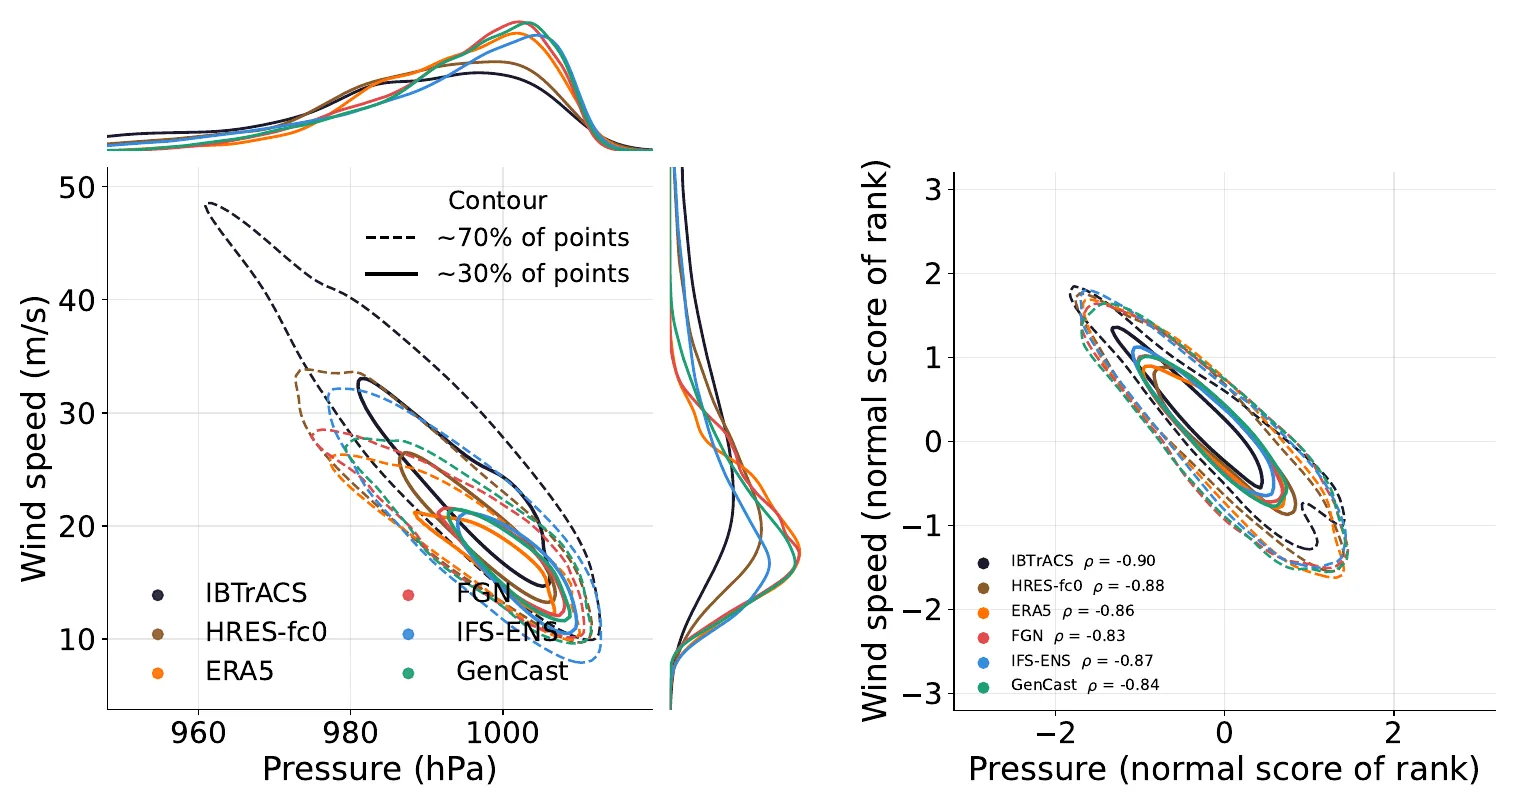
Izquierda: las tormentas de los modelos de IA tienen vientos más débiles y mínimos de presión menos profundos que la referencia. Derecha: una vez clasificadas por rangos, todas las fuentes siguen casi la misma relación viento–presión. — Figura 6, Chalumeau et al. (2026), arXiv:2610.22077.
Todavía no es un sistema de alerta
Los autores ponen límites a sus propios resultados. El estudio vuelve a simular tormentas pasadas seleccionadas; no incluye periodos sin ciclones, así que no puede juzgar si los modelos dan falsas alarmas. Las dos configuraciones difieren en tormentas, versiones de los modelos e incluso actualizaciones de IFS-ENS, por lo que el efecto del ajuste no puede aislarse. Y la declaración ética es tajante: estos resultados «no deben interpretarse como una guía para usar ninguno de estos modelos en alertas operativas».
Su conclusión es una lista de tareas. Corregir la intensidad, diseñar objetivos de entrenamiento que den peso a los vientos extremos, mejorar la incertidumbre y comprobar cada vez que las mejoras en la posición y en el vínculo viento–presión se mantienen.