KI-WETTERMODELLE VERFOLGEN WIRBELSTÜRME BESSER, MACHEN SIE ABER IMMER NOCH ZU SCHWACH
Mit Daten trainierte Wettermodelle konkurrieren inzwischen im Mittel mit den besten physikbasierten Vorhersagesystemen – zu einem Bruchteil der Rechenkosten. Ob das auch für seltene, extreme Ereignisse gilt – also gerade jene, bei denen eine gute Vorhersage am meisten zählt –, ist umstritten. Frühere Auswertungen fanden gravierende Fehler bei Rekordwetter und intensiven tropischen Wirbelstürmen, testeten aber vor allem deterministische Modelle, die eine einzige Vorhersage ausgeben. Die neuesten Modelle sind probabilistisch: Sie erzeugen ein Ensemble möglicher Zukünfte, von denen jede ein „Mitglied“ ist.
Tropische Wirbelstürme sind ein anspruchsvoller Test. Sie gehören zu den zerstörerischsten Wettergefahren, und Evakuierungen hängen von Vorhersagen ihrer Position und Stärke mehrere Tage im Voraus ab – samt einem ehrlichen Maß für die Unsicherheit. Dennoch nehmen sie in globalen Klimasimulationen nur etwa 0,5 % der Gitterpunkte ein.
178 Stürme, nachgespielt
Nathan Chalumeau und Kollegen – von INRIA, Sorbonne-Universität und CNRS sowie AXA in Paris – verglichen drei KI-Modelle: GenCast, das künftiges Wetter mit einem Diffusionsmodell erzeugt; FourCastNet 3, veröffentlicht von NVIDIA; und FGN, das sein Ensemble aus vier getrennt trainierten Netzen aufbaut. Ihr Maßstab war IFS-ENS, das operationelle physikbasierte Ensemble des ECMWF, das als numerische Vergleichsbasis diente.
Sie wählten 178 Wirbelstürme aus, die mindestens 64 Knoten Dauerwind erreichten, in allen Ozeanbecken, und zwar in zwei Szenarien: 125 Stürme aus den Jahren 2021–2023 mit Modellen, die auf der ERA5-Reanalyse trainiert waren, und 53 Stürme aus dem Jahr 2025 mit operationellen Versionen, die auf den hochaufgelösten Analysen des ECMWF nachtrainiert (feinabgestimmt) worden waren. Jede Vorhersage lief über 15 Tage mit 49 oder 50 Mitgliedern und begann 12 Stunden vor der ersten Windmeldung des Sturms – insgesamt 26.541 Mitgliedsvorhersagen. Allein die Neuberechnung der Vorhersagen für 2021–2023 kostete mehr als 6.000 Stunden auf H100-Grafikprozessoren.
Wie man eine Wolke möglicher Positionen bewertet
Vorhergesagte Zugbahnen werden üblicherweise nach der mittleren Position des Ensembles beurteilt. Am Taifun Bualoi von 2025 zeigen die Autoren, warum das in die Irre führen kann: Die Mitglieder von IFS-ENS spalteten sich in getrennte Gruppen auf, die kein Mittelwert darstellen kann.
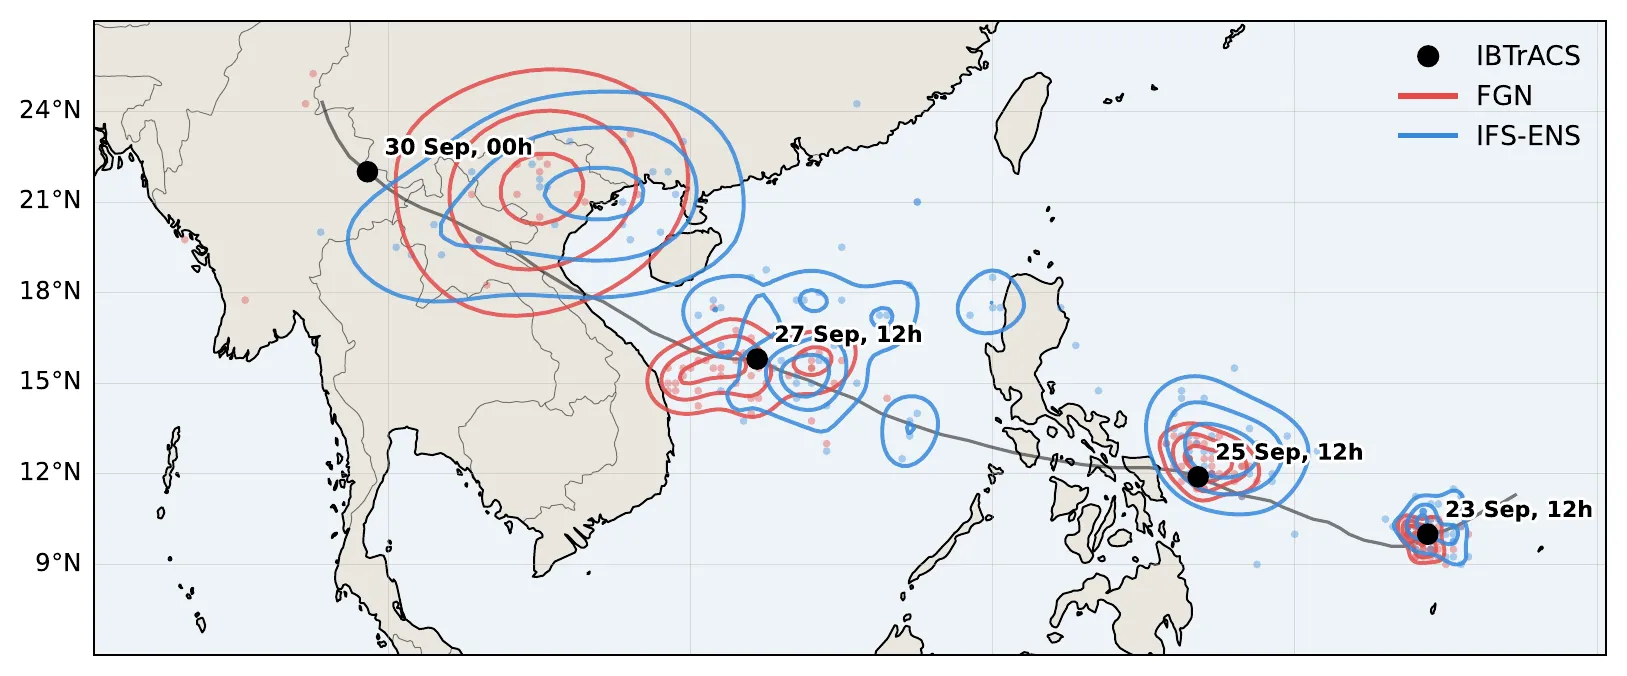
Taifun Bualoi (2025): von FGN (rot) und IFS-ENS (blau) vorhergesagte Positionen zu vier Vorhersagezeiten, um die beobachtete Zugbahn (schwarze Punkte). — Abbildung 2, Chalumeau et al. (2026), arXiv:2610.22077.
Stattdessen verwandeln sie jedes Ensemble in eine Wahrscheinlichkeitskarte und fragen, wie viel davon auf die beobachtete Position des Sturms fällt. Niedrigere Werte bedeuten eine bessere Vorhersage.
Bei den Stürmen von 2021–2023 schlug GenCast IFS-ENS bei 68 % der Wirbelstürme, FourCastNet 3 bei 58 % – bescheidene Abstände. Bei den Stürmen von 2025 wuchs der Vorsprung: FGN schlug IFS-ENS bei etwa 90 % der 41 berücksichtigten Stürme und lag bei 59 % von ihnen auf Platz eins der drei Modelle, gegenüber 34 % für GenCast und 7 % für IFS-ENS. FGN erzielte auch auf den vollständigen Wetterfeldern den besten Wert, und beide KI-Modelle gewannen gegenüber IFS-ENS rund um die Wirbelstürme mehr als über den gesamten Globus. Als die Regionen mit dem stärksten Wind und dem tiefsten Druck allein nach Form und Lage verglichen wurden, blieb die Reihenfolge gleich: FGN, dann GenCast, dann IFS-ENS.
Zu sanfte Stürme
Bessere Verortung bedeutete keine bessere Stärke. Bei den Stürmen von 2025 unterschätzten FGN und GenCast beide die Spitzenwinde auf kurze und mittlere Frist, während IFS-ENS innerhalb von 10 % der Referenz blieb. Das Nachtrainieren mit operationellen Daten hatte diese Verzerrung nicht beseitigt. Im früheren Szenario hatte GenCast den besseren lokalen Wert und dennoch das größere Winddefizit. Zudem waren die Ensembles schlecht kalibriert, mit stellenweise zu geringer Streuung.
Doch es gibt eine Wendung. Die KI-Stürme sind schwächer, aber der Zusammenhang zwischen Wind und Druck in ihnen wirkt richtig. Entfernt man die Intensitätsverzerrung jedes Modells durch Rangbildung, beträgt die Korrelation zwischen maximalem Wind und minimalem Druck −0,83 für FGN und −0,84 für GenCast, gegenüber −0,88 für die hochaufgelöste Analyse und −0,87 für IFS-ENS. Bei FGN, das jeweils für eine Variable und einen Ort auf einmal trainiert wurde, war dieser Zusammenhang nie vorgegeben worden. Er entstand trotzdem.
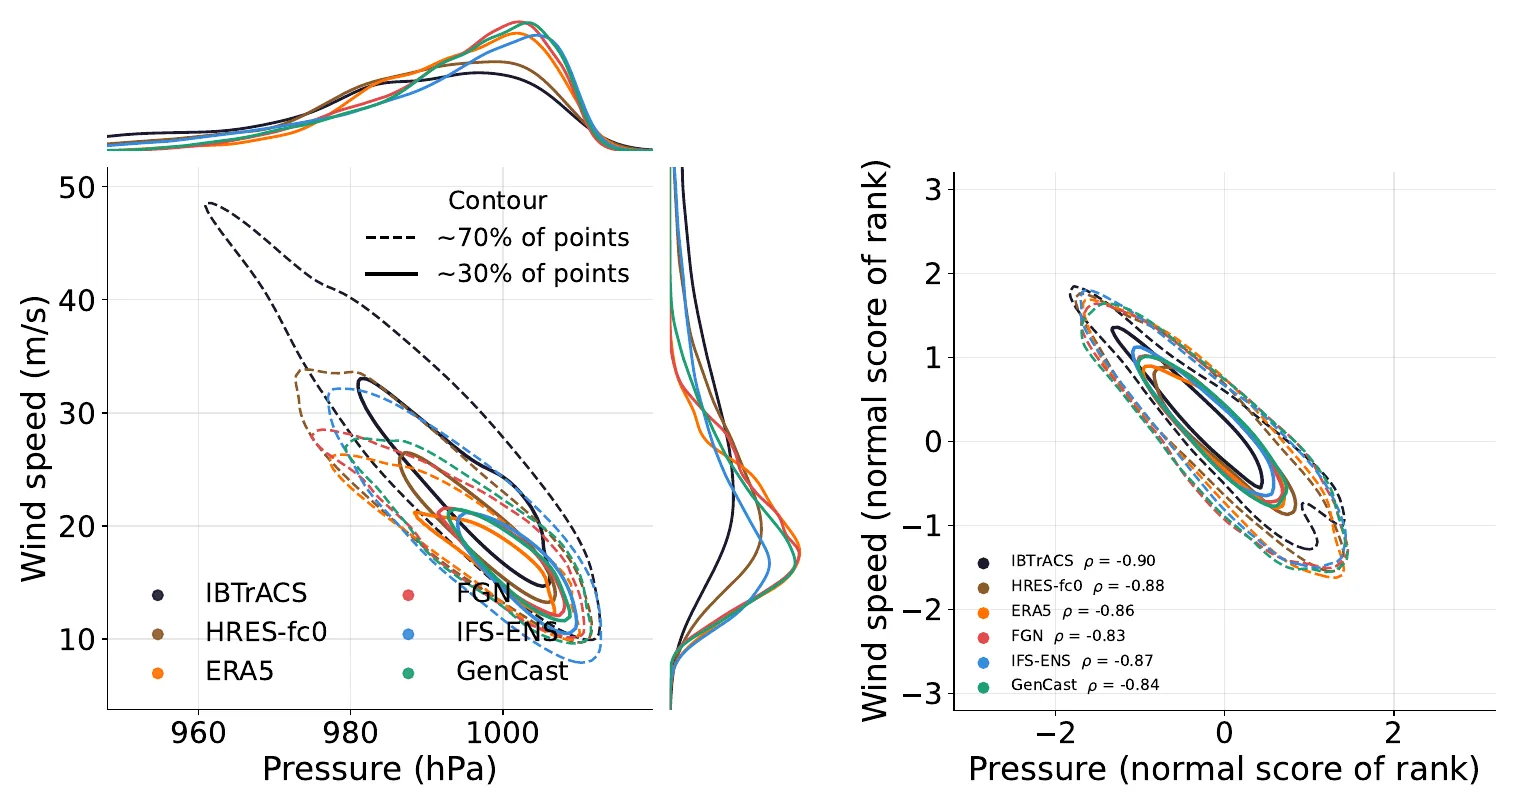
Links: Die Stürme der KI-Modelle haben schwächere Winde und weniger tiefe Druckminima als die Referenz. Rechts: Nach der Rangbildung folgen alle Quellen nahezu demselben Wind-Druck-Zusammenhang. — Abbildung 6, Chalumeau et al. (2026), arXiv:2610.22077.
Noch kein Warnsystem
Die Autoren ziehen selbst eine Grenze unter ihre Ergebnisse. Die Studie spielt ausgewählte vergangene Stürme nach; Zeiträume ohne Wirbelstürme sind nicht enthalten, daher lässt sich nicht beurteilen, ob die Modelle Fehlalarme auslösen. Die beiden Szenarien unterscheiden sich in den Stürmen, den Modellversionen und sogar in Aktualisierungen von IFS-ENS, sodass sich der Effekt des Nachtrainierens nicht isolieren lässt. Und die Ethikerklärung ist unmissverständlich: Diese Ergebnisse „sollten nicht als Anleitung verstanden werden, eines dieser Modelle für operationelle Warnungen einzusetzen“.
Ihr Fazit ist eine Aufgabenliste. Die Intensität korrigieren, Trainingsziele entwerfen, die extreme Winde gewichten, die Unsicherheit verbessern – und jedes Mal prüfen, ob die Gewinne bei der Position und beim Wind-Druck-Zusammenhang bestehen bleiben.