MODELOS METEOROLÓGICOS DE IA SEGUEM MELHOR OS CICLONES, MAS AINDA OS TORNAM FRACOS DEMAIS
Os modelos meteorológicos treinados com dados já competem, em média, com os melhores sistemas de previsão baseados na física, por uma fração do custo computacional. Se isso se mantém para eventos raros e extremos — justamente aqueles em que uma boa previsão mais importa — é motivo de debate. Avaliações anteriores encontraram falhas graves em fenômenos meteorológicos recordes e em ciclones tropicais intensos, mas testaram sobretudo modelos determinísticos, que emitem uma única previsão. Os modelos mais recentes são probabilísticos: produzem um conjunto (ensemble) de futuros possíveis, cada um deles um “membro”.
Os ciclones tropicais são um teste exigente. Estão entre os fenômenos meteorológicos mais destrutivos, e as evacuações dependem de previsões da sua posição e intensidade com vários dias de antecedência, acompanhadas de uma medida honesta da incerteza. No entanto, ocupam apenas cerca de 0,5% dos pontos da grade nas simulações climáticas globais.
178 tempestades, reproduzidas
Nathan Chalumeau e colegas — do INRIA, da Universidade Sorbonne e do CNRS, e da AXA, em Paris — compararam três modelos de IA: o GenCast, que amostra o tempo futuro com um modelo de difusão; o FourCastNet 3, lançado pela NVIDIA; e o FGN, que constrói o seu conjunto a partir de quatro redes treinadas separadamente. A referência foi o IFS-ENS, o conjunto operacional baseado na física do ECMWF, usado como base de comparação numérica.
Selecionaram 178 ciclones que atingiram pelo menos 64 nós de vento sustentado, em todas as bacias oceânicas, em dois cenários: 125 tempestades de 2021–2023, com modelos treinados na reanálise ERA5, e 53 tempestades de 2025, com versões operacionais ajustadas (fine-tuned) nas análises de alta resolução do ECMWF. Cada previsão abrangeu 15 dias com 49 ou 50 membros, começando 12 horas antes do primeiro registro de vento da tempestade — 26 541 previsões de membros no total. Refazer as previsões de 2021–2023 exigiu mais de 6000 horas de processadores gráficos H100.
Avaliar uma nuvem de posições possíveis
As trajetórias previstas costumam ser julgadas pela posição média do conjunto. Os autores mostram por que isso pode enganar com o tufão Bualoi, em 2025: os membros do IFS-ENS dividiram-se em agrupamentos distintos que nenhuma média consegue representar.
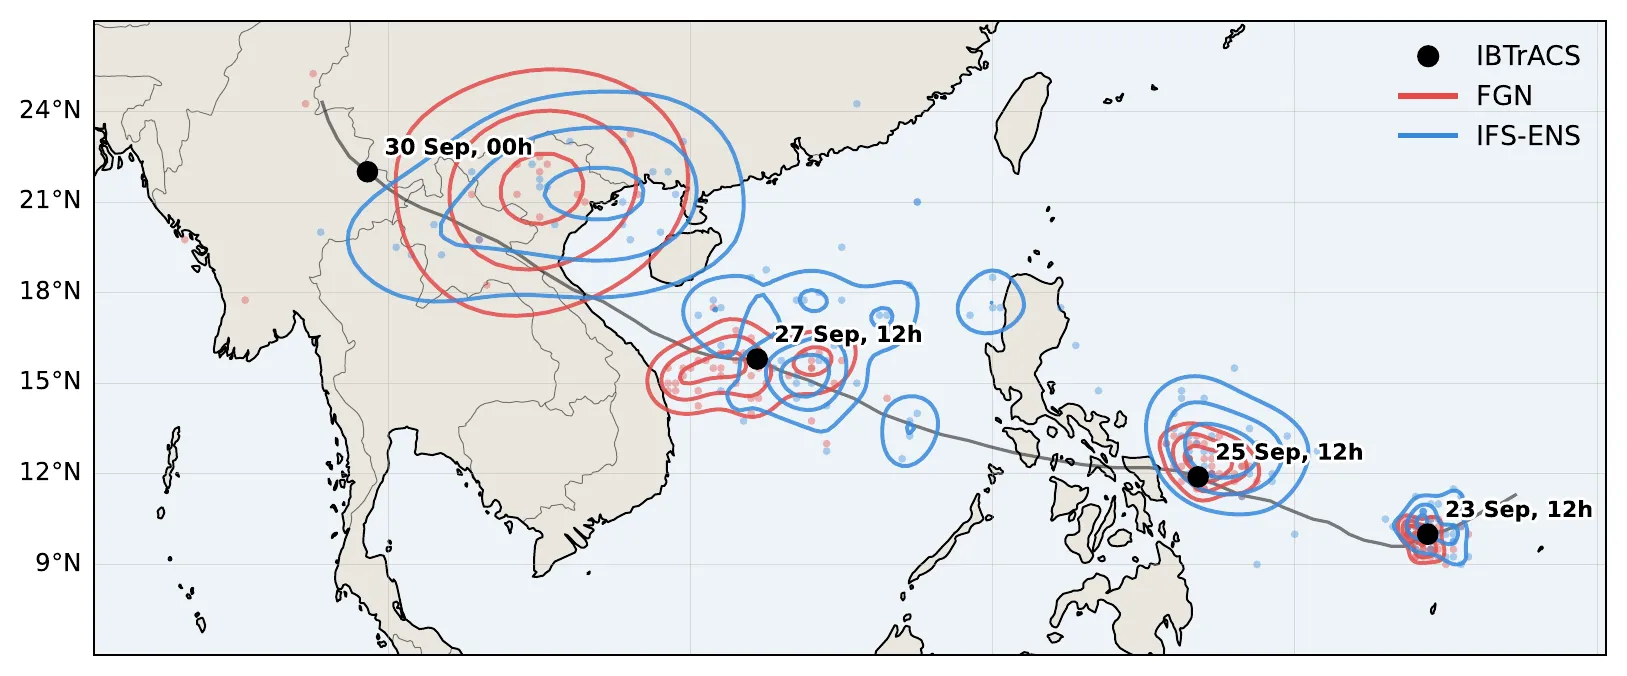
Tufão Bualoi (2025): posições previstas pelo FGN (vermelho) e pelo IFS-ENS (azul) em quatro prazos de previsão, em torno da trajetória observada (pontos pretos). — Figura 2, Chalumeau et al. (2026), arXiv:2610.22077.
Em vez disso, transformam cada conjunto num mapa de probabilidade e perguntam quanto dele cai sobre a posição observada da tempestade. Pontuações mais baixas significam uma previsão melhor.
Nas tempestades de 2021–2023, o GenCast superou o IFS-ENS em 68% dos ciclones e o FourCastNet 3 em 58% — margens modestas. Nas tempestades de 2025, a diferença aumentou: o FGN superou o IFS-ENS em cerca de 90% das 41 tempestades consideradas e ficou em primeiro lugar entre os três modelos em 59% delas, contra 34% para o GenCast e 7% para o IFS-ENS. O FGN também obteve a melhor pontuação nos campos meteorológicos completos, e ambos os modelos de IA ganharam mais vantagem sobre o IFS-ENS em torno dos ciclones do que no globo inteiro. Quando as regiões de vento mais forte e pressão mais baixa foram comparadas apenas pela forma e posição, a ordem manteve-se: FGN, depois GenCast, depois IFS-ENS.
Tempestades suaves demais
Melhor localização não significou melhor intensidade. Nas tempestades de 2025, o FGN e o GenCast subestimaram ambos os ventos máximos a curto e médio prazo, enquanto o IFS-ENS ficou a menos de 10% da referência. O ajuste com dados operacionais não eliminou esse viés. No cenário anterior, o GenCast tinha a melhor pontuação local e, no entanto, o maior déficit de vento. Os conjuntos também estavam mal calibrados, com dispersão insuficiente em alguns pontos.
Há uma reviravolta. As tempestades da IA são mais fracas, mas a relação entre vento e pressão dentro delas parece correta. Depois de eliminar por ordenação o viés de intensidade de cada modelo, a correlação entre vento máximo e pressão mínima é de −0,83 para o FGN e −0,84 para o GenCast, contra −0,88 para a análise de alta resolução e −0,87 para o IFS-ENS. No caso do FGN, treinado uma variável e um local de cada vez, essa ligação nunca foi imposta. Surgiu mesmo assim.
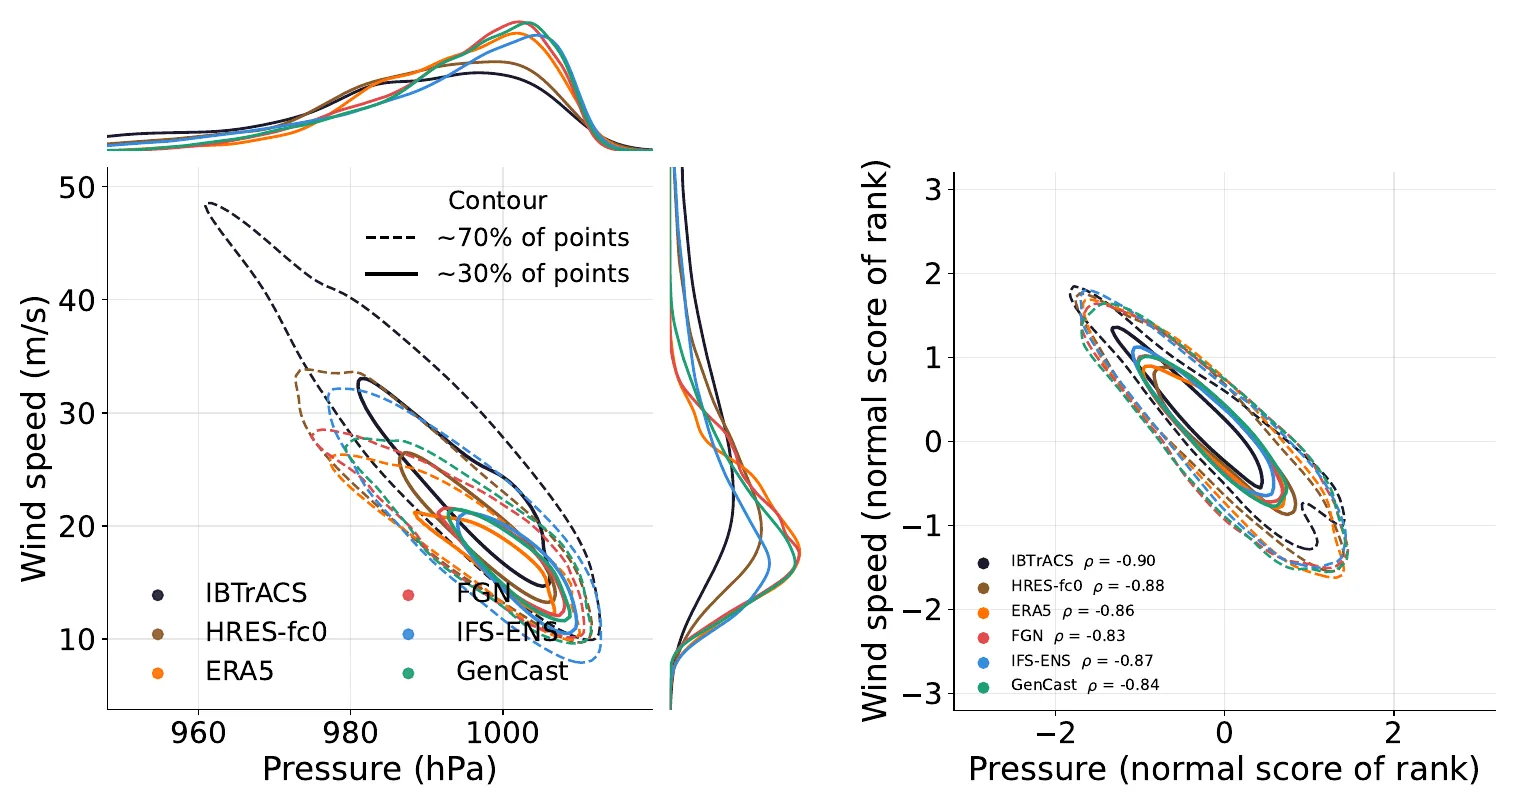
Esquerda: as tempestades dos modelos de IA têm ventos mais fracos e mínimos de pressão menos profundos do que a referência. Direita: depois da ordenação, todas as fontes seguem quase a mesma relação vento–pressão. — Figura 6, Chalumeau et al. (2026), arXiv:2610.22077.
Ainda não é um sistema de alerta
Os próprios autores traçam um limite aos seus resultados. O estudo reproduz tempestades passadas selecionadas; não inclui períodos sem ciclones, por isso não pode avaliar se os modelos geram falsos alarmes. Os dois cenários diferem nas tempestades, nas versões dos modelos e até nas atualizações do IFS-ENS, de modo que o efeito do ajuste fino não pode ser isolado. E a declaração ética é direta: estes resultados “não devem ser lidos como orientação para usar qualquer um destes modelos em alertas operacionais”.
A conclusão é uma lista de tarefas. Corrigir a intensidade, conceber alvos de treinamento que deem peso aos ventos extremos, melhorar a incerteza — e verificar sempre que os ganhos na posição e na relação vento–pressão se mantêm.