مدلهای هواشناسی هوش مصنوعی مسیر توفانها را بهتر دنبال میکنند، اما هنوز آنها را بیش از حد ضعیف نشان میدهند
مدلهای هواشناسی که با داده آموزش دیدهاند اکنون بهطور میانگین با بهترین سامانههای پیشبینی فیزیکمحور رقابت میکنند، با کسری از هزینهٔ محاسباتی. اینکه آیا این برتری دربارهٔ رویدادهای نادر و حدی — همانهایی که پیشبینی خوب در آنها بیش از همه اهمیت دارد — هم صادق است یا نه، محل بحث است. ارزیابیهای پیشین در هوای رکوردشکن و چرخندهای حارهای شدید شکستهای جدی یافته بودند، اما بیشتر مدلهای قطعی (deterministic) را آزموده بودند که یک پیشبینی واحد میدهند. تازهترین مدلها احتمالاتیاند: گروهی (ensemble) از آیندههای ممکن تولید میکنند که هر کدام یک «عضو» است.
چرخندهای حارهای آزمونی سختگیرانهاند. آنها از ویرانگرترین مخاطرات جویاند و تخلیهها به پیشبینی موقعیت و شدتشان از چند روز قبل، همراه با سنجهای صادقانه از عدم قطعیت، وابسته است. با این حال تنها حدود 0.5٪ از نقاط شبکه را در شبیهسازیهای جهانی اقلیم اشغال میکنند.
178 توفان، دوباره به نمایش درآمد
ناتان شالومو (Nathan Chalumeau) و همکارانش — از INRIA، دانشگاه سوربن و CNRS، و AXA در پاریس — سه مدل هوش مصنوعی را مقایسه کردند: GenCast که هوای آینده را با یک مدل انتشاری (diffusion model) نمونهبرداری میکند؛ FourCastNet 3 که NVIDIA منتشر کرده است؛ و FGN که گروه خود را از چهار شبکهٔ جداگانه آموزشدیده میسازد. معیار سنجش آنها IFS-ENS بود، گروهپیشبینی عملیاتی فیزیکمحور ECMWF که بهعنوان مبنای عددی به کار رفت.
آنها 178 چرخند را برگزیدند که در همهٔ حوضههای اقیانوسی دستکم به 64 نات باد پایدار رسیده بودند، در دو چیدمان: 125 توفان از 2021 تا 2023 با مدلهایی که بر بازتحلیل ERA5 آموزش دیده بودند، و 53 توفان از 2025 با نسخههای عملیاتی که بر تحلیلهای با تفکیک بالای ECMWF تنظیم دقیق شده بودند. هر پیشبینی 15 روز با 49 یا 50 عضو اجرا شد و 12 ساعت پیش از نخستین گزارش باد توفان آغاز میشد — در مجموع 26,541 پیشبینی عضو. اجرای دوبارهٔ پیشبینیهای 2021 تا 2023 بیش از 6,000 ساعت پردازندهٔ گرافیکی H100 زمان برد.
امتیازدهی به ابری از موقعیتهای ممکن
مسیرهای پیشبینیشده معمولاً با موقعیت میانگین گروه داوری میشوند. نویسندگان با توفان (تایفون) بوآلوی در 2025 نشان میدهند چرا این کار میتواند گمراهکننده باشد: اعضای IFS-ENS به خوشههای جداگانهای تقسیم شدند که هیچ میانگینی نمیتواند نمایندهٔ آنها باشد.
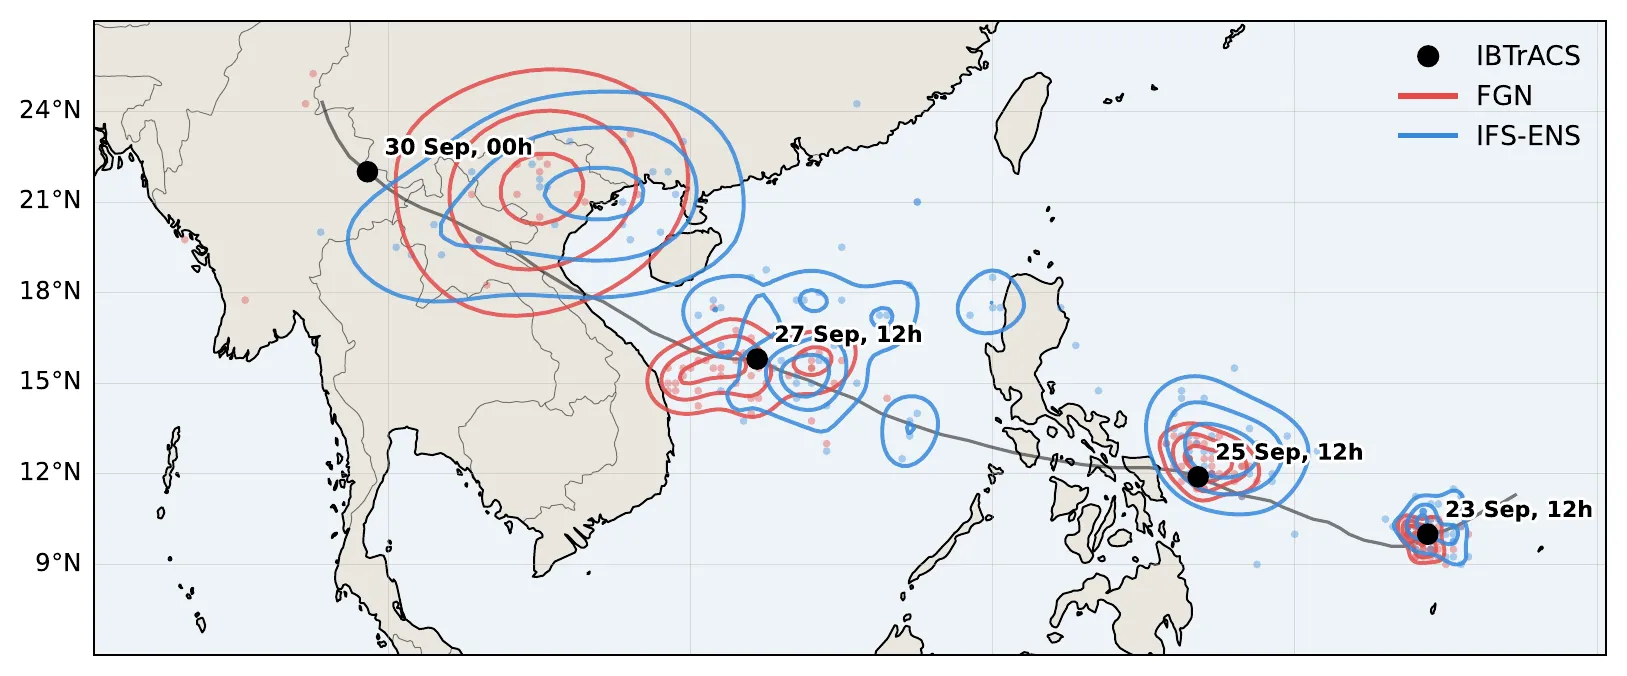
تایفون بوآلوی (2025): موقعیتهای پیشبینیشده توسط FGN (قرمز) و IFS-ENS (آبی) در چهار زمان پیشبرد، در اطراف مسیر مشاهدهشده (نقطههای سیاه). — شکل 2، Chalumeau و همکاران (2026)، arXiv:2610.22077.
در عوض، آنها هر گروه را به یک نقشهٔ احتمال تبدیل میکنند و میپرسند چه مقدار از آن بر موقعیت مشاهدهشدهٔ توفان میافتد. امتیاز کمتر یعنی پیشبینی بهتر.
در توفانهای 2021 تا 2023، GenCast در 68٪ چرخندها و FourCastNet 3 در 58٪ آنها از IFS-ENS بهتر بود — برتریهایی اندک. در توفانهای 2025 فاصله بیشتر شد: FGN در حدود 90٪ از 41 توفانِ نگهداشتهشده از IFS-ENS بهتر بود و در 59٪ آنها در میان سه مدل اول شد، در برابر 34٪ برای GenCast و 7٪ برای IFS-ENS. FGN در کل میدانهای جوی هم بهترین امتیاز را داشت، و هر دو مدل هوش مصنوعی در اطراف چرخندها بیش از سطح کل کرهٔ زمین بر IFS-ENS برتری یافتند. وقتی مناطق قویترین باد و کمترین فشار تنها از نظر شکل و موقعیت مقایسه شدند، ترتیب همان ماند: FGN، سپس GenCast، سپس IFS-ENS.
توفانهایی بیش از حد آرام
جانمایی بهتر به معنای شدت بهتر نبود. در توفانهای 2025، FGN و GenCast هر دو در بُرد کوتاه و میانه بادهای اوج را کمتر از واقع برآورد کردند، در حالی که IFS-ENS در محدودهٔ 10٪ مرجع ماند. تنظیم دقیق با دادههای عملیاتی این سوگیری را از بین نبرده بود. در چیدمان قبلی، GenCast امتیاز محلی بهتری داشت و با این حال کسری باد بزرگتری. گروهها همچنین واسنجی ضعیفی داشتند و در برخی جاها پراکندگیشان بسیار کم بود.
اما نکتهٔ غافلگیرکنندهای هست. توفانهای هوش مصنوعی ضعیفترند، اما رابطهٔ باد و فشار در درونشان درست به نظر میرسد. وقتی سوگیری شدت هر مدل با رتبهبندی حذف شود، همبستگی میان بیشینهٔ باد و کمینهٔ فشار برای FGN −0.83 و برای GenCast −0.84 است، در برابر −0.88 برای تحلیل با تفکیک بالا و −0.87 برای IFS-ENS. برای FGN که هر بار روی یک متغیر و یک مکان آموزش دیده است، این پیوند هرگز تحمیل نشده بود. با این همه، خودبهخود پدیدار شد.
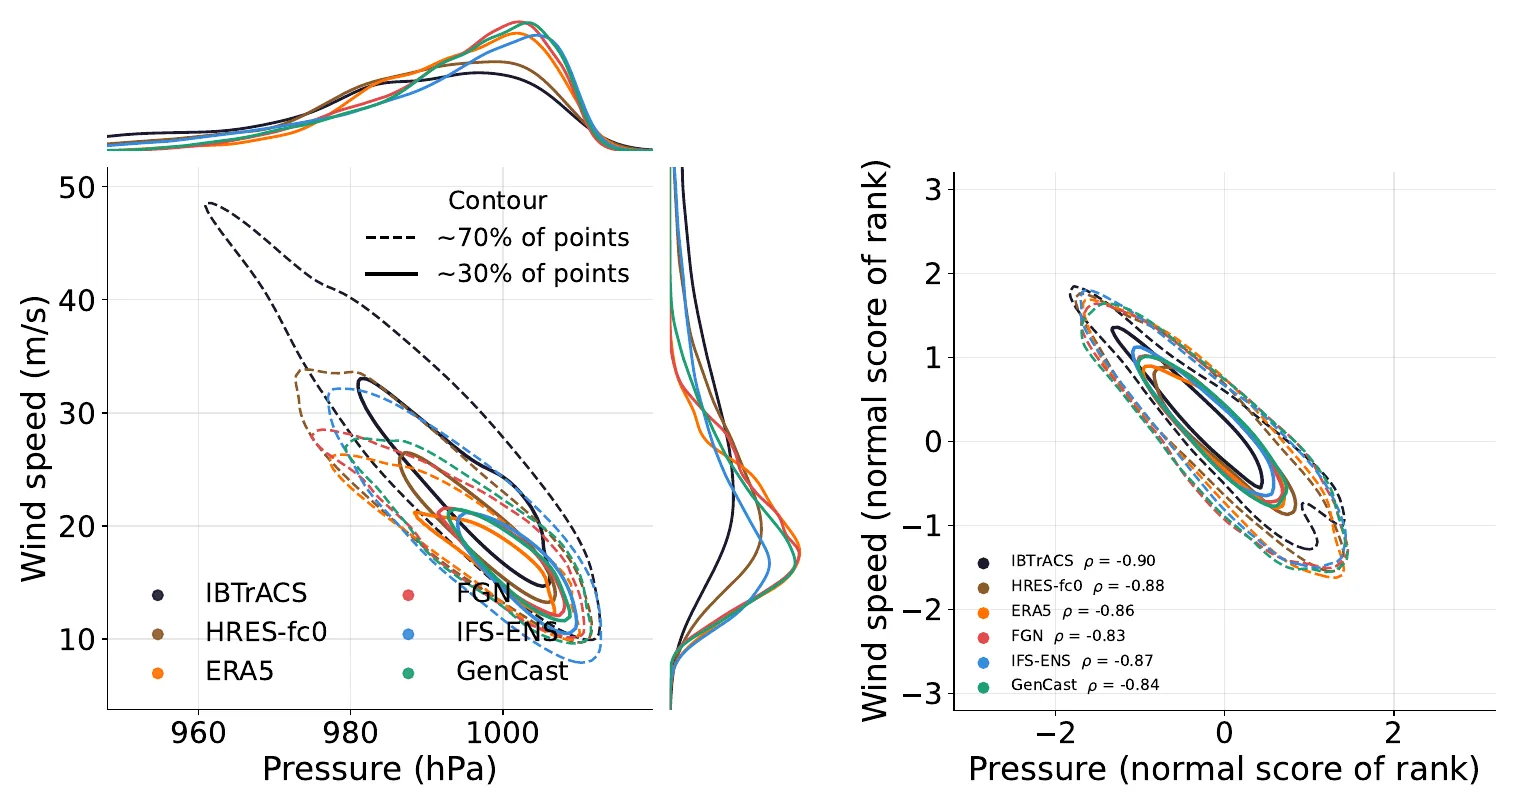
چپ: توفانهای مدلهای هوش مصنوعی بادهای ضعیفتر و کمفشارهای کمعمقتری از مرجع دارند. راست: پس از رتبهبندی، همهٔ منابع تقریباً از یک رابطهٔ باد–فشار پیروی میکنند. — شکل 6، Chalumeau و همکاران (2026)، arXiv:2610.22077.
هنوز یک سامانهٔ هشدار نیست
نویسندگان خود برای نتایجشان حد میگذارند. این مطالعه توفانهای گذشتهٔ برگزیده را بازسازی میکند؛ دورههای بدون چرخند را شامل نمیشود، پس نمیتواند داوری کند که آیا مدلها هشدار کاذب میدهند یا نه. دو چیدمان از نظر توفانها، نسخههای مدل و حتی ارتقاهای IFS-ENS با هم فرق دارند، پس اثر تنظیم دقیق را نمیتوان جدا کرد. و بیانیهٔ اخلاقی صریح است: این نتایج «نباید بهعنوان راهنمایی برای استفاده از هیچیک از این مدلها در هشدارهای عملیاتی خوانده شود.»
نتیجهگیری آنها یک فهرست کار است. شدت را اصلاح کنید، اهداف آموزشیای طراحی کنید که به بادهای حدی وزن بدهند، عدم قطعیت را بهبود دهید — و هر بار بررسی کنید که دستاوردها در موقعیت و در پیوند باد–فشار پابرجا میمانند.