مصنوعی ذہانت کے موسمی ماڈل طوفانوں کا راستہ بہتر بتاتے ہیں، مگر انہیں اب بھی بہت کمزور دکھاتے ہیں
ڈیٹا پر تربیت یافتہ موسمی ماڈل اب اوسطاً طبیعیات پر مبنی بہترین پیش گوئی کے نظاموں کا مقابلہ کرتے ہیں، اور وہ بھی کمپیوٹنگ کی لاگت کے ایک معمولی حصے پر۔ کیا یہ بات نایاب اور انتہائی واقعات پر بھی صادق آتی ہے — یعنی وہی واقعات جہاں اچھی پیش گوئی سب سے زیادہ اہم ہے — اس پر اختلاف ہے۔ پچھلے جائزوں میں ریکارڈ توڑ موسم اور شدید استوائی طوفانوں پر سنگین ناکامیاں سامنے آئیں، لیکن ان میں زیادہ تر تعینی (deterministic) ماڈل جانچے گئے تھے، جو صرف ایک پیش گوئی دیتے ہیں۔ نئے ترین ماڈل امکانی (probabilistic) ہیں: وہ ممکنہ مستقبلوں کا ایک مجموعہ (ensemble) تیار کرتے ہیں، جس کا ہر حصہ ایک “رکن” کہلاتا ہے۔
استوائی طوفان ایک کڑا امتحان ہیں۔ یہ سب سے زیادہ تباہی پھیلانے والے موسمی خطرات میں شامل ہیں، اور انخلا کا انحصار کئی دن پہلے ان کے مقام اور شدت کی پیش گوئی پر ہوتا ہے، اور ساتھ غیر یقینی کی ایک دیانت دارانہ پیمائش پر۔ اس کے باوجود عالمی موسمیاتی نقلوں (simulations) میں یہ گرڈ کے صرف تقریباً 0.5% نقاط پر پھیلے ہوتے ہیں۔
178 طوفان، دوبارہ چلائے گئے
ناتھن شالومو اور ان کے ساتھیوں نے — جو پیرس میں INRIA، سوربون یونیورسٹی اور CNRS، اور AXA سے وابستہ ہیں — تین مصنوعی ذہانت کے ماڈلز کا موازنہ کیا: GenCast، جو ایک ڈفیوژن ماڈل کے ذریعے مستقبل کے موسم کے نمونے لیتا ہے؛ FourCastNet 3، جسے NVIDIA نے جاری کیا؛ اور FGN، جو چار الگ الگ تربیت یافتہ نیٹ ورکس سے اپنا مجموعہ بناتا ہے۔ ان کا پیمانہ IFS-ENS تھا، جو ECMWF کا عملی طور پر استعمال ہونے والا طبیعیات پر مبنی مجموعہ ہے اور یہاں عددی بنیاد کے طور پر استعمال ہوا۔
انہوں نے 178 طوفان منتخب کیے جن کی مسلسل ہوا کم از کم 64 ناٹ تک پہنچی، ہر سمندری طاس میں، اور دو ترتیبوں میں: 2021–2023 کے 125 طوفان ایسے ماڈلز کے ساتھ جو ERA5 ری اینالیسس پر تربیت یافتہ تھے، اور 2025 کے 53 طوفان ایسے عملی ورژنز کے ساتھ جنہیں ECMWF کے اعلیٰ ریزولوشن تجزیوں پر مزید باریک تربیت (fine-tuning) دی گئی تھی۔ ہر پیش گوئی 15 دن تک 49 یا 50 ارکان کے ساتھ چلی، اور طوفان کی ہوا کی پہلی رپورٹ سے 12 گھنٹے پہلے شروع ہوئی — کل ملا کر 26,541 رکنی پیش گوئیاں۔ 2021–2023 کی پیش گوئیاں دوبارہ چلانے میں H100 گرافکس پروسیسرز کے 6,000 سے زیادہ گھنٹے لگے۔
ممکنہ مقامات کے بادل کو جانچنا
پیش گوئی کردہ راستوں کو عموماً مجموعے کے اوسط مقام سے پرکھا جاتا ہے۔ مصنفین 2025 کے ٹائفون بوالوئی کی مثال سے دکھاتے ہیں کہ یہ کیوں گمراہ کن ہو سکتا ہے: IFS-ENS کے ارکان الگ الگ گچھوں میں بٹ گئے جنہیں کوئی اوسط ظاہر نہیں کر سکتا۔
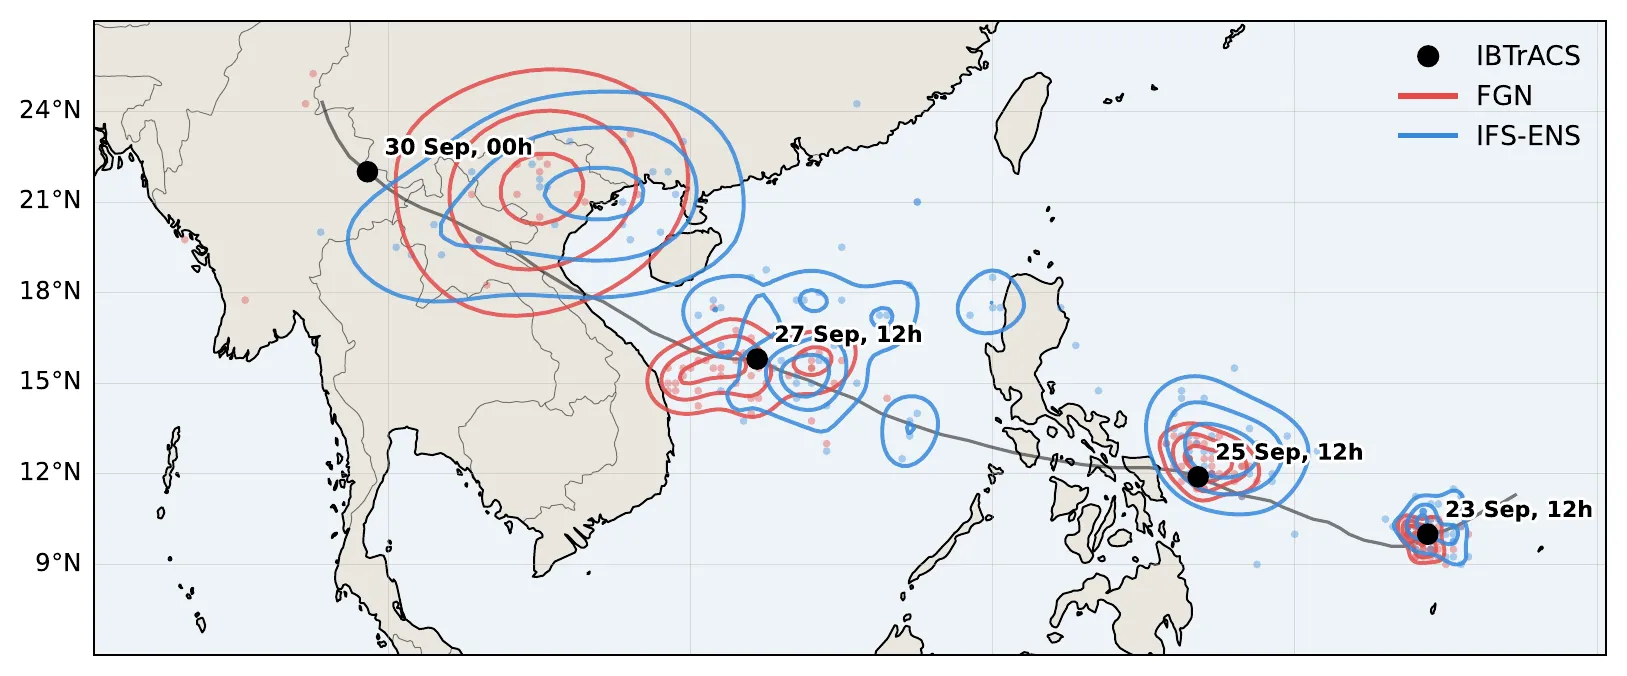
ٹائفون بوالوئی (2025): مشاہدہ شدہ راستے (سیاہ نقطے) کے گرد، پیش گوئی کے چار مختلف وقفوں پر FGN (سرخ) اور IFS-ENS (نیلا) کے پیش گوئی کردہ مقامات۔ — شکل 2، Chalumeau et al. (2026)، arXiv:2610.22077۔
اس کے بجائے وہ ہر مجموعے کو امکان کے نقشے میں بدلتے ہیں اور دیکھتے ہیں کہ اس کا کتنا حصہ طوفان کے مشاہدہ شدہ مقام پر پڑتا ہے۔ کم اسکور کا مطلب بہتر پیش گوئی ہے۔
2021–2023 کے طوفانوں پر GenCast نے 68% طوفانوں پر اور FourCastNet 3 نے 58% پر IFS-ENS کو پیچھے چھوڑا — یہ معمولی فرق تھا۔ 2025 کے طوفانوں پر فرق بڑھ گیا: FGN نے شامل کیے گئے 41 طوفانوں میں سے تقریباً 90% پر IFS-ENS کو مات دی، اور ان میں سے 59% پر تینوں ماڈلز میں پہلے نمبر پر رہا، جبکہ GenCast 34% اور IFS-ENS 7% پر۔ پورے موسمی میدانوں پر بھی FGN کا اسکور بہترین تھا، اور دونوں مصنوعی ذہانت کے ماڈلز نے IFS-ENS پر پوری دنیا کی نسبت طوفانوں کے گرد زیادہ برتری حاصل کی۔ جب تیز ترین ہوا اور کم ترین دباؤ والے علاقوں کا موازنہ صرف ان کی شکل اور مقام کی بنیاد پر کیا گیا تو ترتیب وہی رہی: FGN، پھر GenCast، پھر IFS-ENS۔
بہت نرم طوفان
بہتر مقام کا مطلب بہتر شدت نہیں تھا۔ 2025 کے طوفانوں پر FGN اور GenCast دونوں نے مختصر اور درمیانی مدت میں زیادہ سے زیادہ ہواؤں کو کم آنکا، جبکہ IFS-ENS حوالے سے 10% کے اندر رہا۔ عملی ڈیٹا پر باریک تربیت نے یہ جھکاؤ ختم نہیں کیا۔ پہلی ترتیب میں GenCast کا مقامی اسکور بہتر تھا مگر ہوا کی کمی بھی زیادہ تھی۔ مجموعے بھی ٹھیک سے ہم آہنگ (calibrated) نہیں تھے، اور کئی جگہوں پر ان کا پھیلاؤ بہت کم تھا۔
اس میں ایک موڑ ہے۔ مصنوعی ذہانت کے طوفان کمزور ہیں، مگر ان کے اندر ہوا اور دباؤ کا تعلق درست دکھائی دیتا ہے۔ جب درجہ بندی کے ذریعے ہر ماڈل کی شدت کا جھکاؤ ہٹا دیا جائے تو زیادہ سے زیادہ ہوا اور کم سے کم دباؤ کے درمیان باہمی تعلق (correlation) FGN کے لیے −0.83 اور GenCast کے لیے −0.84 ہے، جبکہ اعلیٰ ریزولوشن تجزیے کے لیے −0.88 اور IFS-ENS کے لیے −0.87۔ FGN، جسے ایک وقت میں ایک متغیر اور ایک مقام پر تربیت دی گئی، پر یہ تعلق کبھی مسلط نہیں کیا گیا تھا۔ پھر بھی یہ خود بخود ابھر آیا۔
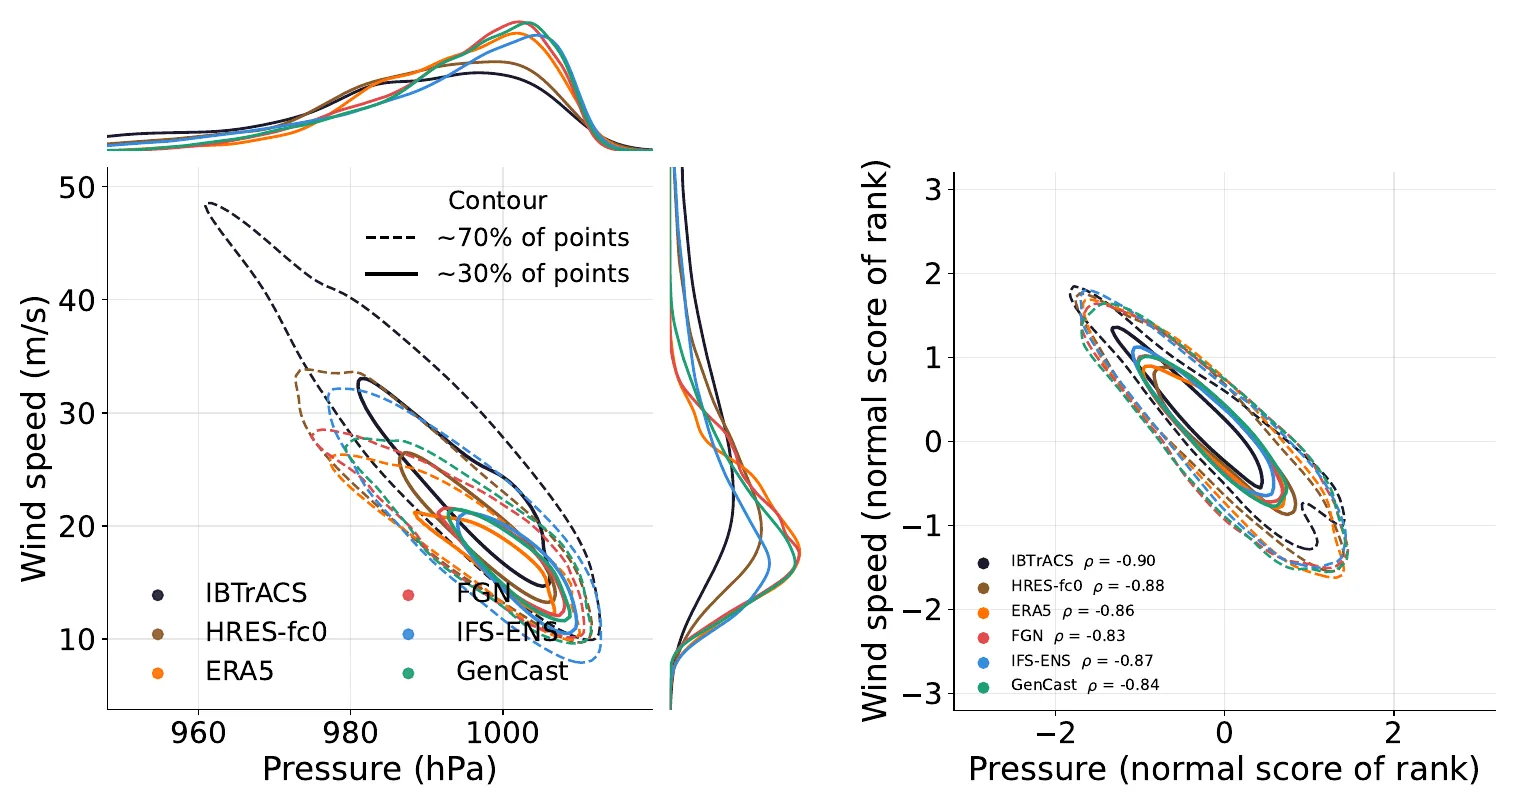
بائیں: مصنوعی ذہانت کے ماڈلز کے طوفانوں میں حوالے کی نسبت ہوائیں کمزور اور دباؤ کی کمی کم گہری ہے۔ دائیں: درجہ بندی کے بعد ہر ذریعہ تقریباً ایک ہی ہوا–دباؤ تعلق پر چلتا ہے۔ — شکل 6، Chalumeau et al. (2026)، arXiv:2610.22077۔
ابھی خبردار کرنے کا نظام نہیں
مصنفین خود اپنے نتائج کی حد کھینچتے ہیں۔ یہ مطالعہ ماضی کے منتخب طوفانوں کو دوبارہ چلاتا ہے؛ اس میں وہ ادوار شامل نہیں جن میں کوئی طوفان نہ تھا، اس لیے یہ نہیں پرکھا جا سکتا کہ ماڈلز جھوٹے الارم دیتے ہیں یا نہیں۔ دونوں ترتیبیں طوفانوں، ماڈل ورژنز اور یہاں تک کہ IFS-ENS کی تازہ کاریوں میں بھی مختلف ہیں، اس لیے باریک تربیت کا اثر الگ نہیں کیا جا سکتا۔ اور اخلاقیات کا بیان دو ٹوک ہے: ان نتائج کو “ان میں سے کسی بھی ماڈل کو عملی انتباہات کے لیے استعمال کرنے کی رہنمائی کے طور پر نہیں پڑھا جانا چاہیے۔”
ان کا نتیجہ کاموں کی ایک فہرست ہے۔ شدت کو درست کرنا، ایسے تربیتی اہداف بنانا جو انتہائی ہواؤں کو وزن دیں، غیر یقینی کو بہتر بنانا — اور ہر بار یہ جانچنا کہ مقام اور ہوا–دباؤ تعلق میں حاصل ہونے والی بہتری برقرار رہتی ہے۔