نماذج الطقس بالذكاء الاصطناعي تتتبّع الأعاصير بدقة أكبر، لكنها لا تزال تجعلها أضعف مما ينبغي
باتت نماذج الطقس المدرَّبة على البيانات تنافس في المتوسط أفضل أنظمة التنبؤ القائمة على الفيزياء، بجزء صغير من كلفة الحوسبة. أما هل يصمد ذلك أمام الأحداث النادرة المتطرفة — وهي تحديدًا الحالات التي يكون فيها التنبؤ الجيد أهم ما يكون — فمسألة خلافية. فقد وجدت تقييمات سابقة إخفاقات خطيرة أمام الطقس القياسي والأعاصير المدارية الشديدة، لكنها اختبرت في الغالب نماذج حتمية تُصدر تنبؤًا واحدًا. أما أحدث النماذج فهي احتمالية: تُنتج مجموعة من المستقبلات الممكنة، يسمّى كل واحد منها «عضوًا».
الأعاصير المدارية اختبار عسير. فهي من أشد الأخطار الجوية تدميرًا، وتعتمد عمليات الإخلاء على تنبؤات بموقعها وشدتها قبل عدة أيام، مع قياس صادق لعدم اليقين. ومع ذلك لا تشغل سوى نحو 0.5% من نقاط الشبكة في محاكاة المناخ العالمية.
178 عاصفة تُعاد محاكاتها
قارن ناتان شالومو (Nathan Chalumeau) وزملاؤه — من INRIA وجامعة السوربون والمركز الوطني الفرنسي للبحث العلمي (CNRS)، ومن AXA في باريس — بين ثلاثة نماذج ذكاء اصطناعي: GenCast الذي يستخلص عينات من الطقس المستقبلي بنموذج انتشار (diffusion model)؛ وFourCastNet 3 الذي أصدرته شركة NVIDIA؛ وFGN الذي يبني مجموعته من أربع شبكات دُرّبت كلٌّ منها على حدة. وكان معيارهم IFS-ENS، المجموعة التنبؤية الفيزيائية التشغيلية للمركز الأوروبي، المستخدمة خطًّا مرجعيًا عدديًا.
اختاروا 178 إعصارًا بلغت رياحها المستمرة 64 عقدة على الأقل، في جميع الأحواض المحيطية، ضمن إعدادين: 125 عاصفة من 2021–2023 مع نماذج مدرَّبة على إعادة التحليل ERA5، و53 عاصفة من 2025 مع نسخ تشغيلية خضعت لضبط دقيق (fine-tuning) على تحليلات المركز الأوروبي عالية الدقة. امتد كل تنبؤ 15 يومًا بـ49 أو 50 عضوًا، بدءًا من 12 ساعة قبل أول تقرير عن رياح العاصفة — أي 26,541 تنبؤًا عضويًا في المجموع. واستغرقت إعادة تشغيل تنبؤات 2021–2023 وحدها أكثر من 6,000 ساعة من معالجات الرسوميات H100.
تقييم سحابة من المواقع الممكنة
عادةً ما تُقيَّم المسارات المتوقعة بحسب الموقع المتوسط للمجموعة. ويبيّن المؤلفون لماذا قد يكون ذلك مضلِّلًا بمثال الإعصار بوالوي (Bualoi) عام 2025: فقد انقسم أعضاء IFS-ENS إلى عناقيد منفصلة لا يمكن لأي متوسط أن يمثّلها.
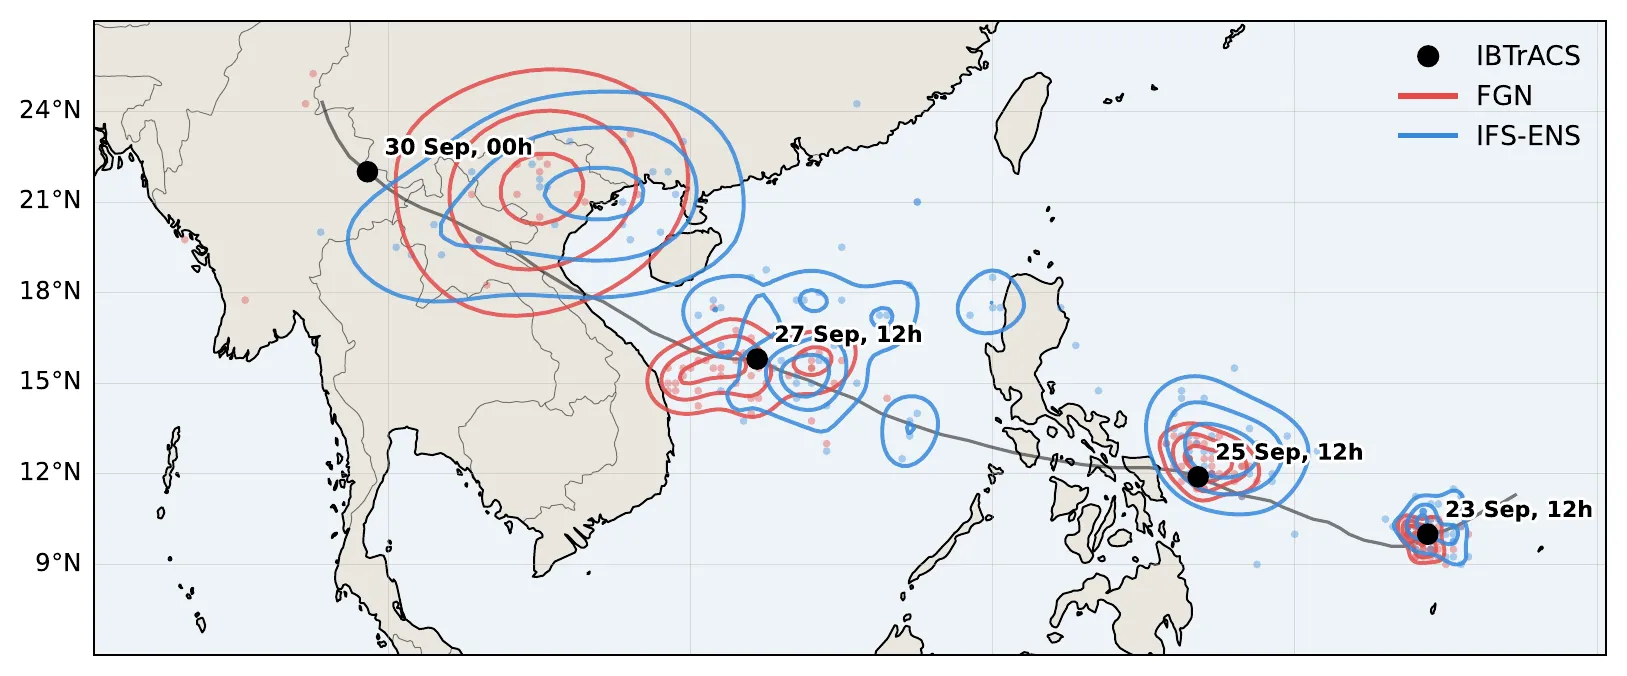
الإعصار بوالوي (2025): المواقع المتوقعة من FGN (بالأحمر) ومن IFS-ENS (بالأزرق) عند أربع مُهل تنبؤ، حول المسار المرصود (النقاط السوداء). — الشكل 2، Chalumeau وزملاؤه (2026)، arXiv:2610.22077.
بدلًا من ذلك، يحوّلون كل مجموعة إلى خريطة احتمال ويتساءلون عن مقدار ما يقع منها على الموقع المرصود للعاصفة. وكلما انخفضت الدرجة كان التنبؤ أفضل.
في عواصف 2021–2023، تفوّق GenCast على IFS-ENS في 68% من الأعاصير، وتفوّق FourCastNet 3 في 58% منها — وهي هوامش متواضعة. وفي عواصف 2025 اتسعت الفجوة: تفوّق FGN على IFS-ENS في نحو 90% من العواصف الإحدى والأربعين المعتمدة، واحتل المرتبة الأولى بين النماذج الثلاثة في 59% منها، مقابل 34% لـGenCast و7% لـIFS-ENS. وحقق FGN أيضًا أفضل درجة على حقول الطقس الكاملة، وكسب كلا نموذجي الذكاء الاصطناعي تفوقًا على IFS-ENS حول الأعاصير أكبر مما كسباه على نطاق الكرة الأرضية. وعندما قورنت مناطق أقوى الرياح وأدنى الضغط بحسب شكلها وموقعها وحدهما، بقي الترتيب كما هو: FGN، ثم GenCast، ثم IFS-ENS.
عواصف ألطف مما ينبغي
لم يعنِ تحديد الموقع بدقة أكبر تحديد الشدة بدقة أكبر. ففي عواصف 2025، قلّل كلٌّ من FGN وGenCast من الرياح القصوى على المديين القصير والمتوسط، بينما بقي IFS-ENS في حدود 10% من المرجع. ولم يُزِل الضبط الدقيق على البيانات التشغيلية هذا الانحياز. وفي الإعداد الأقدم، كانت لـGenCast أفضل درجة محلية، ومع ذلك كان لديه أكبر عجز في الرياح. كما كانت المجموعات سيئة المعايرة، مع تشتت ضئيل أكثر من اللازم في بعض المواضع.
لكن ثمة مفارقة. فعواصف الذكاء الاصطناعي أضعف، غير أن العلاقة بين الرياح والضغط داخلها تبدو صحيحة. فبعد إزالة انحياز الشدة لكل نموذج عبر الترتيب، يبلغ معامل الارتباط بين أقصى سرعة للرياح وأدنى ضغط −0.83 لـFGN و−0.84 لـGenCast، مقابل −0.88 للتحليل عالي الدقة و−0.87 لـIFS-ENS. أما FGN، الذي دُرّب على متغير واحد وموقع واحد في كل مرة، فلم تُفرَض عليه هذه العلاقة قط. ومع ذلك ظهرت من تلقاء نفسها.
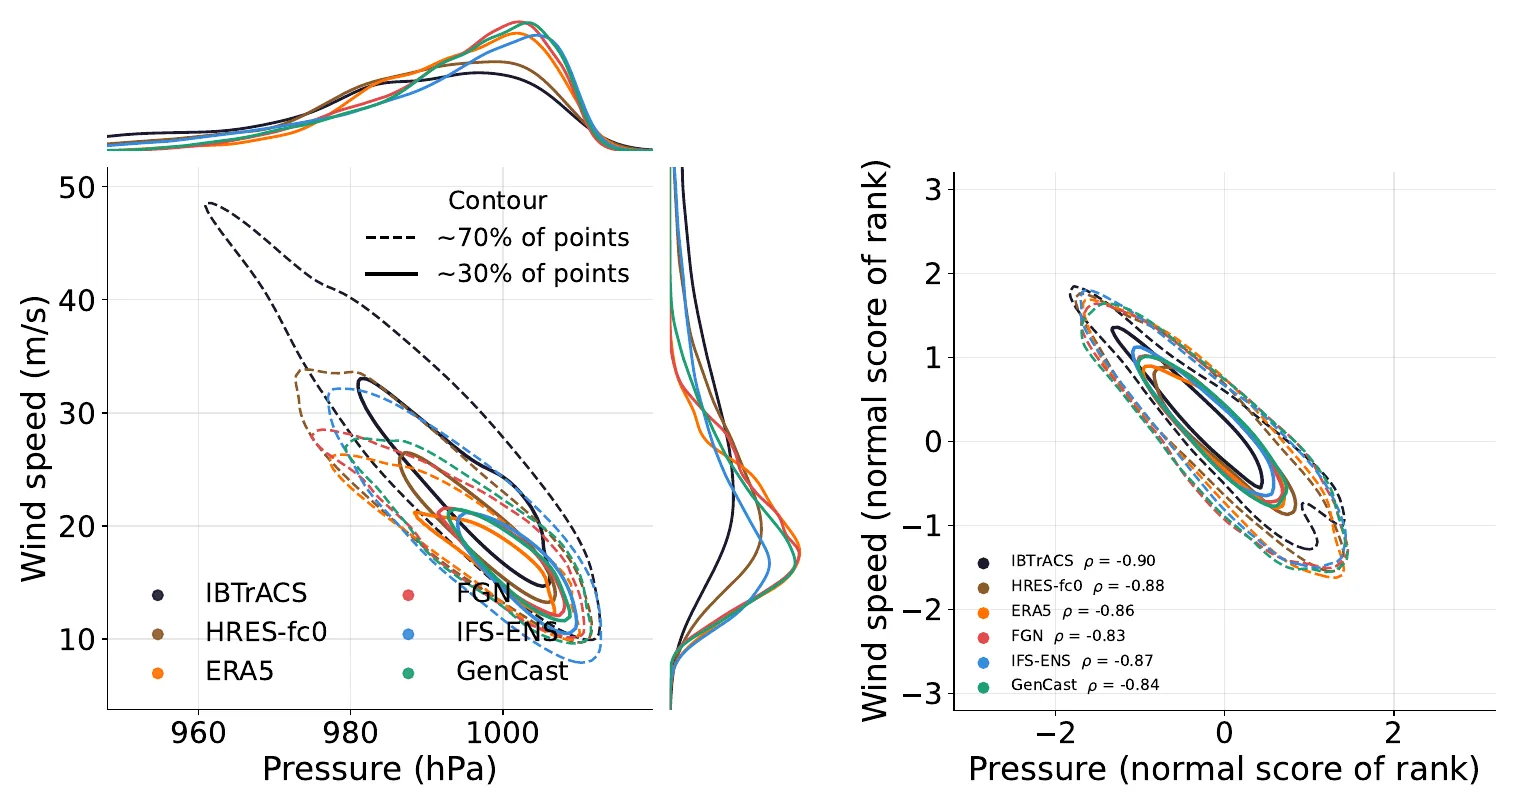
يسارًا: عواصف نماذج الذكاء الاصطناعي ذات رياح أضعف ومنخفضات ضغط أقل عمقًا من المرجع. يمينًا: بعد الترتيب، يتبع كل مصدر العلاقة نفسها تقريبًا بين الرياح والضغط. — الشكل 6، Chalumeau وزملاؤه (2026)، arXiv:2610.22077.
ليس نظام إنذار — حتى الآن
يرسم المؤلفون حدودًا لنتائجهم أنفسهم. فالدراسة تعيد محاكاة عواصف ماضية مختارة؛ ولا تشمل فترات خالية من الأعاصير، فلا يمكنها الحكم على ما إذا كانت النماذج تُطلق إنذارات كاذبة. ويختلف الإعدادان في العواصف وإصدارات النماذج وحتى في تحديثات IFS-ENS، فلا يمكن عزل أثر الضبط الدقيق. وبيان الأخلاقيات صريح: هذه النتائج «لا ينبغي أن تُقرأ على أنها إرشاد لاستخدام أي من هذه النماذج في الإنذارات التشغيلية».
خلاصتهم قائمة مهام: تصحيح الشدة، وتصميم أهداف تدريب تعطي وزنًا للرياح المتطرفة، وتحسين تقدير عدم اليقين — والتحقق في كل مرة من أن المكاسب في الموقع وفي العلاقة بين الرياح والضغط تصمد.