YAPAY ZEKÂ HAVA MODELLERİ KASIRGALARIN YOLUNU DAHA İYİ İZLİYOR, AMA ONLARI HÂLÂ FAZLA ZAYIF GÖSTERİYOR
Verilerle eğitilen hava modelleri artık ortalamada en iyi fizik tabanlı tahmin sistemleriyle, hesaplama maliyetinin küçük bir kısmıyla yarışıyor. Bunun nadir ve aşırı olaylar için — iyi bir tahminin en çok önem taşıdığı olaylar için — de geçerli olup olmadığı tartışmalı. Önceki değerlendirmeler rekor kıran hava olaylarında ve şiddetli tropikal siklonlarda ciddi başarısızlıklar bulmuştu; ancak bunlar çoğunlukla tek bir tahmin veren deterministik modelleri sınıyordu. En yeni modeller ise olasılıksal: her biri bir “üye” olan olası gelecekler topluluğu (ensemble) üretiyorlar.
Tropikal siklonlar zorlu bir sınav. En çok hasar veren hava tehlikeleri arasındalar ve tahliyeler, konumlarının ve şiddetlerinin birkaç gün önceden, belirsizliğin dürüst bir ölçüsüyle birlikte tahmin edilmesine bağlı. Oysa küresel iklim simülasyonlarında ızgara noktalarının yalnızca yaklaşık %0,5’ini kaplıyorlar.
178 fırtına, yeniden oynatıldı
Nathan Chalumeau ve meslektaşları — INRIA, Sorbonne Üniversitesi ve CNRS ile Paris’teki AXA’dan — üç yapay zekâ modelini karşılaştırdı: geleceğin havasını bir difüzyon modeliyle örnekleyen GenCast; NVIDIA’nın yayımladığı FourCastNet 3; ve topluluğunu ayrı ayrı eğitilmiş dört ağdan kuran FGN. Ölçüt olarak, sayısal referans diye kullanılan ECMWF’nin operasyonel fizik tabanlı topluluk tahmini IFS-ENS’i aldılar.
Her okyanus havzasında en az 64 knot sürekli rüzgâra ulaşmış 178 siklon seçtiler, iki düzenekte: ERA5 yeniden analiziyle eğitilmiş modellerle 2021–2023’ten 125 fırtına ve ECMWF’nin yüksek çözünürlüklü analizleriyle ince ayar yapılmış operasyonel sürümlerle 2025’ten 53 fırtına. Her tahmin 49 ya da 50 üyeyle 15 gün sürdü ve fırtınanın ilk rüzgâr raporundan 12 saat önce başladı — toplam 26.541 üye tahmini. 2021–2023 tahminlerini yeniden çalıştırmak 6.000 saatten fazla H100 grafik işlemcisi zamanı aldı.
Olası konumlardan oluşan bir bulutu puanlamak
Tahmin rotaları genellikle topluluğun ortalama konumuna göre değerlendirilir. Yazarlar bunun neden yanıltıcı olabileceğini 2025’teki Bualoi Tayfunu ile gösteriyor: IFS-ENS üyeleri, hiçbir ortalamanın temsil edemeyeceği ayrı kümelere bölündü.
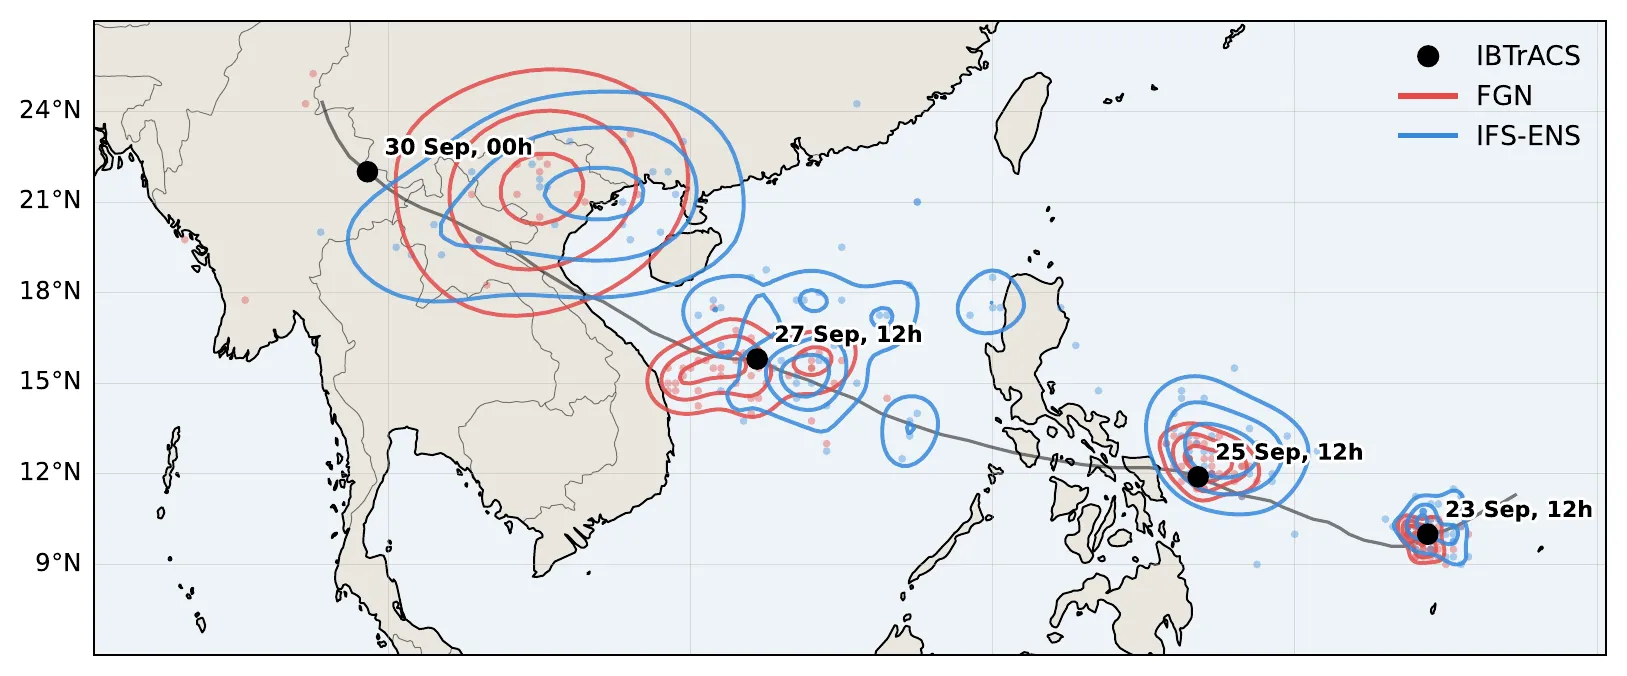
Bualoi Tayfunu (2025): FGN (kırmızı) ve IFS-ENS (mavi) tarafından dört tahmin süresinde öngörülen konumlar, gözlenen rotanın (siyah noktalar) çevresinde. — Şekil 2, Chalumeau ve ark. (2026), arXiv:2610.22077.
Bunun yerine her topluluğu bir olasılık haritasına dönüştürüp bunun ne kadarının fırtınanın gözlenen konumuna düştüğünü soruyorlar. Daha düşük puan daha iyi tahmin demek.
2021–2023 fırtınalarında GenCast siklonların %68’inde, FourCastNet 3 ise %58’inde IFS-ENS’i geride bıraktı — mütevazı farklar. 2025 fırtınalarında fark açıldı: FGN, değerlendirmede tutulan 41 fırtınanın yaklaşık %90’ında IFS-ENS’i geçti ve bunların %59’unda üç model arasında birinci oldu; GenCast’te bu oran %34, IFS-ENS’te %7’ydi. FGN tüm hava alanlarında da en iyi puanı aldı ve her iki yapay zekâ modeli de IFS-ENS karşısında siklonların çevresinde, dünya genelinde olduğundan daha fazla kazanç sağladı. En güçlü rüzgâr ve en düşük basınç bölgeleri yalnızca şekil ve konumlarına göre karşılaştırıldığında sıralama değişmedi: önce FGN, sonra GenCast, sonra IFS-ENS.
Fazla uysal fırtınalar
Daha iyi konumlandırma, daha iyi şiddet anlamına gelmedi. 2025 fırtınalarında FGN ve GenCast kısa ve orta vadede tepe rüzgârlarını olduğundan düşük tahmin etti, IFS-ENS ise referansın %10’u içinde kaldı. Operasyonel verilerle ince ayar bu sapmayı gidermemişti. Önceki düzenekte GenCast daha iyi yerel puana sahipti ama rüzgâr açığı daha büyüktü. Topluluklar ayrıca kötü kalibre edilmişti; bazı yerlerde yayılımları çok dardı.
İşin ilginç bir yanı var. Yapay zekânın fırtınaları daha zayıf, ama içlerindeki rüzgâr ile basınç arasındaki ilişki doğru görünüyor. Her modelin şiddet sapması sıralamayla giderildiğinde, en yüksek rüzgâr ile en düşük basınç arasındaki korelasyon FGN için −0,83, GenCast için −0,84; yüksek çözünürlüklü analizde −0,88, IFS-ENS’te −0,87. Her seferinde tek bir değişken ve tek bir konum üzerinde eğitilen FGN’ye bu bağ hiç dayatılmamıştı. Yine de ortaya çıktı.
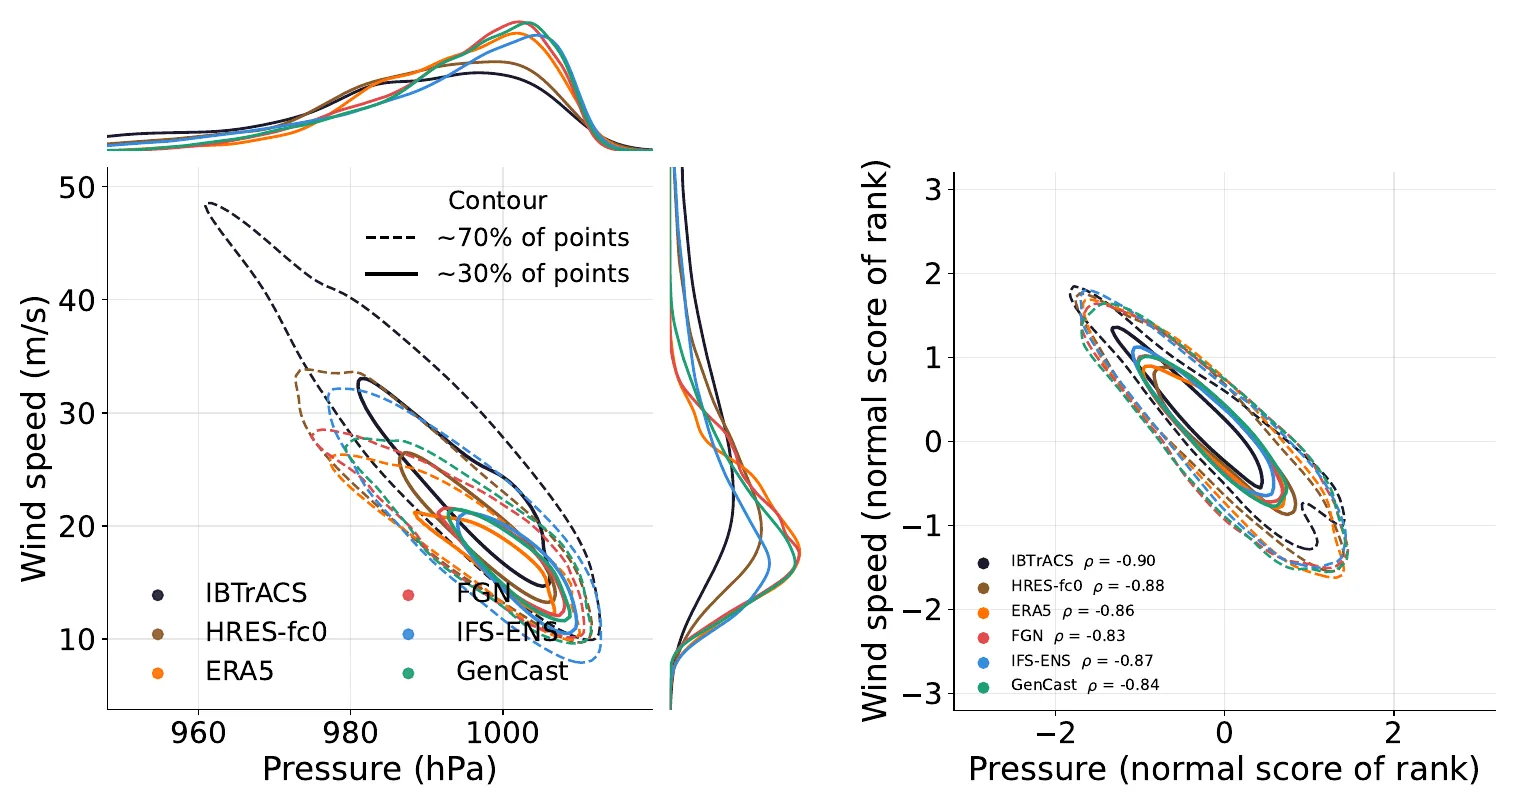
Sol: yapay zekâ modellerinin fırtınaları referansa göre daha zayıf rüzgârlara ve daha sığ alçak basınçlara sahip. Sağ: sıralandıktan sonra her kaynak neredeyse aynı rüzgâr–basınç ilişkisini izliyor. — Şekil 6, Chalumeau ve ark. (2026), arXiv:2610.22077.
Henüz bir uyarı sistemi değil
Yazarlar kendi sonuçlarının sınırını çiziyor. Çalışma seçilmiş geçmiş fırtınaları yeniden oynatıyor; siklonsuz dönemleri içermiyor, dolayısıyla modellerin yanlış alarm verip vermediğini değerlendiremiyor. İki düzenek fırtınalar, model sürümleri ve hatta IFS-ENS güncellemeleri bakımından farklı; bu yüzden ince ayarın etkisi ayrıştırılamıyor. Etik beyanı da açık sözlü: bu sonuçlar “bu modellerden herhangi birinin operasyonel uyarılar için kullanılmasına dair bir yönlendirme olarak okunmamalıdır.”
Vardıkları sonuç bir yapılacaklar listesi. Şiddeti düzeltmek, aşırı rüzgârlara ağırlık veren eğitim hedefleri tasarlamak, belirsizliği iyileştirmek — ve her seferinde konumdaki ve rüzgâr–basınç bağındaki kazanımların korunduğunu denetlemek.