DOS CAMINOS ALEATORIOS QUE PARECEN RELACIONADOS
En 1926, Yule observó algo inquietante: series temporales completamente independientes pueden mostrar grandes correlaciones. Yule lo llamó «correlación sin sentido» (nonsense correlation). Aquellos experimentos con paseos aleatorios —secuencias construidas sumando pasos aleatorios uno tras otro— mostraron correlaciones mucho más dispersas de lo que sugerirían muestras independientes. Trabajos posteriores demostraron que estas correlaciones espurias no desaparecen cuando las series se alargan.
Liping Zhu y Zhongming Xie, del Instituto de Estadística y Big Data de la Universidad Renmin de China, se preguntaron si el problema sobrevive a una herramienta más moderna.
Una medida que no debería dejarse engañar
La correlación ordinaria (de Pearson) solo detecta relaciones en línea recta. La correlación de distancias (distance correlation), descrita por Székely y sus colegas en 2007, es más ambiciosa: para dos variables aleatorias, vale cero si y solo si son independientes, sea cual sea la forma de su relación. Siempre está entre 0 y 1.
Pero esa garantía supone que los datos son extracciones independientes. Un par de paseos aleatorios es distinto. Cada paso afecta a todos los valores posteriores del paseo, así que las observaciones sucesivas comparten su pasado, y su dispersión no deja de cambiar con el tiempo. Las simulaciones ya habían mostrado grandes correlaciones de distancias entre paseos aleatorios independientes, que autores anteriores atribuyeron a la dependencia serial de los paseos y a su dispersión cambiante; lo que faltaba era una teoría de su límite.
Un límite estrictamente entre 0 y 1
Los autores demuestran que, a medida que los paseos se alargan, la correlación de distancias no se reduce a cero. Para cualquier paseo con pasos independientes, idénticamente distribuidos y de varianza finita, converge a un valor aleatorio dado por dos trayectorias brownianas, el límite continuo de los paseos aleatorios. Ese límite es universal —no depende de cómo se distribuyen los pasos— y está estrictamente entre 0 y 1, tomando valores en todo ese intervalo. Así que la probabilidad de ver una correlación por encima de cualquier umbral que se quiera, por ejemplo 0,3, nunca se anula.
La clave está en observar cuánto tiempo pasa el par de trayectorias en cada región, muestreadas en un mismo instante. Dos procesos pueden ser independientes de una realización a otra, mientras que un único par realizado, seguido a lo largo del tiempo, sigue mostrando un patrón de asociación.
Simulaciones: atascada en 0,5
El equipo simuló 2.000 pares de paseos independientes con pasos gaussianos para cada longitud de 50 a 5.000 pasos. Para los propios pasos, la correlación de distancias se desvanece como se esperaba: de 0,244 con 50 a 0,025 con 5.000. Para los paseos construidos con esos mismos pasos, se mantiene en torno a 0,5 con cualquier longitud.
Con 5.000 pasos, el 90 % central de los pares de paseos se repartía entre 0,215 y 0,844, y 1.644 de los 2.000 pares —el 82 %— superaban 0,3. Los autores subrayan que el valor cercano a 0,5 es un hallazgo empírico, no una constante demostrada.
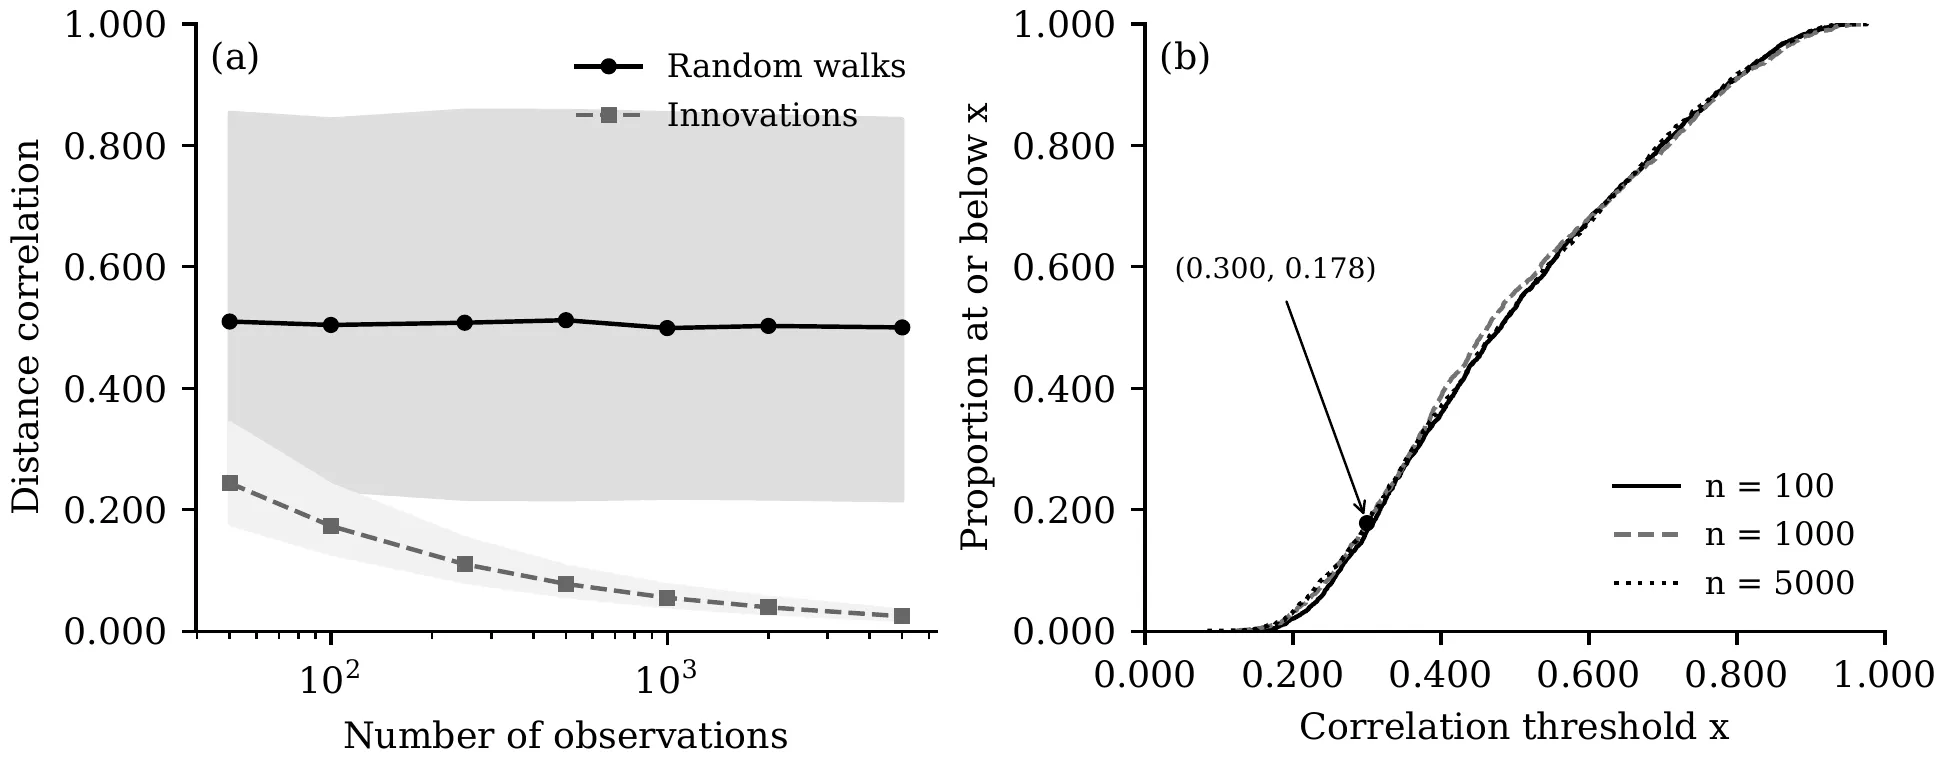
(a) Correlación de distancias media para paseos aleatorios (línea continua) y para sus pasos independientes (discontinua), con bandas del 5–95 %, frente al número de observaciones. (b) Distribución de las correlaciones de los paseos para 100, 1.000 y 5.000 pasos; el punto marcado muestra que el 17,8 % de ellas no supera 0,3 con 5.000 pasos. — Figura 1, Zhu & Xie (2026), arXiv:2611.16614.
La prueba que siempre grita «¡que viene el lobo!»
La forma estándar de comprobar la independencia con la correlación de distancias es el barajado: desordenar muchas veces el orden temporal de una de las series y ver si el valor real destaca. Los autores demuestran que, para paseos aleatorios, esta prueba rechaza la independencia con una probabilidad que tiende a 1, sea cual sea el nivel de error elegido.
Las simulaciones coinciden. Al nivel habitual del 5 %, la prueba de barajado declaró erróneamente una relación para el 94 % de los pares de paseos independientes de 100 pasos, y para los 300 pares de 500 y de 2.000 pasos. Para los propios pasos independientes, se equivocó alrededor del 5 % de las veces, como debe ser. El barajado destruye el orden temporal que llevan los paseos, así que construye una referencia que no describe paseos independientes.
¿Niveles o pasos?
El estudio calcula también una media exacta para la covarianza de distancias al cuadrado límite, 26/(75π) − 1/12, unos 0,0270, que las simulaciones reproducen con un margen de alrededor de un error estándar.
Los autores extraen una lección prudente. Preguntar si dos procesos son dependientes no es lo mismo que preguntar si un par observado de trayectorias está asociado a lo largo del tiempo. Tomar diferencias entre valores sucesivos recupera pasos independientes, pero entonces la prueba trata sobre los pasos, no sobre los niveles: otra pregunta. Una prueba válida para datos que derivan, no estacionarios, debe incorporar a su referencia la dependencia de esos datos a lo largo del tiempo, y construir una es un problema aparte que este artículo no resuelve.