DEUX CHEMINS AU HASARD QUI SEMBLENT LIÉS
En 1926, Yule remarquait un fait troublant : des séries temporelles totalement indépendantes peuvent présenter de fortes corrélations. Yule les a appelées « corrélations absurdes ». Ses expériences sur des marches au hasard — des suites construites en additionnant des pas aléatoires les uns après les autres — montraient des corrélations bien plus dispersées que ne le voudraient des échantillons indépendants. Des travaux ultérieurs ont prouvé que ces corrélations parasites ne disparaissent pas quand les séries s’allongent.
Liping Zhu et Zhongming Xie, de l’Institut de statistique et de big data de l’université Renmin de Chine, ont cherché à savoir si le problème survit à un outil plus moderne.
Une mesure qui ne devrait pas se laisser piéger
La corrélation ordinaire (de Pearson) ne détecte que les relations en ligne droite. La corrélation de distance, décrite par Székely et ses collègues en 2007, est plus ambitieuse : pour deux variables aléatoires, elle est nulle si et seulement si elles sont indépendantes, quelle que soit la forme de leur lien. Elle est toujours comprise entre 0 et 1.
Mais cette garantie suppose des données tirées indépendamment. Une paire de marches au hasard, c’est autre chose. Chaque pas influence toutes les valeurs suivantes de la marche : les observations successives partagent leur passé, et leur dispersion change sans cesse avec le temps. Des simulations avaient déjà montré de fortes corrélations de distance entre marches indépendantes, attribuées à la dépendance entre observations successives et à leur dispersion changeante ; il manquait une théorie de leur limite.
Une limite strictement entre 0 et 1
Les auteurs démontrent que, quand les marches s’allongent, la corrélation de distance ne tend pas vers zéro. Pour toute marche dont les pas sont indépendants, tirés selon la même loi et pas trop dispersés (de variance finie), elle converge vers une valeur aléatoire donnée par deux chemins browniens, la limite continue des marches au hasard. Cette limite est universelle — elle ne dépend pas de la loi des pas — et se situe strictement entre 0 et 1, en prenant des valeurs sur toute cette plage. La probabilité de voir une corrélation au-dessus de n’importe quel seuil, disons 0,3, ne s’annule donc jamais.
La clé consiste à voir une paire de marches comme un nuage de points : on tire un instant au hasard, on note où se trouvent les deux marches à cet instant, et on recommence. Le nuage enregistre combien de temps la paire passe dans chaque région. Deux marches peuvent être tirées sans aucune influence l’une sur l’autre ; pourtant, une paire donnée, suivie dans le temps, dessine un nuage qui a une forme nette, et c’est cette forme que capte la corrélation de distance.
Simulations : bloquée à 0,5
L’équipe a simulé 2 000 paires de marches indépendantes à pas gaussiens pour chaque longueur de 50 à 5 000 pas. Pour les pas eux-mêmes, la corrélation de distance s’efface comme prévu : de 0,244 à 50 pas à 0,025 à 5 000. Pour les marches construites à partir de ces mêmes pas, elle reste vers 0,5 à toutes les longueurs.
À 5 000 pas, les 90 % centraux des paires de marches s’étalent de 0,215 à 0,844, et 1 644 des 2 000 paires — 82 % — dépassent 0,3. Les auteurs insistent : la valeur proche de 0,5 est un constat empirique, pas une constante démontrée.
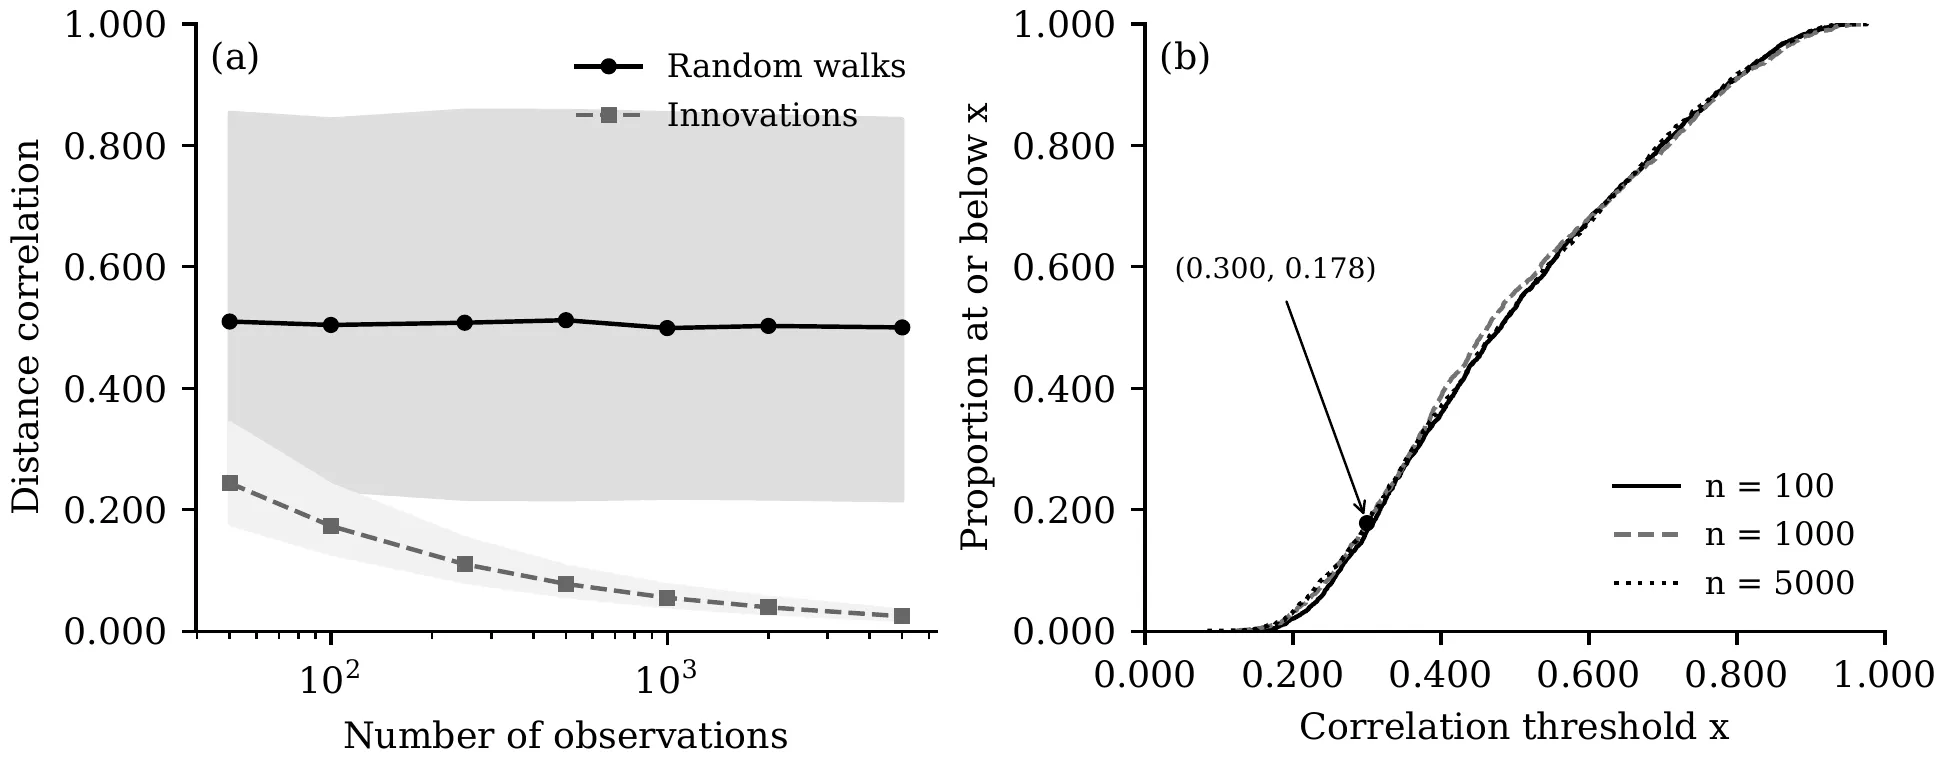
(a) Corrélation de distance moyenne pour les marches au hasard (trait plein) et pour leurs pas indépendants (tirets), avec les bandes de 5 à 95 %, en fonction du nombre d’observations. (b) Part des paires de marches dont la corrélation est inférieure ou égale à chaque seuil, pour 100, 1 000 et 5 000 pas ; le point marqué montre que 17,8 % d’entre elles ne dépassent pas 0,3 à 5 000 pas. — Figure 1, Zhu & Xie (2026), arXiv:2611.16614.
Le test qui crie toujours au loup
La méthode standard pour tester l’indépendance avec la corrélation de distance consiste à mélanger : brouiller de nombreuses fois l’ordre temporel de l’une des séries et voir si la vraie valeur se détache. Les auteurs démontrent que pour des marches au hasard, ce test rejette l’indépendance avec une probabilité qui tend vers 1, quel que soit le niveau d’erreur choisi.
Les simulations le confirment. Au niveau habituel de 5 %, le test par permutation a conclu à tort à un lien pour 94 % des paires de marches indépendantes de 100 pas, et pour les 300 paires de 500 comme de 2 000 pas. Pour les pas indépendants eux-mêmes, il s’est trompé environ 5 % du temps, comme il se doit. Le mélange détruit l’ordre temporel que portent les marches : il construit une référence qui ne décrit pas des marches indépendantes.
Niveaux ou pas ?
L’étude calcule aussi un nombre exact : pour des marches très longues, la moyenne de la covariance de distance au carré, le numérateur brut de la corrélation de distance avant sa mise à l’échelle, vaut 26/(75π) − 1/12, soit environ 0,0270. Les simulations la retrouvent à environ une fois leur propre incertitude statistique près.
Les auteurs en tirent une leçon prudente. Se demander si deux processus sont dépendants n’est pas la même chose que se demander si une paire de chemins observée est associée au fil du temps. Prendre les différences entre valeurs successives redonne des pas indépendants, mais le test porte alors sur les pas, pas sur les niveaux — une autre question. Un test valable pour des données qui dérivent, non stationnaires, doit intégrer leur dépendance dans le temps à sa référence, et en construire un est un problème distinct, que l’article ne résout pas.