সত্তর লাখ মানুষের পছন্দ, মনের একটি ছোট্ট মডেল
এক শতাব্দীরও বেশি সময় ধরে মনোবিজ্ঞান মন কীভাবে কাজ করে তার নানা নীতি তৈরি করেছে। আমরা জানি, জিনিসগুলো একসঙ্গে ঘটলে সংযোগ (association) শক্তিশালী হয়, শেখা চালিত হয় পূর্বাভাস-ত্রুটি দিয়ে — আমরা যা আশা করি আর যা ঘটে তার ফারাক — এবং মস্তিষ্ক তথ্যকে সরল থেকে বিমূর্ত পর্যন্ত স্তরে সাজায়। কিন্তু প্রতিটি নীতি গড়ে উঠেছে বিচ্ছিন্নভাবে, সাধারণত এক ধরনের পরীক্ষার জন্য। সব মিলিয়ে তারা মানুষের আচরণের কতটা ব্যাখ্যা করে? তা কখনো মাপা হয়নি।
হেলমহোলৎস মিউনিখের ইনস্টিটিউট ফর হিউম্যান-সেন্টার্ড AI এবং ট্যুবিঙেনের ম্যাক্স প্লাংক ইনস্টিটিউট ফর বায়োলজিক্যাল সাইবারনেটিক্সের মার্সেল বিন্ৎস ও এরিক শুল্ৎস তা জানতে একটি মডেল তৈরি করেছেন।
স্মৃতি দিয়ে গড়া মন
তাঁদের মডেল CORE (COntextual Retrieval and Encoding, অর্থাৎ প্রেক্ষাপট-নির্ভর পুনরুদ্ধার ও সংকেতায়ন) একটি পরীক্ষার পুরো প্রতিলিপি পড়ে — নির্দেশনা, যা দেখানো হয়েছিল, প্রতিক্রিয়া, অংশগ্রহণকারীর আগের উত্তর — এবং আন্দাজ করে মানুষটি এর পরে কোন কি চাপবেন।
এতে আছে কেবল কয়েকটি প্রতিষ্ঠিত উপাদান:
- লেখাকে ধ্বনিমূলে (phoneme), অর্থাৎ কথার শব্দে, রূপান্তর করা হয়;
- এগুলো একটি ধ্রুপদি শিক্ষণ-নিয়ম মেনে একটি সাহচর্য স্মৃতিতে (associative memory) লেখা হয়;
- কী লেখা হবে, কতটা জোরে, আর কী ভুলে যাওয়া হবে — সবই বর্তমান প্রেক্ষাপটের ওপর নির্ভর করে;
- স্মৃতি কাঁচা ইনপুট নয়, পূর্বাভাস-ত্রুটি জমা রাখে — কেবল সেটুকু যা সে আগে জানত না;
- এমন ছয়টি স্মৃতি স্তরে স্তরে একটির ওপর আরেকটি বসানো।
পুরো মডেলে ৪,৫২,৬০৮টি প্যারামিটার, আর একটিমাত্র গ্রাফিক্স কার্ডে প্রায় ২৪ ঘণ্টায় এটি প্রশিক্ষিত হয়েছে।
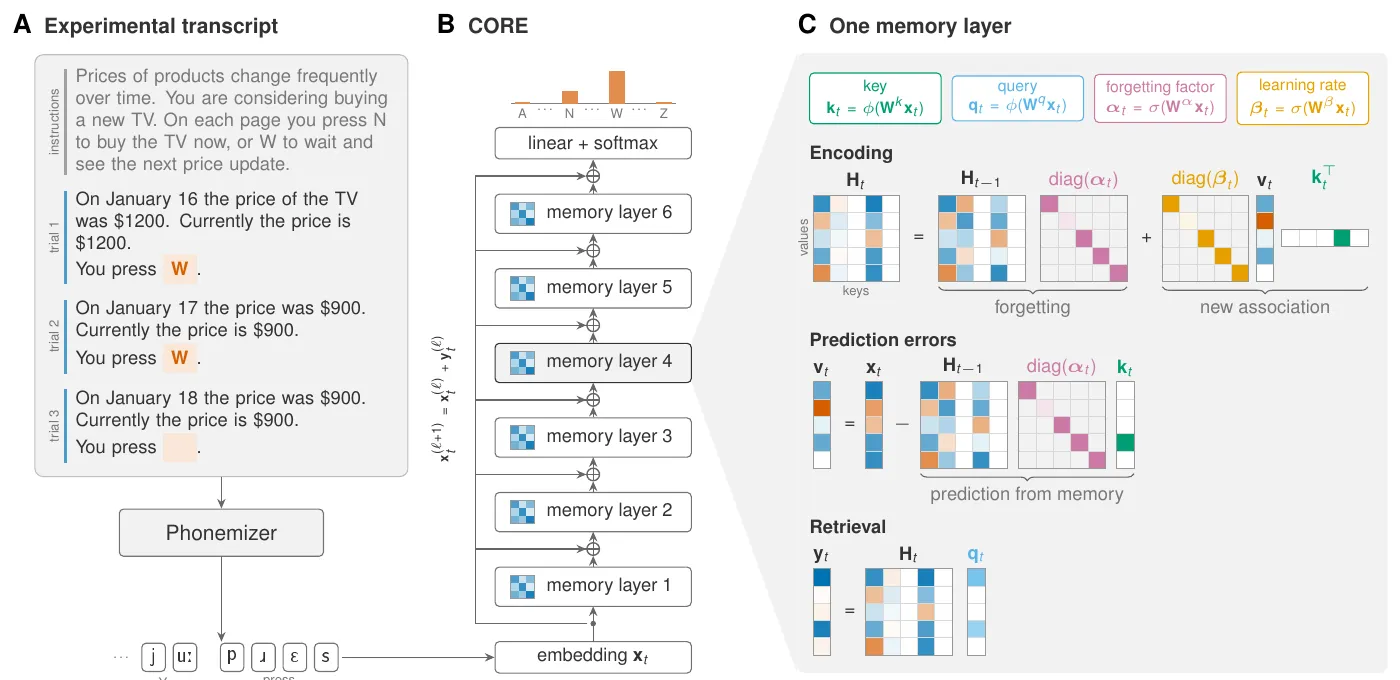
CORE কীভাবে কাজ করে: একটি প্রতিলিপি (A) স্মৃতি-স্তরের একটি স্তূপে (B) যায়; প্রতিটি স্তর প্রেক্ষাপট অনুযায়ী সংযোগ লেখে, ভোলে ও পুনরুদ্ধার করে (C)। — চিত্র ১, Binz & Schulz (2026), arXiv:2610.13603.
সত্তর লাখ পছন্দের সামনে পরীক্ষা
তাঁরা CORE-কে ফিট করেছেন Psych-201-এর ওপর, যা মনোবিজ্ঞান-পরীক্ষার একটি বড় সংগ্রহ: ৬২টি গবেষণার ১৩৭টি পরীক্ষা, যার মধ্যে আছে পুরস্কার থেকে শেখা, ঝুঁকির মধ্যে সিদ্ধান্ত, শ্রেণি শেখা, সামাজিক বিচার এবং আরও অনেক কিছু — প্রশিক্ষণের জন্য ৮০,৪৫২টি সেশনে ৭০,৩৬,৪৪২টি পছন্দ, আর কিছু সেশন পরীক্ষার জন্য আলাদা রাখা।
- যে সেশনগুলো সে আগে কখনো দেখেনি, সেগুলোতে CORE ৬২টি গবেষণার সবকটিতেই একই আকারের একটি প্রমিত AI কাঠামোর (Transformer) চেয়ে ভালোভাবে পছন্দ আন্দাজ করেছে।
- সামগ্রিকভাবে এটি Centaur-কেও ছাড়িয়ে গেছে — মানুষের আচরণে ফাইন-টিউন করা একটি বড় ভাষা মডেল, যার প্যারামিটার পাঁচ মাত্রাক্রম (orders of magnitude) বেশি — ৬২টির মধ্যে ৪৭টি গবেষণায় জিতে।
- যেকোনো একটি উপাদান সরালেই মডেল খারাপ হয়েছে। সবচেয়ে বেশি গুরুত্বপূর্ণ ছিল স্তর, তারপর ভুলে যাওয়া, তারপর ধ্বনিমূল, তারপর পূর্বাভাস-ত্রুটি।
যেন এক ভার্চুয়াল অংশগ্রহণকারী
ডেটার সঙ্গে মিলে যাওয়াই যথেষ্ট নয়: মনের মডেলকে মানুষের মতো আচরণও করতে হবে। লেখকেরা মূল পরীক্ষাগুলোতে CORE-কে একজন অংশগ্রহণকারী হিসেবে সিমুলেট করে দেখেছেন প্রকাশিত প্রভাবগুলো আবার দেখা যায় কি না। এটি ৬৭টির মধ্যে ৫০টি প্রভাব (৭৫%) পুনরুৎপাদন করেছে।
এটি সবচেয়ে ভালো করেছে অন্বেষণে (১১-র মধ্যে ১১) আর পুরস্কার থেকে শেখায় (১১-র মধ্যে ১০), সবচেয়ে খারাপ ভাষা আর সামাজিক বিচারে (১২-র মধ্যে ৭)। লেখকেরা ব্যর্থতাগুলোর ব্যাখ্যা দেন: এসব কাজের অনেকগুলোই নির্ভর করে শব্দ, সংখ্যা আর জগৎ সম্পর্কে এমন জ্ঞানের ওপর, যা মানুষ গবেষণাগারের বাইরে অর্জন করে — আর CORE কেবল পরীক্ষার প্রতিলিপিই দেখেছে। আগে থেকে পরিকল্পনা করতেও এর অসুবিধা হয়, কারণ এর জন্য তার কোনো কৌশল নেই। যে প্রভাবগুলো সে ধরতে পারেনি, তার কয়েকটি মানুষের ডেটাতেও ভঙ্গুর বলে দেখা গেছে।
এর ভেতরের সেটিংসও মনস্তাত্ত্বিক দেখায়। একটি খেলার মধ্যে, প্রমাণ জমার সঙ্গে সঙ্গে এর শেখার হার কমে, ঠিক যেমন শেখার বেইজীয় তত্ত্ব বলে। আর এর স্মৃতির পরিসর একটি খেলার সময় বাড়ে, তারপর পরের খেলার সীমানায় এসে ধসে পড়ে — মানুষ যেভাবে অভিজ্ঞতাকে ঘটনায় ভাগ করে, এটি তারই চিহ্ন।
স্বার্থের সংঘাত। ডেটা-প্রক্রিয়া AI-এর ওপর নির্ভর করেছে: প্রতিটি পরীক্ষাকে DeepSeek-V4-Flash প্রতিলিপিতে রূপান্তর করেছে এবং Anthropic-এর Claude Fable 5.1 তা যাচাই করেছে; প্রভাবগুলো পরীক্ষার সিমুলেটরগুলোও একটি স্বয়ংক্রিয় AI প্রক্রিয়ায় তৈরি। এই প্রবন্ধটি লিখেছে Claude। তা ছাড়া, প্রতিদ্বন্দ্বী হিসেবে ব্যবহৃত Centaur মডেল আর Psych-201 সংগ্রহ — দুটোই প্রথম লেখকের নেতৃত্বে করা আগের কাজ। লেখকেরা কোনো প্রতিদ্বন্দ্বী স্বার্থ নেই বলে ঘোষণা করেছেন।
মনের একটি সাধারণ মডেলের দিকে
লেখকেরা CORE-কে ধ্রুপদি জ্ঞানীয় মডেল আর ব্ল্যাক বক্সের মাঝামাঝি একটি পদক্ষেপ হিসেবে বর্ণনা করেন: এর নীতিগুলো পড়া যায়, কিন্তু যে খুঁটিনাটি এটি শেখে তা নয়। এর দীর্ঘমেয়াদি স্মৃতি নেই, কারণ পরীক্ষাগুলো এক ঘণ্টার কম চলে। তাঁদের লক্ষ্য একটি মডেলের চেয়ে বড়: মনের তত্ত্বগুলোকে মনোবিজ্ঞানের পুরো পরীক্ষামূলক নথির সামনে একসঙ্গে যাচাই করা, যাতে এই ক্ষেত্রটি “তার পরীক্ষাগুলোর যোগফলের চেয়েও বেশি” হয়ে ওঠে।