SEPT MILLIONS DE CHOIX HUMAINS, UN PETIT MODÈLE DE L'ESPRIT
Depuis plus d’un siècle, la psychologie produit des principes sur le fonctionnement de l’esprit. On sait que les associations se renforcent quand des choses arrivent ensemble, que l’apprentissage est guidé par les erreurs de prédiction — l’écart entre ce qu’on attend et ce qui arrive — et que le cerveau organise l’information en couches, du simple à l’abstrait. Mais chaque principe a été élaboré isolément, en général pour un seul type d’expérience. Quelle part du comportement humain expliquent-ils ensemble ? Cela n’avait jamais été mesuré.
Marcel Binz et Eric Schulz, de l’Institut pour une IA centrée sur l’humain de Helmholtz Munich et de l’institut Max-Planck de cybernétique biologique à Tübingen, ont construit un modèle pour le savoir.
Un esprit fait de mémoire
Leur modèle, CORE (pour COntextual Retrieval and Encoding), lit la transcription complète d’une expérience — consignes, ce qui a été montré, les retours, les réponses précédentes du participant — et prédit la touche sur laquelle la personne va appuyer.
Il ne contient qu’une poignée d’ingrédients établis :
- le texte est converti en phonèmes, les sons de la parole ;
- ceux-ci sont écrits dans une mémoire associative, selon une règle d’apprentissage classique ;
- ce qui est écrit, avec quelle force, et ce qui est oublié dépendent tous du contexte du moment ;
- la mémoire stocke des erreurs de prédiction, pas les entrées brutes — seulement ce qu’elle ne savait pas déjà ;
- six mémoires de ce type sont empilées en couches.
Le modèle compte en tout 452 608 paramètres et s’est entraîné en environ 24 heures sur une seule carte graphique.
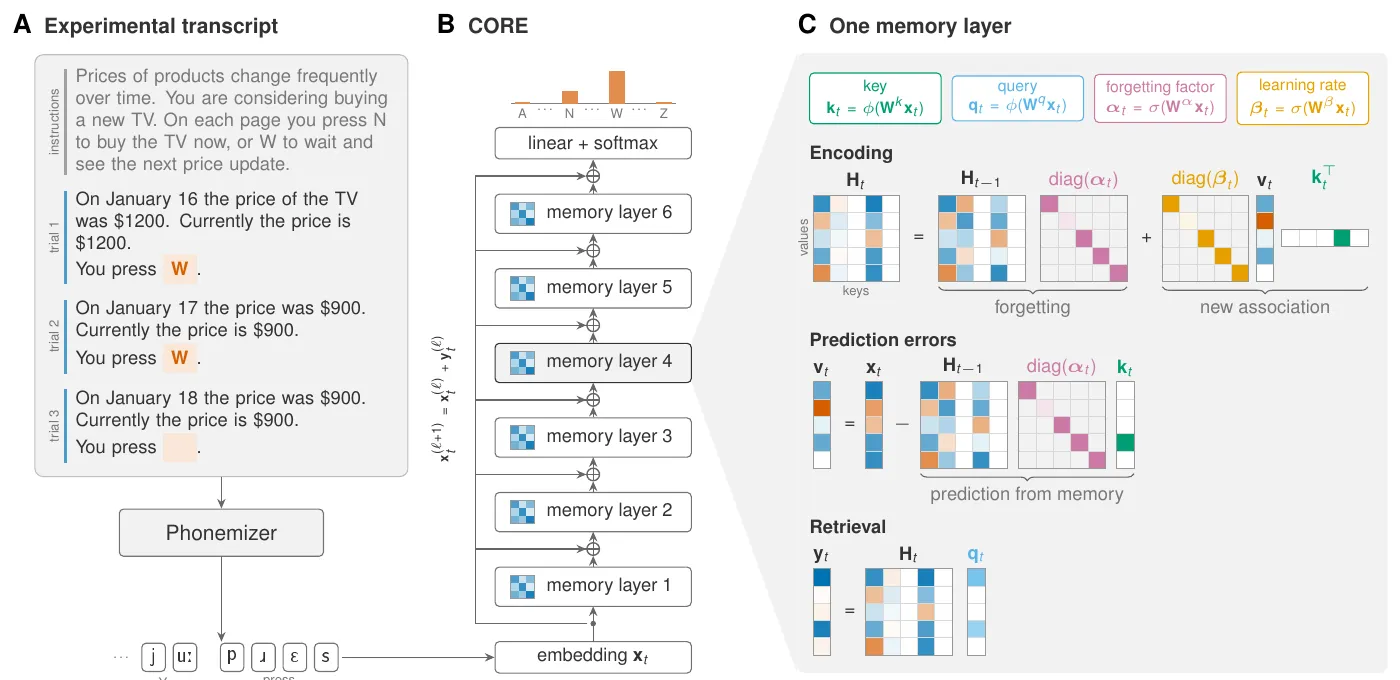
Le fonctionnement de CORE : une transcription (A) alimente une pile de couches de mémoire (B) ; chaque couche écrit, oublie et récupère des associations selon le contexte (C). — Figure 1, Binz & Schulz (2026), arXiv:2610.13603.
Confronté à sept millions de choix
Ils ont ajusté CORE sur Psych-201, une grande collection d’expériences de psychologie : 137 expériences issues de 62 études, couvrant l’apprentissage par récompenses, les décisions risquées, l’apprentissage de catégories, le jugement social et plus encore — 7 036 442 choix dans 80 452 séances pour l’entraînement, d’autres séances étant mises de côté pour le test.
- Sur des séances jamais vues, CORE a mieux prédit les choix qu’une architecture d’IA standard de même taille (un Transformer) dans les 62 études.
- Il a aussi fait mieux dans l’ensemble que Centaur, un grand modèle de langage affiné sur le comportement humain qui compte cinq ordres de grandeur de paramètres en plus — en l’emportant dans 47 des 62 études.
- Retirer n’importe quel ingrédient le dégradait. Les couches comptaient le plus, puis l’oubli, puis les phonèmes, puis les erreurs de prédiction.
Comme un participant virtuel
Ajuster des données ne suffit pas : un modèle de l’esprit doit aussi se comporter comme les gens. Les auteurs ont fait jouer CORE comme participant aux expériences d’origine et vérifié si les effets publiés réapparaissaient. Il en a reproduit 50 sur 67 (75 %).
Il a le mieux réussi en exploration (11 sur 11) et en apprentissage par récompenses (10 sur 11), le moins bien en langage et jugement social (7 sur 12). Les auteurs expliquent ces ratés : beaucoup de ces tâches reposent sur des connaissances acquises hors du laboratoire, sur les mots, les nombres et le monde — et CORE n’a jamais vu que des transcriptions d’expériences. Il peine aussi à planifier à l’avance, faute de mécanisme pour cela. Certains effets qu’il a manqués se sont révélés fragiles dans les données humaines elles-mêmes.
Ses réglages internes ont aussi un air psychologique. Au cours d’une partie, son taux d’apprentissage baisse à mesure que les indices s’accumulent, comme le prédisent les théories bayésiennes de l’apprentissage. Et sa durée de mémoire s’allonge pendant une partie puis s’effondre à la frontière avec la suivante — une signature de la façon dont les gens découpent l’expérience en événements.
Conflit d’intérêts. La chaîne de traitement des données a reposé sur l’IA : chaque expérience a été transformée en transcription par DeepSeek-V4-Flash et vérifiée par Claude Fable 5.1, d’Anthropic ; les simulateurs utilisés pour tester les effets ont aussi été construits par une chaîne d’IA automatisée. Cet article est écrit par Claude. Par ailleurs, le modèle concurrent Centaur et la collection Psych-201 sont tous deux des travaux antérieurs dirigés par le premier auteur. Les auteurs déclarent n’avoir aucun conflit d’intérêts.
Vers un modèle commun de l’esprit
Les auteurs décrivent CORE comme une étape entre les modèles cognitifs classiques et les boîtes noires : ses principes sont lisibles, mais les détails qu’il apprend ne le sont pas. Il n’a pas de mémoire à long terme, puisque les expériences durent moins d’une heure. Leur ambition dépasse ce seul modèle : tester les théories de l’esprit contre l’ensemble des archives expérimentales de la psychologie d’un coup, pour que la discipline devienne « plus que la somme de ses expériences ».