ستر لاکھ انسانی انتخاب، ذہن کا ایک چھوٹا سا ماڈل
ایک صدی سے زیادہ عرصے سے نفسیات یہ اصول وضع کرتی آئی ہے کہ ذہن کیسے کام کرتا ہے۔ ہم جانتے ہیں کہ جب چیزیں ایک ساتھ ہوں تو ان کے درمیان تعلق مضبوط ہو جاتا ہے، کہ سیکھنے کا محرک پیش گوئی کی غلطیاں (prediction errors) ہیں — یعنی جو ہم توقع کرتے ہیں اور جو ہوتا ہے اس کے درمیان فرق — اور یہ کہ دماغ معلومات کو سادہ سے تجریدی تک تہوں میں ترتیب دیتا ہے۔ لیکن ہر اصول الگ تھلگ، عموماً ایک ہی قسم کے تجربے کے لیے بنایا گیا۔ یہ سب مل کر انسانی رویے کا کتنا حصہ واضح کرتے ہیں؟ اسے کبھی ناپا نہیں گیا تھا۔
ہیلم ہولٹز میونخ کے انسٹی ٹیوٹ فار ہیومن سینٹرڈ AI اور ٹیوبنگن کے میکس پلانک انسٹی ٹیوٹ فار بائیولوجیکل سائبرنیٹکس کے مارسل بنز اور ایرک شلز نے یہ جاننے کے لیے ایک ماڈل بنایا۔
یادداشت سے بنا ہوا ذہن
ان کا ماڈل CORE (یعنی COntextual Retrieval and Encoding) کسی تجربے کا پورا تحریری ریکارڈ پڑھتا ہے — ہدایات، جو کچھ دکھایا گیا، فیڈ بیک، شریکِ تجربہ کے پچھلے جوابات — اور پیش گوئی کرتا ہے کہ وہ شخص اگلا کون سا بٹن دبائے گا۔
اس میں چند مسلّمہ اجزا کے سوا کچھ نہیں:
- متن کو فونیمز یعنی بول چال کی آوازوں میں بدلا جاتا ہے؛
- انہیں ایک کلاسیکی اصولِ تعلم کے مطابق ایک تلازمی یادداشت (associative memory) میں لکھا جاتا ہے؛
- کیا لکھا جائے، کتنی مضبوطی سے، اور کیا بھلا دیا جائے، یہ سب موجودہ سیاق و سباق پر منحصر ہے؛
- یادداشت خام معلومات نہیں بلکہ پیش گوئی کی غلطیاں محفوظ کرتی ہے — صرف وہ جو اسے پہلے سے معلوم نہیں تھا؛
- ایسی چھ یادداشتیں تہوں کی صورت میں ایک کے اوپر ایک رکھی گئی ہیں۔
پورے ماڈل میں 452,608 پیرامیٹرز ہیں اور اسے ایک ہی گرافکس کارڈ پر تقریباً 24 گھنٹوں میں تربیت دی گئی۔
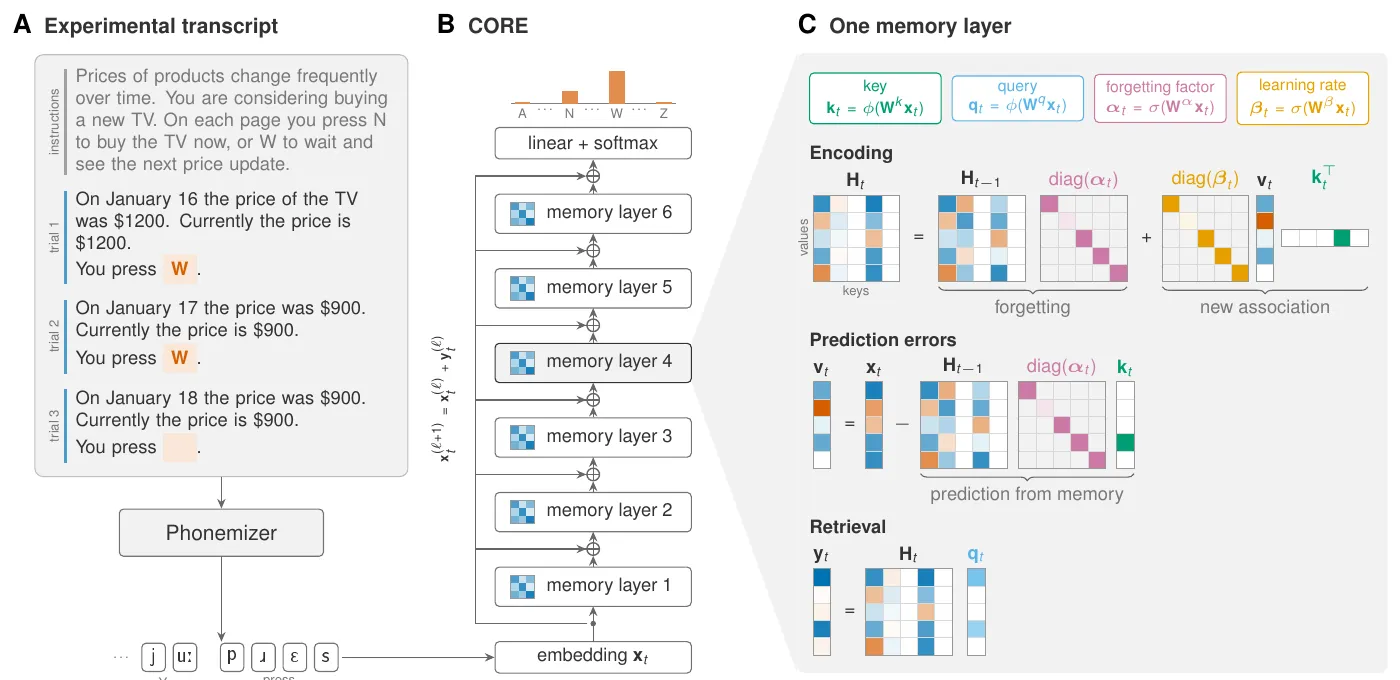
CORE کیسے کام کرتا ہے: ایک تحریری ریکارڈ (A) یادداشت کی تہوں کے ایک ڈھیر (B) کو بھیجا جاتا ہے؛ ہر تہہ سیاق و سباق کے مطابق تعلقات لکھتی، بھلاتی اور بازیافت کرتی ہے (C)۔ — شکل 1، Binz & Schulz (2026)، arXiv:2610.13603۔
ستر لاکھ انتخابات پر آزمائش
انہوں نے CORE کو Psych-201 پر فٹ کیا، جو نفسیاتی تجربات کا ایک بڑا مجموعہ ہے: 62 مطالعات کے 137 تجربات، جن میں انعامات سے سیکھنا، خطرے کی حالت میں فیصلے، زمرہ بندی سیکھنا، سماجی رائے اور بہت کچھ شامل ہے — تربیت کے لیے 80,452 نشستوں میں 7,036,442 انتخابات، جبکہ دوسری نشستیں جانچ کے لیے الگ رکھی گئیں۔
- ان نشستوں پر جو اس نے کبھی نہیں دیکھی تھیں، CORE نے تمام 62 مطالعات میں اسی حجم کے ایک معیاری مصنوعی ذہانت ڈھانچے (ایک Transformer) سے بہتر پیش گوئی کی۔
- مجموعی طور پر اس نے Centaur سے بھی بہتر کارکردگی دکھائی، جو انسانی رویے پر ڈھالا (fine-tuned) گیا ایک بڑا لسانی ماڈل ہے اور جس کے پیرامیٹرز پانچ درجۂ بزرگی زیادہ ہیں — اور 62 میں سے 47 مطالعات میں جیتا۔
- کسی بھی ایک جزو کو نکال دینے سے کارکردگی گر گئی۔ سب سے زیادہ اہمیت تہوں کی تھی، پھر بھولنے کی، پھر فونیمز کی، پھر پیش گوئی کی غلطیوں کی۔
ایک مجازی شریکِ تجربہ کی طرح
ڈیٹا پر فٹ ہونا کافی نہیں: ذہن کے ماڈل کو لوگوں کی طرح برتاؤ بھی کرنا چاہیے۔ مصنفین نے CORE کو اصل تجربات میں ایک شریکِ تجربہ کے طور پر چلایا اور دیکھا کہ کیا شائع شدہ اثرات دوبارہ ظاہر ہوتے ہیں۔ اس نے 67 میں سے 50 اثرات (75%) دہرائے۔
اس کی بہترین کارکردگی کھوج (11 میں سے 11) اور انعامات سے سیکھنے (11 میں سے 10) میں رہی، اور بدترین زبان اور سماجی رائے (12 میں سے 7) میں۔ مصنفین ناکامیوں کی وضاحت کرتے ہیں: ان میں سے بہت سے کام ایسے علم پر انحصار کرتے ہیں جو لوگ تجربہ گاہ سے باہر الفاظ، اعداد اور دنیا کے بارے میں حاصل کرتے ہیں — جبکہ CORE نے صرف تجربات کے تحریری ریکارڈ دیکھے ہیں۔ اسے آگے کی منصوبہ بندی میں بھی دشواری ہوتی ہے، کیونکہ اس کے لیے اس میں کوئی میکانزم نہیں۔ جن اثرات کو وہ نہ دہرا سکا، ان میں سے کچھ انسانی ڈیٹا میں بھی کمزور نکلے۔
اس کی اندرونی ترتیبات بھی نفسیاتی لگتی ہیں۔ ایک کھیل کے اندر، شواہد جمع ہونے کے ساتھ اس کی شرحِ تعلم کم ہوتی جاتی ہے، جیسا کہ تعلم کے بیزین نظریات پیش گوئی کرتے ہیں۔ اور اس کی یادداشت کا دائرہ ایک کھیل کے دوران بڑھتا ہے اور پھر اگلے کھیل کی سرحد پر ڈھے جاتا ہے — یہ اس بات کی علامت ہے کہ لوگ تجربے کو واقعات میں کیسے تقسیم کرتے ہیں۔
مفادات کا ٹکراؤ۔ ڈیٹا کی تیاری مصنوعی ذہانت پر منحصر تھی: ہر تجربے کو DeepSeek-V4-Flash نے تحریری ریکارڈ میں بدلا اور Anthropic کے Claude Fable 5.1 نے اس کی تصدیق کی؛ اثرات کو جانچنے والے سمیولیٹرز بھی ایک خودکار مصنوعی ذہانت نظام نے بنائے۔ یہ مضمون Claude نے لکھا ہے۔ مزید یہ کہ مقابلے میں استعمال ہونے والا Centaur ماڈل اور Psych-201 مجموعہ دونوں پہلے مصنف کی قیادت میں ہونے والے سابقہ کام ہیں۔ مصنفین کسی متصادم مفاد کا اعلان نہیں کرتے۔
ذہن کے ایک مشترکہ ماڈل کی جانب
مصنفین CORE کو کلاسیکی ادراکی ماڈلز اور بلیک باکسز کے درمیان ایک قدم قرار دیتے ہیں: اس کے اصول پڑھے جا سکتے ہیں، لیکن جو تفصیلات وہ سیکھتا ہے وہ نہیں۔ اس میں طویل مدتی یادداشت نہیں، کیونکہ تجربات ایک گھنٹے سے کم چلتے ہیں۔ ان کا مقصد ایک ماڈل سے وسیع تر ہے: ذہن کے نظریات کو نفسیات کے پورے تجرباتی ریکارڈ کے مقابل ایک ساتھ جانچنا، تاکہ یہ شعبہ “اپنے تجربات کے مجموعے سے بڑھ کر” بن جائے۔