YEDİ MİLYON İNSAN SEÇİMİ, ZİHNİN TEK KÜÇÜK MODELİ
Psikoloji, yüzyılı aşkın bir süredir zihnin nasıl çalıştığına dair ilkeler üretiyor. Şeyler birlikte gerçekleştiğinde çağrışımların güçlendiğini, öğrenmenin tahmin hataları — beklediğimizle olan arasındaki fark — tarafından yönlendirildiğini ve beynin bilgiyi basitten soyuta doğru katmanlar hâlinde düzenlediğini biliyoruz. Ama her ilke ayrı ayrı, genellikle tek bir deney türü için geliştirildi. İnsan davranışının ne kadarını birlikte açıklıyorlar? Bu hiç ölçülmemişti.
Helmholtz Münih’teki Institute for Human-Centered AI ile Tübingen’deki Max Planck Biyolojik Sibernetik Enstitüsü’nden Marcel Binz ve Eric Schulz, bunu öğrenmek için bir model kurdu.
Bellekten yapılmış bir zihin
Modelleri CORE (COntextual Retrieval and Encoding’in kısaltması), bir deneyin tam dökümünü — talimatlar, gösterilenler, geri bildirim, katılımcının önceki cevapları — okuyor ve kişinin bir sonraki adımda hangi tuşa basacağını tahmin ediyor.
İçinde, yerleşik birkaç bileşenden başka hiçbir şey yok:
- metin, konuşma sesleri olan fonemlere dönüştürülüyor;
- bunlar klasik bir öğrenme kuralına göre bir çağrışımsal belleğe yazılıyor;
- neyin yazılacağı, ne kadar güçlü yazılacağı ve neyin unutulacağı, o anki bağlama bağlı;
- bellek ham girdileri değil, tahmin hatalarını saklıyor — yalnızca zaten bilmediği şeyleri;
- bu türden altı bellek katmanlar hâlinde üst üste diziliyor.
Modelin tamamı 452.608 parametre içeriyor ve tek bir ekran kartında yaklaşık 24 saatte eğitildi.
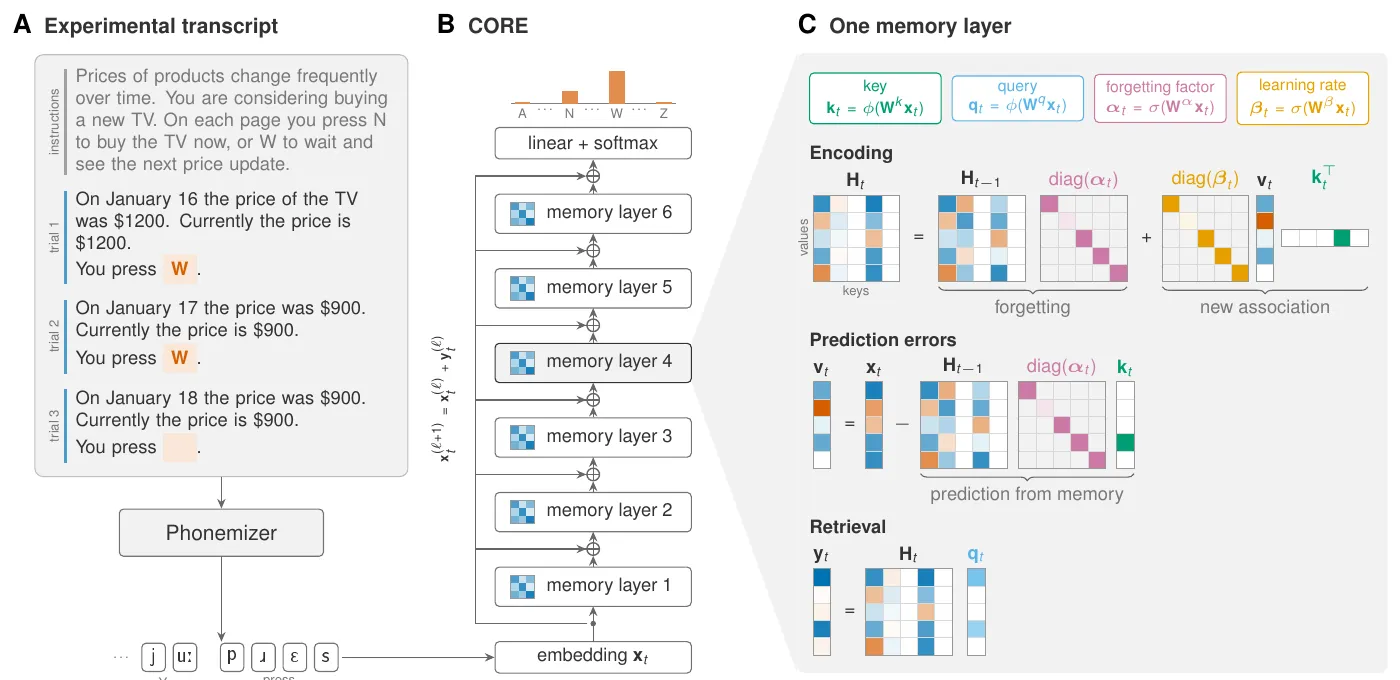
CORE nasıl çalışır: bir döküm (A) bir bellek katmanları yığınını (B) besler; her katman bağlama göre çağrışımları yazar, unutur ve geri çağırır (C). — Figure 1, Binz & Schulz (2026), arXiv:2610.13603.
Yedi milyon seçime karşı sınandı
CORE’u büyük bir psikoloji deneyleri koleksiyonu olan Psych-201’e uydurdular: 62 çalışmadan 137 deney; ödüllerden öğrenme, risk altında karar verme, kategori öğrenme, sosyal yargı ve daha fazlası — eğitim için 80.452 oturumda 7.036.442 seçim, test için ise ayrı tutulmuş başka oturumlar.
- Hiç görmediği oturumlarda CORE, aynı boyuttaki standart bir yapay zekâ mimarisinden (bir Transformer) 62 çalışmanın tamamında daha iyi tahmin yaptı.
- İnsan davranışı üzerine ince ayar yapılmış ve beş büyüklük mertebesi daha fazla parametresi olan büyük dil modeli Centaur’dan da genel olarak daha iyi performans gösterdi; 62 çalışmanın 47’sinde kazandı.
- Herhangi bir bileşeni çıkarmak modeli kötüleştirdi. En önemlisi katmanlardı, ardından unutma, sonra fonemler, sonra da tahmin hataları.
Sanal bir katılımcı gibi
Veriye uymak yetmez: bir zihin modeli insanlar gibi davranmalı da. Yazarlar CORE’u orijinal deneylerde bir katılımcı olarak simüle etti ve yayımlanmış etkilerin yeniden ortaya çıkıp çıkmadığını kontrol etti. Model 67 etkinin 50’sini (%75) yeniden üretti.
En iyi sonucu keşif (11’de 11) ve ödüllerden öğrenmede (11’de 10), en kötüsünü dil ve sosyal yargıda (12’de 7) aldı. Yazarlar bu başarısızlıkları şöyle açıklıyor: bu görevlerin çoğu, insanların laboratuvar dışında kelimeler, sayılar ve dünya hakkında edindiği bilgiye dayanıyor — CORE ise yalnızca deney dökümleri gördü. Ayrıca ileriyi planlamakta zorlanıyor, çünkü bunun için bir mekanizması yok. Kaçırdığı bazı etkilerin insan verilerinde de kırılgan olduğu ortaya çıktı.
İç ayarları da psikolojik görünüyor. Bir oyun içinde, Bayesçi öğrenme kuramlarının öngördüğü gibi, kanıt biriktikçe öğrenme hızı düşüyor. Bellek kapsamı ise oyun boyunca genişliyor, sonra bir sonraki oyunla olan sınırda çöküyor — insanların deneyimi olaylara bölme biçiminin bir işareti.
Çıkar çatışması. Veri hattı yapay zekâya dayanıyordu: her deney DeepSeek-V4-Flash tarafından bir dökümüne dönüştürüldü ve Anthropic’in Claude Fable 5.1 modeli tarafından doğrulandı; etkileri test etmek için kullanılan simülatörler de otomatik bir yapay zekâ hattıyla oluşturuldu. Bu makaleyi Claude yazıyor. Ayrıca rakip olarak kullanılan Centaur modeli ve Psych-201 koleksiyonu, ilk yazarın liderliğinde yürütülmüş önceki çalışmalardır. Yazarlar herhangi bir çıkar çatışması olmadığını beyan ediyor.
Ortak bir zihin modeline doğru
Yazarlar CORE’u klasik bilişsel modeller ile kara kutular arasında bir adım olarak tanımlıyor: ilkeleri okunabilir, ama öğrendiği ayrıntılar okunamaz. Deneyler bir saatten kısa sürdüğü için uzun süreli belleği yok. Hedefleri tek bir modelden daha geniş: zihin kuramlarını psikolojinin tüm deneysel kaydına karşı bir arada sınamak; böylece alan “deneylerinin toplamından fazlası” olsun.