सत्तर लाख मानवीय चुनाव, मन का एक छोटा-सा मॉडल
सौ से ज़्यादा वर्षों से मनोविज्ञान ने मन के काम करने के सिद्धांत दिए हैं। हम जानते हैं कि जब चीज़ें साथ-साथ होती हैं तो संबंध (associations) मज़बूत होते हैं, कि सीखना पूर्वानुमान-त्रुटियों से चलता है — यानी हमारी अपेक्षा और असल में हुई घटना के बीच का अंतर — और कि मस्तिष्क जानकारी को सरल से अमूर्त तक परतों में व्यवस्थित करता है। लेकिन हर सिद्धांत अलग-थलग विकसित हुआ, आमतौर पर एक ही तरह के प्रयोग के लिए। ये मिलकर मानव व्यवहार का कितना हिस्सा समझाते हैं? यह कभी मापा नहीं गया था।
हेल्महोल्ट्ज़ म्यूनिख के इंस्टीट्यूट फ़ॉर ह्यूमन-सेंटर्ड AI और ट्यूबिंगन के मैक्स प्लांक इंस्टीट्यूट फ़ॉर बायोलॉजिकल साइबरनेटिक्स के मार्सेल बिन्ज़ और एरिक शुल्ज़ ने इसका पता लगाने के लिए एक मॉडल बनाया।
स्मृति से बना मन
उनका मॉडल, CORE (COntextual Retrieval and Encoding यानी संदर्भगत पुनर्प्राप्ति और कूटन), किसी प्रयोग की पूरी प्रतिलिपि पढ़ता है — निर्देश, जो दिखाया गया, प्रतिक्रिया, प्रतिभागी के पिछले उत्तर — और अनुमान लगाता है कि व्यक्ति अगली बार कौन-सी कुंजी दबाएगा।
इसमें कुछ स्थापित घटकों के अलावा और कुछ नहीं है:
- पाठ को स्वनिमों (phonemes), यानी बोली की ध्वनियों में बदला जाता है;
- इन्हें एक क्लासिक सीखने के नियम के अनुसार एक साहचर्य स्मृति (associative memory) में लिखा जाता है;
- क्या लिखा जाए, कितनी मज़बूती से, और क्या भुलाया जाए — यह सब मौजूदा संदर्भ पर निर्भर करता है;
- स्मृति कच्चे इनपुट नहीं, बल्कि पूर्वानुमान-त्रुटियाँ सहेजती है — सिर्फ़ वही जो उसे पहले से पता नहीं था;
- ऐसी छह स्मृतियाँ परतों में एक के ऊपर एक रखी गई हैं।
पूरे मॉडल में 4,52,608 मापदंड (parameters) हैं और इसे एक ही ग्राफ़िक्स कार्ड पर लगभग 24 घंटे में प्रशिक्षित किया गया।
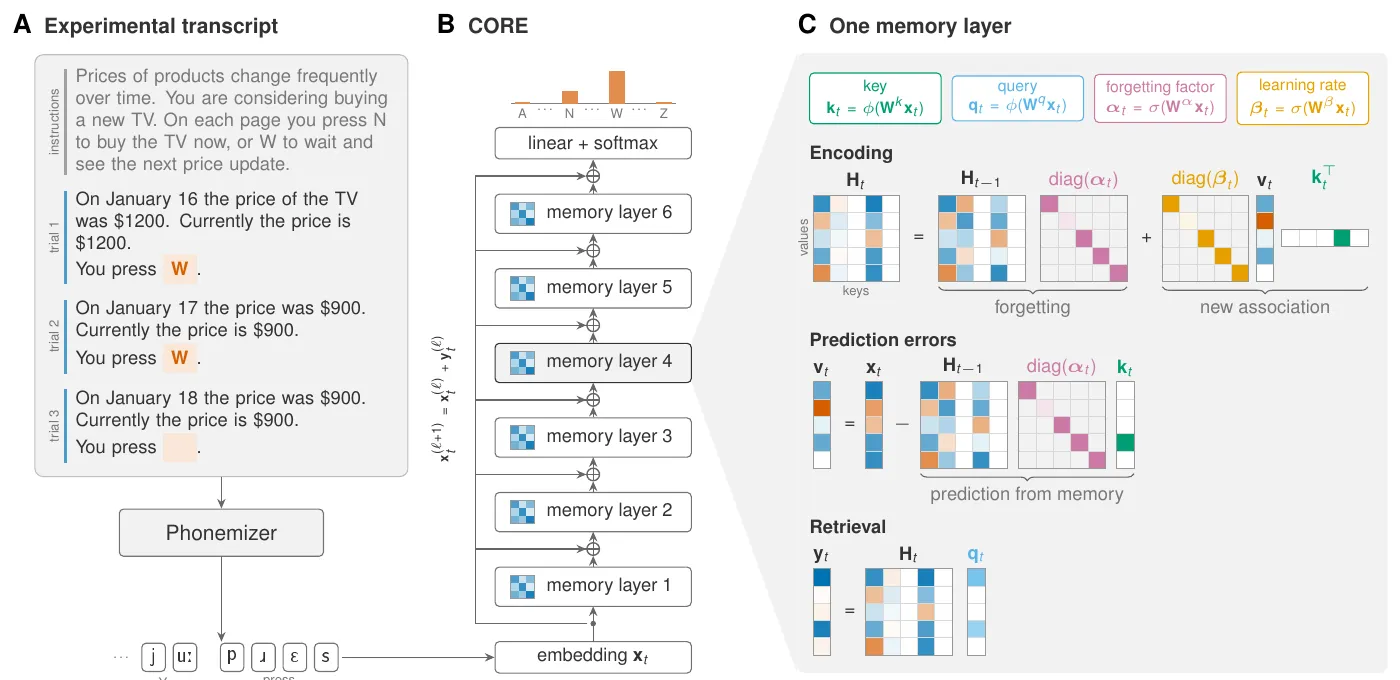
CORE कैसे काम करता है: एक प्रतिलिपि (A) स्मृति-परतों के ढेर (B) को भरती है; हर परत संदर्भ के अनुसार संबंधों को लिखती, भूलती और पुनः प्राप्त करती है (C)। — चित्र 1, Binz & Schulz (2026), arXiv:2610.13603.
सत्तर लाख चुनावों पर परीक्षा
उन्होंने CORE को Psych-201 पर फ़िट किया, जो मनोविज्ञान प्रयोगों का एक बड़ा संग्रह है: 62 अध्ययनों के 137 प्रयोग, जिनमें पुरस्कार से सीखना, जोखिम में निर्णय, श्रेणी सीखना, सामाजिक आकलन और भी बहुत कुछ शामिल है — प्रशिक्षण के लिए 80,452 सत्रों के 70,36,442 चुनाव, और कुछ अन्य सत्र परीक्षण के लिए अलग रखे गए।
- जिन सत्रों को उसने कभी नहीं देखा था, उन पर CORE ने सभी 62 अध्ययनों में उसी आकार के एक मानक AI ढाँचे (Transformer) से बेहतर चुनावों की भविष्यवाणी की।
- कुल मिलाकर इसने Centaur से भी बेहतर प्रदर्शन किया — मानव व्यवहार पर फ़ाइन-ट्यून किया गया एक बड़ा भाषा मॉडल, जिसमें पाँच कोटि (orders of magnitude) ज़्यादा मापदंड हैं — और 62 में से 47 अध्ययनों में जीता।
- किसी भी एक घटक को हटाने पर मॉडल बदतर हो गया। सबसे ज़्यादा फ़र्क़ परतों का था, फिर भूलने का, फिर स्वनिमों का, फिर पूर्वानुमान-त्रुटियों का।
एक आभासी प्रतिभागी की तरह
डेटा पर फ़िट होना काफ़ी नहीं है: मन के मॉडल को लोगों की तरह व्यवहार भी करना चाहिए। लेखकों ने मूल प्रयोगों में CORE को एक प्रतिभागी के रूप में सिम्युलेट किया और देखा कि प्रकाशित प्रभाव फिर से दिखते हैं या नहीं। इसने 67 में से 50 प्रभाव (75%) दोहराए।
इसने सबसे अच्छा प्रदर्शन अन्वेषण (11 में से 11) और पुरस्कार से सीखने (11 में से 10) में किया, और सबसे कमज़ोर भाषा और सामाजिक आकलन (12 में से 7) में। लेखक इन चूकों की वजह बताते हैं: इनमें से कई कार्य उस ज्ञान पर निर्भर हैं जो लोग प्रयोगशाला के बाहर शब्दों, संख्याओं और दुनिया के बारे में हासिल करते हैं — और CORE ने केवल प्रयोगों की प्रतिलिपियाँ ही देखी हैं। उसे आगे की योजना बनाने में भी कठिनाई होती है, जिसके लिए उसमें कोई तंत्र नहीं है। जिन कुछ प्रभावों को वह नहीं दोहरा पाया, वे मानव डेटा में भी कमज़ोर निकले।
उसकी आंतरिक सेटिंग्स भी मनोवैज्ञानिक लगती हैं। एक खेल के भीतर, सबूत जमा होने के साथ उसकी सीखने की दर घटती है, जैसा सीखने के बेयसियन सिद्धांत बताते हैं। और उसकी स्मृति-अवधि एक खेल के दौरान बढ़ती है और फिर अगले खेल की सीमा पर अचानक ढह जाती है — यह उस तरीक़े की पहचान है जिससे लोग अनुभव को घटनाओं में बाँटते हैं।
हितों का टकराव। डेटा-प्रक्रिया AI पर निर्भर थी: हर प्रयोग को DeepSeek-V4-Flash ने प्रतिलिपि में बदला और Anthropic के Claude Fable 5.1 ने उसकी जाँच की; प्रभावों को परखने वाले सिम्युलेटर भी एक स्वचालित AI प्रक्रिया से बनाए गए। यह लेख Claude ने लिखा है। इसके अलावा, प्रतिस्पर्धी के रूप में इस्तेमाल किया गया Centaur मॉडल और Psych-201 संग्रह, दोनों पहले लेखक के नेतृत्व वाले पिछले काम हैं। लेखक किसी प्रतिस्पर्धी हित की घोषणा नहीं करते।
मन के एक साझा मॉडल की ओर
लेखक CORE को क्लासिक संज्ञानात्मक मॉडलों और ब्लैक बॉक्स के बीच का एक क़दम बताते हैं: इसके सिद्धांत पढ़े जा सकते हैं, लेकिन जो ब्यौरे यह सीखता है वे नहीं। इसमें दीर्घकालिक स्मृति नहीं है, क्योंकि प्रयोग एक घंटे से कम चलते हैं। उनका लक्ष्य एक मॉडल से कहीं बड़ा है: मन के सिद्धांतों को मनोविज्ञान के पूरे प्रायोगिक रिकॉर्ड के सामने एक साथ परखना, ताकि यह क्षेत्र “अपने प्रयोगों के योग से कहीं अधिक” बन सके।