سبعة ملايين خيار بشري، ونموذج صغير للعقل
على مدى أكثر من قرن، أنتج علم النفس مبادئ تشرح كيف يعمل العقل. نعرف أن الارتباطات تقوى حين تحدث الأشياء معًا، وأن التعلّم تحرّكه أخطاء التنبؤ — أي الفجوة بين ما نتوقعه وما يحدث فعلًا — وأن الدماغ ينظّم المعلومات في طبقات، من البسيط إلى المجرّد. لكن كل مبدأ طُوّر بمعزل عن غيره، وعادةً لنوع واحد من التجارب. فكم من السلوك البشري تفسّره هذه المبادئ مجتمعةً؟ لم يُقَس ذلك قط.
بنى مارسيل بينتس وإريك شولتس، من معهد الذكاء الاصطناعي المتمحور حول الإنسان في مركز هلمهولتز ميونخ ومعهد ماكس بلانك للسيبرنطيقا الحيوية في توبنغن، نموذجًا لمعرفة الجواب.
عقلٌ مصنوع من الذاكرة
يقرأ نموذجهما، CORE (اختصارًا لـ COntextual Retrieval and Encoding، أي الاسترجاع والترميز السياقيان)، النصَّ الكامل لتجربة ما — التعليمات، وما عُرض، والتغذية الراجعة، والإجابات السابقة للمشارك — ويتنبأ بالمفتاح الذي سيضغطه الشخص بعد ذلك.
ولا يحتوي إلا على حفنة من المكونات الراسخة:
- يُحوَّل النص إلى فونيمات، أي أصوات الكلام؛
- تُكتب هذه في ذاكرة ترابطية، وفق قاعدة تعلّم كلاسيكية؛
- ما يُكتب، وبأي قوة، وما يُنسى، كل ذلك يعتمد على السياق الحالي؛
- تخزّن الذاكرة أخطاء التنبؤ لا المدخلات الخام — أي ما لم تكن تعرفه من قبل فقط؛
- تُكدَّس ست ذواكر من هذا النوع في طبقات.
يضم النموذج بأكمله 452,608 معاملًا، ودُرّب في نحو 24 ساعة على بطاقة رسوميات واحدة.
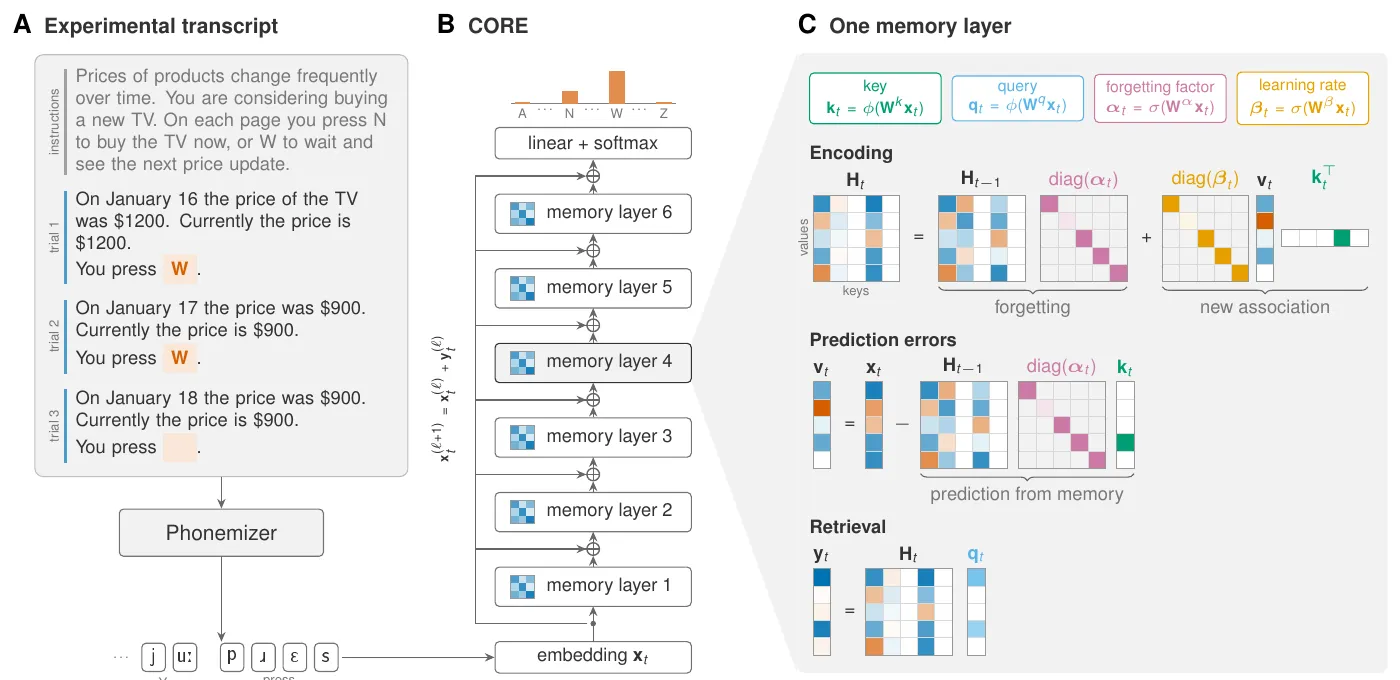
كيف يعمل CORE: يغذّي نصٌّ (A) كومةً من طبقات الذاكرة (B)؛ وتكتب كل طبقة الارتباطات وتنساها وتسترجعها بحسب السياق (C). — الشكل 1، Binz وSchulz (2026)، arXiv:2610.13603.
اختبارٌ أمام سبعة ملايين خيار
ضبط الباحثان CORE على Psych-201، وهي مجموعة كبيرة من تجارب علم النفس: 137 تجربة من 62 دراسة، تشمل التعلّم من المكافآت، والقرارات في ظل المخاطرة، وتعلّم الفئات، والحكم الاجتماعي وغير ذلك — 7,036,442 خيارًا في 80,452 جلسة للتدريب، مع جلسات أخرى خُصّصت للاختبار.
- في جلسات لم يرها من قبل، تنبأ CORE بالخيارات أفضل من بنية ذكاء اصطناعي قياسية بالحجم نفسه (Transformer) في جميع الدراسات الـ62.
- وتفوّق إجمالًا أيضًا على Centaur، وهو نموذج لغوي كبير مضبوط على السلوك البشري ويملك معاملات أكثر بخمس رتب من حيث الحجم — إذ فاز في 47 من الدراسات الـ62.
- أدّى حذف أي مكوّن منفرد إلى تراجع أدائه. وكانت الطبقات الأكثر أهمية، ثم النسيان، ثم الفونيمات، ثم أخطاء التنبؤ.
كأنه مشارك افتراضي
لا يكفي أن يطابق النموذج البيانات: فنموذج العقل ينبغي أيضًا أن يتصرّف كما يتصرف الناس. حاكى المؤلفان CORE بوصفه مشاركًا في التجارب الأصلية، وتحقّقا مما إذا كانت التأثيرات المنشورة تظهر من جديد. فأعاد إنتاج 50 من 67 تأثيرًا (75%).
كان أداؤه الأفضل في الاستكشاف (11 من 11) والتعلّم من المكافآت (10 من 11)، والأسوأ في اللغة والحكم الاجتماعي (7 من 12). ويفسّر المؤلفان هذه الإخفاقات: فكثير من تلك المهام يعتمد على معرفة يكتسبها الناس خارج المختبر، عن الكلمات والأرقام والعالم — بينما لم يرَ CORE سوى نصوص التجارب. كما يواجه صعوبة في التخطيط المسبق، إذ لا يملك آلية لذلك. وتبيّن أن بعض التأثيرات التي فاتته هشّة في البيانات البشرية أيضًا.
وتبدو إعداداته الداخلية نفسية الطابع كذلك. ففي أثناء اللعبة الواحدة، ينخفض معدل تعلّمه مع تراكم الأدلة، كما تتنبأ النظريات البايزية للتعلّم. ويتسع مدى ذاكرته خلال اللعبة ثم ينهار عند الحدّ الفاصل مع اللعبة التالية — وهي بصمة الطريقة التي يقطّع بها الناس تجربتهم إلى أحداث.
تضارب المصالح. اعتمدت معالجة البيانات على الذكاء الاصطناعي: حوّل DeepSeek-V4-Flash كل تجربة إلى نص، وتحقّق منه Claude Fable 5.1 من Anthropic؛ كما بُنيت أدوات المحاكاة المستخدمة لاختبار التأثيرات عبر مسار آلي للذكاء الاصطناعي. وهذا المقال كتبه Claude. إضافةً إلى ذلك، فإن نموذج Centaur المستخدم منافسًا ومجموعة Psych-201 هما من أعمال سابقة قادها المؤلف الأول. ويصرّح المؤلفان بعدم وجود مصالح متضاربة.
نحو نموذج مشترك للعقل
يصف المؤلفان CORE بأنه خطوة بين النماذج المعرفية الكلاسيكية والصناديق السوداء: مبادئه مقروءة، لكن التفاصيل التي يتعلمها ليست كذلك. ولا يملك ذاكرة طويلة الأمد، لأن التجارب تستغرق أقل من ساعة. وهدفهما أوسع من نموذج واحد: اختبار نظريات العقل في مواجهة السجل التجريبي الكامل لعلم النفس دفعة واحدة، كي يصبح هذا الحقل «أكثر من مجموع تجاربه».