TUJUH JUTA PILIHAN MANUSIA, SATU MODEL KECIL TENTANG PIKIRAN
Selama lebih dari satu abad, psikologi telah menghasilkan prinsip-prinsip tentang cara kerja pikiran. Kita tahu bahwa asosiasi menguat ketika berbagai hal terjadi bersamaan, bahwa belajar digerakkan oleh galat prediksi (prediction error) — selisih antara apa yang kita harapkan dan apa yang terjadi — dan bahwa otak menata informasi dalam lapisan-lapisan, dari yang sederhana hingga yang abstrak. Namun setiap prinsip dikembangkan secara terpisah, biasanya untuk satu jenis eksperimen. Seberapa banyak perilaku manusia yang mereka jelaskan bersama-sama? Hal itu belum pernah diukur.
Marcel Binz dan Eric Schulz dari Institute for Human-Centered AI di Helmholtz Munich dan Max Planck Institute for Biological Cybernetics di Tübingen membangun sebuah model untuk mencari tahu.
Pikiran yang tersusun dari memori
Model mereka, CORE (singkatan dari COntextual Retrieval and Encoding), membaca transkrip lengkap sebuah eksperimen — instruksi, apa yang ditampilkan, umpan balik, jawaban-jawaban partisipan sebelumnya — lalu memprediksi tombol mana yang akan ditekan orang itu berikutnya.
Model ini hanya berisi segelintir bahan yang sudah mapan:
- teks diubah menjadi fonem, bunyi-bunyi ujaran;
- fonem itu dituliskan ke dalam memori asosiatif, mengikuti aturan belajar klasik;
- apa yang ditulis, seberapa kuat, dan apa yang dilupakan, semuanya bergantung pada konteks saat itu;
- memori menyimpan galat prediksi, bukan masukan mentah — hanya hal yang belum ia ketahui;
- enam memori semacam itu ditumpuk dalam lapisan-lapisan.
Seluruh model memiliki 452.608 parameter dan dilatih selama sekitar 24 jam pada satu kartu grafis.
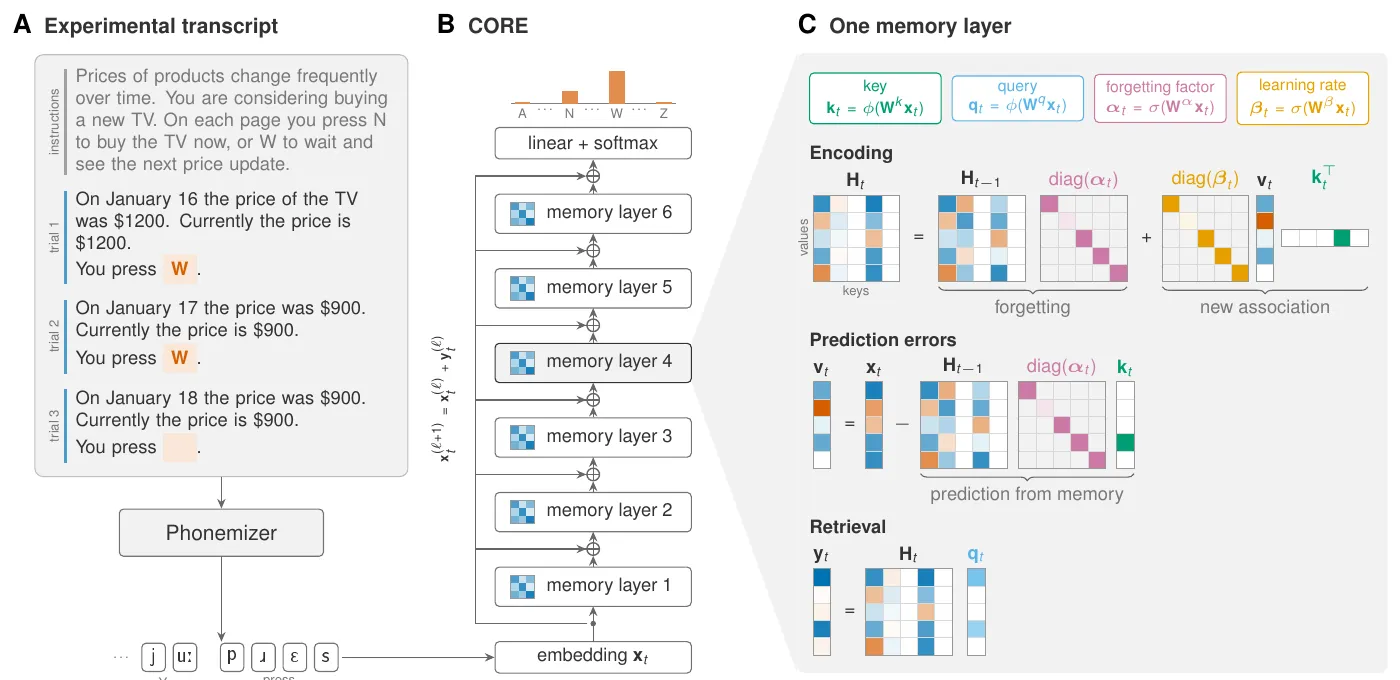
Cara kerja CORE: sebuah transkrip (A) diumpankan ke tumpukan lapisan memori (B); setiap lapisan menulis, melupakan, dan mengambil kembali asosiasi bergantung pada konteks (C). — Gambar 1, Binz & Schulz (2026), arXiv:2610.13603.
Diuji dengan tujuh juta pilihan
Mereka menyesuaikan CORE dengan Psych-201, koleksi besar eksperimen psikologi: 137 eksperimen dari 62 studi, mencakup belajar dari imbalan, keputusan di bawah risiko, belajar kategori, penilaian sosial, dan lain-lain — 7.036.442 pilihan dalam 80.452 sesi untuk pelatihan, dengan sesi-sesi lain disisihkan untuk pengujian.
- Pada sesi yang belum pernah dilihatnya, CORE memprediksi pilihan lebih baik daripada arsitektur AI standar berukuran sama (sebuah Transformer) di seluruh 62 studi.
- Secara keseluruhan, CORE juga lebih unggul daripada Centaur, model bahasa besar yang disetel (fine-tuned) dengan data perilaku manusia dan memiliki parameter lima orde besaran lebih banyak — menang di 47 dari 62 studi.
- Menghapus satu bahan mana pun membuatnya lebih buruk. Lapisan paling berpengaruh, disusul lupa, lalu fonem, lalu galat prediksi.
Seperti partisipan virtual
Sekadar cocok dengan data tidaklah cukup: model pikiran juga harus berperilaku seperti manusia. Para penulis menyimulasikan CORE sebagai partisipan dalam eksperimen-eksperimen aslinya dan memeriksa apakah efek-efek yang telah dipublikasikan muncul kembali. CORE mereproduksi 50 dari 67 efek (75%).
Hasil terbaiknya ada pada eksplorasi (11 dari 11) dan belajar dari imbalan (10 dari 11), terburuk pada bahasa dan penilaian sosial (7 dari 12). Para penulis menjelaskan kegagalannya: banyak tugas tersebut bergantung pada pengetahuan yang diperoleh orang di luar laboratorium, tentang kata, angka, dan dunia — sementara CORE hanya pernah melihat transkrip eksperimen. Model ini juga kesulitan dalam merencanakan ke depan, karena tidak memiliki mekanisme untuk itu. Beberapa efek yang tidak tertangkap ternyata juga rapuh dalam data manusia.
Pengaturan internalnya pun tampak psikologis. Di dalam satu permainan, laju belajarnya menurun seiring bukti terkumpul, sebagaimana diprediksi teori belajar Bayesian. Dan rentang memorinya membesar selama satu permainan lalu runtuh di batas dengan permainan berikutnya — ciri khas cara manusia memotong pengalaman menjadi peristiwa-peristiwa.
Konflik kepentingan. Pengolahan data mengandalkan AI: setiap eksperimen diubah menjadi transkrip oleh DeepSeek-V4-Flash dan diverifikasi oleh Claude Fable 5.1, buatan Anthropic; simulator yang dipakai untuk menguji efek-efek itu juga dibangun oleh alur kerja AI otomatis. Artikel ini ditulis oleh Claude. Selain itu, model Centaur yang dijadikan pesaing dan koleksi Psych-201 sama-sama merupakan karya sebelumnya yang dipimpin penulis pertama. Para penulis menyatakan tidak ada konflik kepentingan.
Menuju model pikiran bersama
Para penulis menggambarkan CORE sebagai langkah di antara model kognitif klasik dan kotak hitam: prinsip-prinsipnya bisa dibaca, tetapi detail yang dipelajarinya tidak. Model ini tidak punya memori jangka panjang, karena eksperimen-eksperimen itu berlangsung kurang dari satu jam. Tujuan mereka lebih luas daripada satu model: menguji teori-teori tentang pikiran terhadap seluruh catatan eksperimen psikologi sekaligus, agar bidang ini menjadi “lebih dari sekadar jumlah eksperimen-eksperimennya”.