هفت میلیون انتخاب انسانی، یک مدل کوچک از ذهن
روانشناسی بیش از یک قرن است که اصولی دربارهٔ کارکرد ذهن ارائه میکند. میدانیم که پیوندها وقتی چیزها با هم رخ میدهند قویتر میشوند، که یادگیری را خطاهای پیشبینی پیش میبرند — فاصلهٔ میان آنچه انتظار داریم و آنچه رخ میدهد — و که مغز اطلاعات را در لایههایی از ساده تا انتزاعی سازمان میدهد. اما هر اصل جداگانه و معمولاً برای یک نوع آزمایش پرورده شد. این اصول با هم چه مقدار از رفتار انسان را توضیح میدهند؟ این هرگز سنجیده نشده بود.
مارسل بینتس و اریک شولتس از مؤسسهٔ هوش مصنوعی انسانمحور (Institute for Human-Centered AI) در هلمهولتس مونیخ و مؤسسهٔ ماکس پلانک سایبرنتیک زیستی در توبینگن، مدلی ساختند تا پاسخ را بیابند.
ذهنی ساخته از حافظه
مدل آنها، CORE (کوتاهشدهٔ COntextual Retrieval and Encoding)، متن کامل یک آزمایش را میخواند — دستورالعملها، آنچه نمایش داده شد، بازخوردها، پاسخهای قبلی شرکتکننده — و پیشبینی میکند فرد در گام بعد کدام کلید را فشار میدهد.
این مدل چیزی جز چند جزء شناختهشده ندارد:
- متن به واجها (phonemes)، یعنی صداهای گفتار، تبدیل میشود؛
- این واجها طبق یک قاعدهٔ یادگیری کلاسیک در یک حافظهٔ تداعیگر (associative memory) نوشته میشوند؛
- اینکه چه چیزی نوشته شود، با چه شدتی، و چه چیزی فراموش شود، همه به بافت لحظه بستگی دارد؛
- حافظه خطاهای پیشبینی را ذخیره میکند نه ورودیهای خام را — یعنی فقط آنچه را از پیش نمیدانست؛
- شش حافظه از این دست در لایههایی روی هم چیده شدهاند.
کل مدل ۴۵۲٬۶۰۸ پارامتر دارد و در حدود ۲۴ ساعت روی یک کارت گرافیک آموزش دید.
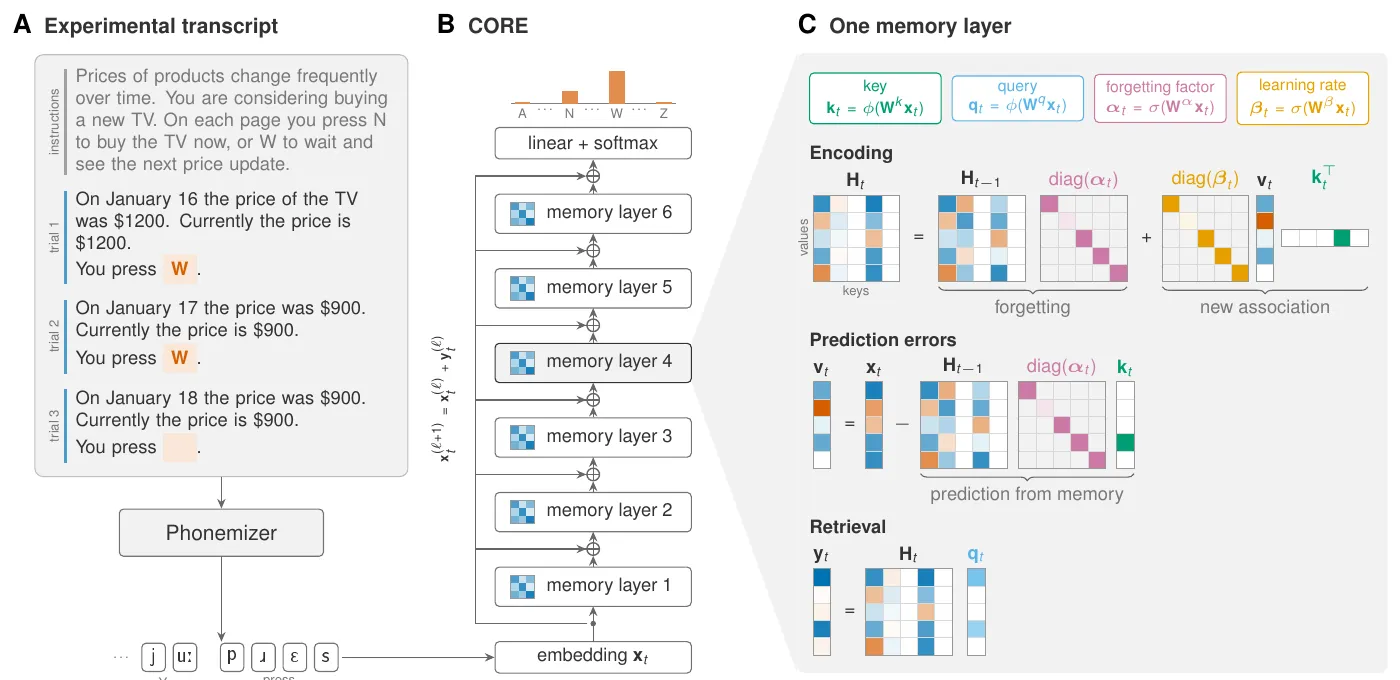
CORE چگونه کار میکند: یک متن (A) به پشتهای از لایههای حافظه (B) خورانده میشود؛ هر لایه بسته به بافت، پیوندها را مینویسد، فراموش میکند و بازیابی میکند (C). — Figure 1, Binz & Schulz (2026), arXiv:2610.13603.
آزموده با هفت میلیون انتخاب
آنها CORE را روی Psych-201 برازش کردند، مجموعهای بزرگ از آزمایشهای روانشناسی: ۱۳۷ آزمایش از ۶۲ مطالعه که یادگیری از پاداش، تصمیمگیری در شرایط ریسک، یادگیری مقولهها، داوری اجتماعی و موارد دیگر را در بر میگیرد — ۷٬۰۳۶٬۴۴۲ انتخاب در ۸۰٬۴۵۲ نشست برای آموزش، و نشستهای دیگری که برای آزمون کنار گذاشته شدند.
- روی نشستهایی که هرگز ندیده بود، CORE انتخابها را در هر ۶۲ مطالعه بهتر از یک معماری استاندارد هوش مصنوعی هماندازه (یک ترنسفورمر) پیشبینی کرد.
- در مجموع از Centaur هم بهتر عمل کرد، مدلی زبانی بزرگ که روی رفتار انسان تنظیم دقیق شده و پنج مرتبهٔ بزرگی پارامتر بیشتر دارد — و در ۴۷ مطالعه از ۶۲ برنده شد.
- حذف هر یک از اجزا مدل را بدتر کرد. لایهها از همه مهمتر بودند، سپس فراموشی، سپس واجها و بعد خطاهای پیشبینی.
مثل یک شرکتکنندهٔ مجازی
برازش دادهها کافی نیست: مدلی از ذهن باید مثل آدمها رفتار هم بکند. نویسندگان CORE را بهعنوان شرکتکننده در آزمایشهای اصلی شبیهسازی کردند و بررسی کردند که آیا اثرهای منتشرشده دوباره ظاهر میشوند. مدل ۵۰ اثر از ۶۷ (۷۵٪) را بازتولید کرد.
بهترین عملکردش در اکتشاف (۱۱ از ۱۱) و یادگیری از پاداش (۱۰ از ۱۱) بود و بدترینش در زبان و داوری اجتماعی (۷ از ۱۲). نویسندگان این ناکامیها را توضیح میدهند: بسیاری از این تکالیف به دانشی تکیه دارند که مردم بیرون از آزمایشگاه دربارهٔ واژهها، اعداد و جهان کسب میکنند — و CORE تنها متن آزمایشها را دیده است. در برنامهریزی برای آینده هم مشکل دارد، چون سازوکاری برای آن ندارد. برخی از اثرهایی که از دست داد، در دادههای انسانی هم شکننده از آب درآمدند.
تنظیمات درونیاش هم روانشناختی به نظر میرسند. درون یک بازی، نرخ یادگیریاش با انباشت شواهد کاهش مییابد، همانطور که نظریههای بیزی یادگیری پیشبینی میکنند. و گسترهٔ حافظهاش در طول یک بازی بزرگتر میشود و سپس در مرز با بازی بعدی فرو میریزد — نشانهای از اینکه مردم تجربه را چگونه به رویدادها تقسیم میکنند.
تعارض منافع. زنجیرهٔ پردازش داده به هوش مصنوعی تکیه داشت: هر آزمایش را DeepSeek-V4-Flash به متن تبدیل کرد و Claude Fable 5.1، ساختهٔ Anthropic، آن را راستیآزمایی کرد؛ شبیهسازهایی که برای آزمودن اثرها به کار رفتند نیز با یک زنجیرهٔ خودکار هوش مصنوعی ساخته شدند. این مقاله را Claude نوشته است. افزون بر این، مدل Centaur که بهعنوان رقیب به کار رفت و مجموعهٔ Psych-201 هر دو کارهای پیشینیاند که نویسندهٔ نخست رهبریشان را بر عهده داشته است. نویسندگان اعلام میکنند که تعارض منافعی ندارند.
به سوی مدلی مشترک از ذهن
نویسندگان CORE را گامی میان مدلهای شناختی کلاسیک و جعبهسیاهها توصیف میکنند: اصولش خواناست، اما جزئیاتی که میآموزد نه. حافظهٔ بلندمدت ندارد، چون آزمایشها کمتر از یک ساعت طول میکشند. هدفشان از یک مدل فراتر میرود: آزمودن نظریههای ذهن در برابر کل کارنامهٔ تجربی روانشناسی بهیکباره، تا این رشته «چیزی بیش از مجموع آزمایشهایش» شود.