எழுபது லட்சம் மனிதத் தேர்வுகள், மனதின் ஒரு சிறிய மாதிரி
ஒரு நூற்றாண்டுக்கும் மேலாக, மனம் எப்படிச் செயல்படுகிறது என்பதற்கான கொள்கைகளை உளவியல் உருவாக்கி வருகிறது. விஷயங்கள் சேர்ந்து நிகழும்போது தொடர்புகள் வலுப்படுகின்றன என்றும், கற்றலை கணிப்புப் பிழைகள் (prediction errors) — நாம் எதிர்பார்ப்பதற்கும் நடப்பதற்கும் இடையிலான இடைவெளி — இயக்குகின்றன என்றும், மூளை தகவலை எளியதிலிருந்து நுண்ணியது வரை அடுக்குகளாக ஒழுங்குபடுத்துகிறது என்றும் நமக்குத் தெரியும். ஆனால் ஒவ்வொரு கொள்கையும் தனியாக, பொதுவாக ஒரே வகைச் சோதனைக்காக உருவாக்கப்பட்டது. அவை சேர்ந்து மனித நடத்தையின் எவ்வளவு பகுதியை விளக்குகின்றன? அது ஒருபோதும் அளக்கப்படவில்லை.
ஹெல்ம்ஹோல்ட்ஸ் மியூனிக்கின் Institute for Human-Centered AI, டியூபிங்கனில் உள்ள மாக்ஸ் பிளாங்க் உயிரியல் சைபர்நெட்டிக்ஸ் நிறுவனம் ஆகியவற்றைச் சேர்ந்த மார்செல் பின்ஸ், எரிக் ஷுல்ட்ஸ் ஆகியோர் இதைக் கண்டறிய ஒரு மாதிரியை உருவாக்கினர்.
நினைவகத்தால் ஆன மனம்
அவர்களின் மாதிரி CORE (COntextual Retrieval and Encoding என்பதன் சுருக்கம்), ஒரு சோதனையின் முழு எழுத்துப்படியை — அறிவுறுத்தல்கள், காட்டப்பட்டவை, பின்னூட்டம், பங்கேற்பாளரின் முந்தைய பதில்கள் — படித்து, அந்த நபர் அடுத்து எந்த விசையை அழுத்துவார் என்று கணிக்கிறது.
அதில் நன்கு நிறுவப்பட்ட சில கூறுகளைத் தவிர வேறு எதுவும் இல்லை:
- உரை, பேச்சின் ஒலிகளான ஒலியன்களாக (phonemes) மாற்றப்படுகிறது;
- இவை ஒரு பாரம்பரியக் கற்றல் விதியின்படி ஒரு தொடர்பு நினைவகத்தில் (associative memory) எழுதப்படுகின்றன;
- எது எழுதப்படுகிறது, எவ்வளவு வலுவாக, எது மறக்கப்படுகிறது என்பவை அனைத்தும் தற்போதைய சூழலைப் பொறுத்தவை;
- நினைவகம் மூல உள்ளீடுகளை அல்ல, கணிப்புப் பிழைகளையே சேமிக்கிறது — ஏற்கனவே அறியாதவற்றை மட்டும்;
- இத்தகைய ஆறு நினைவகங்கள் அடுக்குகளாக ஒன்றன்மேல் ஒன்று வைக்கப்பட்டுள்ளன.
முழு மாதிரியிலும் 452,608 அளவுருக்கள் உள்ளன; ஒரே ஒரு வரைகலை அட்டையில் (graphics card) சுமார் 24 மணி நேரத்தில் பயிற்றுவிக்கப்பட்டது.
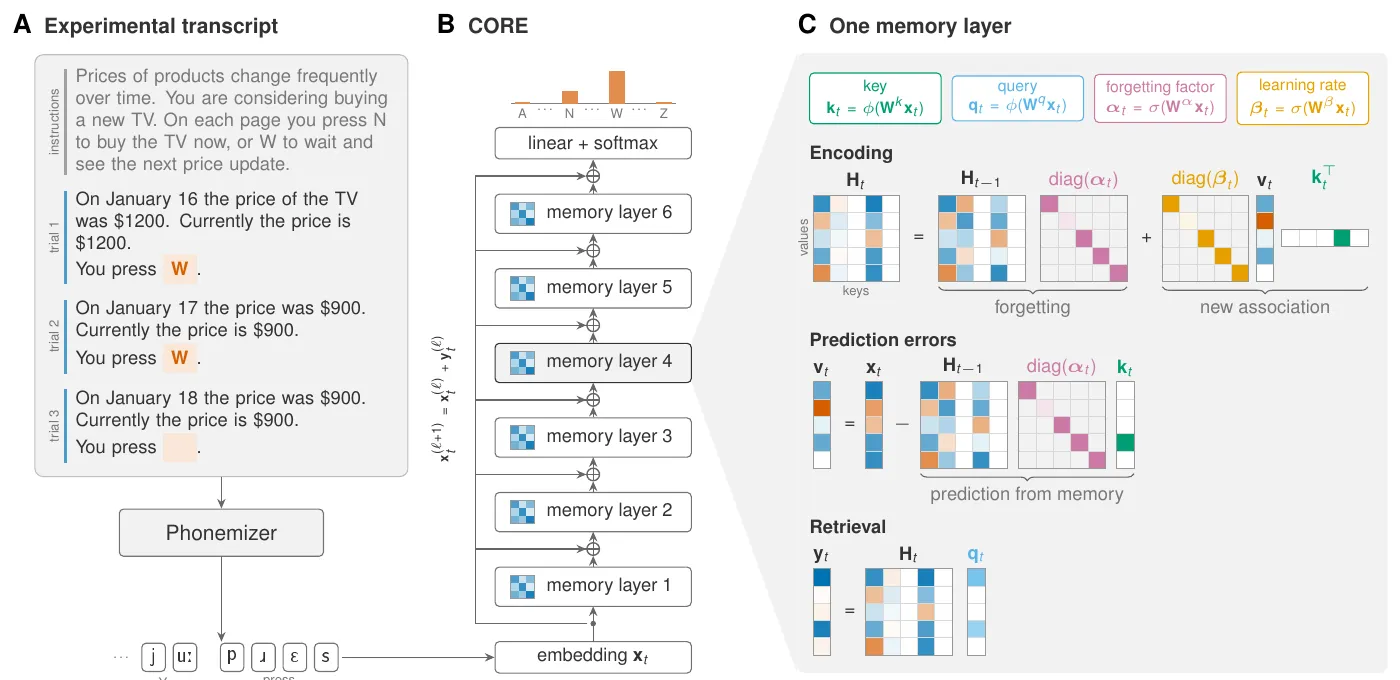
CORE எப்படிச் செயல்படுகிறது: ஓர் எழுத்துப்படி (A) நினைவக அடுக்குகளின் ஒரு குவியலுக்கு (B) உள்ளீடாகிறது; ஒவ்வோர் அடுக்கும் சூழலைப் பொறுத்துத் தொடர்புகளை எழுதுகிறது, மறக்கிறது, மீட்டெடுக்கிறது (C). — Figure 1, Binz & Schulz (2026), arXiv:2610.13603.
எழுபது லட்சம் தேர்வுகளுக்கு எதிராகச் சோதனை
அவர்கள் CORE-ஐ உளவியல் சோதனைகளின் பெரும் தொகுப்பான Psych-201-க்குப் பொருத்தினர்: 62 ஆய்வுகளிலிருந்து 137 சோதனைகள்; வெகுமதிகளிலிருந்து கற்றல், இடர் நிலையில் முடிவெடுத்தல், வகைக் கற்றல், சமூக மதிப்பீடு மற்றும் பல — பயிற்சிக்கு 80,452 அமர்வுகளில் 7,036,442 தேர்வுகள்; சோதனைக்கு வேறு அமர்வுகள் தனியே வைக்கப்பட்டன.
- தான் ஒருபோதும் பார்த்திராத அமர்வுகளில், அதே அளவுள்ள ஒரு நிலையான AI கட்டமைப்பைவிட (ஒரு Transformer) 62 ஆய்வுகள் அனைத்திலும் CORE தேர்வுகளைச் சிறப்பாகக் கணித்தது.
- மனித நடத்தையில் நுண்ணமைக்கப்பட்டு, ஐந்து பருமன் வரிசைகள் (orders of magnitude) அதிக அளவுருக்கள் கொண்ட பெரிய மொழி மாதிரியான Centaur-ஐவிடவும் ஒட்டுமொத்தமாகச் சிறப்பாகச் செயல்பட்டது — 62 ஆய்வுகளில் 47-இல் வென்றது.
- எந்த ஒரு கூறை நீக்கினாலும் அது மோசமானது. அடுக்குகள் மிக முக்கியமானவை; அடுத்து மறத்தல், அடுத்து ஒலியன்கள், அடுத்து கணிப்புப் பிழைகள்.
ஒரு மெய்நிகர் பங்கேற்பாளர் போல
தரவுக்குப் பொருந்துவது மட்டும் போதாது: மனதின் மாதிரி மனிதர்களைப் போல நடந்துகொள்ளவும் வேண்டும். ஆசிரியர்கள் CORE-ஐ மூலச் சோதனைகளில் ஒரு பங்கேற்பாளராக உருவகப்படுத்தி, வெளியிடப்பட்ட விளைவுகள் மீண்டும் தோன்றுகின்றனவா என்று சரிபார்த்தனர். அது 67 விளைவுகளில் 50-ஐ (75%) மீண்டும் உருவாக்கியது.
தேடலாய்வில் (exploration) (11-இல் 11) மற்றும் வெகுமதிகளிலிருந்து கற்றலில் (11-இல் 10) மிகச் சிறப்பாகவும், மொழி மற்றும் சமூக மதிப்பீட்டில் (12-இல் 7) மிக மோசமாகவும் செயல்பட்டது. தவறுகளை ஆசிரியர்கள் இப்படி விளக்குகின்றனர்: இந்தப் பணிகளில் பல, சொற்கள், எண்கள், உலகம் பற்றி மக்கள் ஆய்வகத்துக்கு வெளியே பெறும் அறிவைச் சார்ந்தவை — CORE சோதனைகளின் எழுத்துப்படிகளை மட்டுமே பார்த்துள்ளது. முன்கூட்டியே திட்டமிடுவதிலும் அது சிரமப்படுகிறது; அதற்கான பொறிமுறை அதனிடம் இல்லை. அது தவறவிட்ட சில விளைவுகள் மனிதத் தரவிலும் உறுதியற்றவை என்று தெரியவந்தது.
அதன் உள் அமைப்புகளும் உளவியல் சார்ந்தவையாகத் தோன்றுகின்றன. ஒரு விளையாட்டுக்குள், சான்றுகள் குவியக் குவிய அதன் கற்றல் வீதம் குறைகிறது — பேய்சியன் (Bayesian) கற்றல் கோட்பாடுகள் கணிப்பது போலவே. அதன் நினைவக வீச்சு ஒரு விளையாட்டின் போது வளர்ந்து, அடுத்த விளையாட்டுடனான எல்லையில் சரிகிறது — மக்கள் அனுபவத்தை நிகழ்வுகளாகப் பிரிக்கும் விதத்தின் அடையாளம்.
நலன் முரண்பாடு. தரவுச் செயல்முறை AI-யைச் சார்ந்திருந்தது: ஒவ்வொரு சோதனையையும் DeepSeek-V4-Flash எழுத்துப்படியாக மாற்றியது; Anthropic உருவாக்கிய Claude Fable 5.1 அதைச் சரிபார்த்தது; விளைவுகளைச் சோதிக்கப் பயன்பட்ட உருவகப்படுத்திகளும் தானியங்கி AI செயல்முறையால் உருவாக்கப்பட்டவை. இந்தக் கட்டுரையை எழுதியது Claude. மேலும், போட்டியாளராகப் பயன்படுத்தப்பட்ட Centaur மாதிரியும் Psych-201 தொகுப்பும் முதல் ஆசிரியர் தலைமையிலான முந்தைய பணிகள். தங்களுக்கு எந்த நலன் முரண்பாடும் இல்லை என்று ஆசிரியர்கள் அறிவிக்கின்றனர்.
மனதின் பொது மாதிரியை நோக்கி
ஆசிரியர்கள் CORE-ஐ பாரம்பரிய அறிவாற்றல் மாதிரிகளுக்கும் கருப்புப் பெட்டிகளுக்கும் (black boxes) இடையிலான ஒரு படியாக விவரிக்கின்றனர்: அதன் கொள்கைகளைப் படிக்க முடியும், ஆனால் அது கற்கும் விவரங்களை அல்ல. சோதனைகள் ஒரு மணி நேரத்துக்குள் முடிவதால், அதற்கு நீண்டகால நினைவகம் இல்லை. அவர்களின் இலக்கு ஒரு மாதிரியைவிடப் பரந்தது: மனம் பற்றிய கோட்பாடுகளை உளவியலின் முழுச் சோதனைப் பதிவுக்கும் எதிராக ஒரே நேரத்தில் சோதிப்பது; அப்போதுதான் இத்துறை “தன் சோதனைகளின் கூட்டுத்தொகையைவிட மேலானதாக” மாறும்.