七百万次人类选择,一个小小的心智模型
一个多世纪以来,心理学提出了许多关于心智如何运作的原理。我们知道,当事物同时出现时,联想会增强;学习由预测误差驱动——即我们的预期与实际发生之间的差距;大脑以层级方式组织信息,从简单到抽象。但每条原理都是孤立发展起来的,通常只针对一类实验。它们合在一起能解释多少人类行为?这一点从未被测量过。
亥姆霍兹慕尼黑中心以人为本人工智能研究所和蒂宾根马克斯·普朗克生物控制论研究所的马塞尔·宾茨(Marcel Binz)和埃里克·舒尔茨(Eric Schulz)构建了一个模型来寻找答案。
由记忆构成的心智
他们的模型名为CORE(COntextual Retrieval and Encoding,情境检索与编码),它读取一项实验的完整记录——指导语、呈现的内容、反馈、受试者此前的回答——并预测这个人下一次会按哪个键。
模型中只包含少数几种已被确认的成分:
- 文本被转换为音素,即语音的声音单位;
- 这些音素按照一条经典学习规则写入联想记忆;
- 写入什么、写入多强、以及遗忘什么,都取决于当前的情境;
- 记忆存储的是预测误差而非原始输入——只存它原本不知道的东西;
- 六个这样的记忆按层堆叠起来。
整个模型共有452,608个参数,在单张显卡上训练了约24小时。
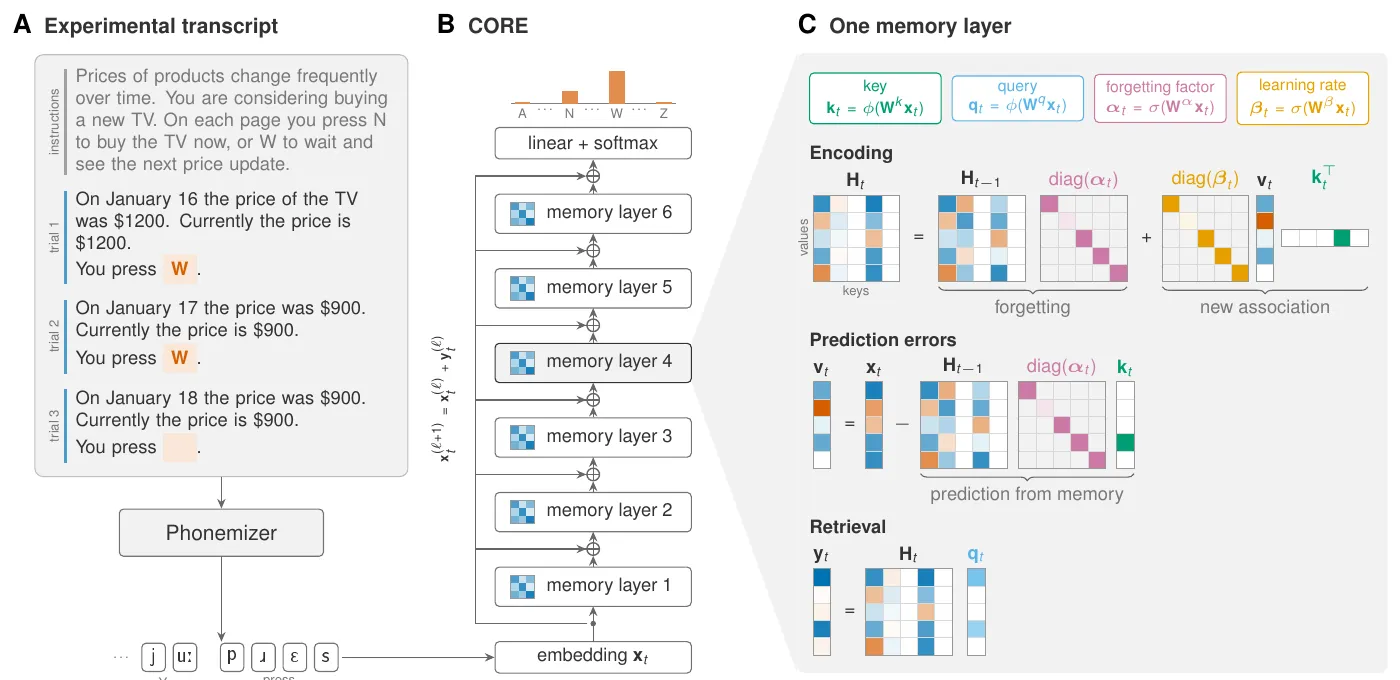
CORE的工作方式:一份记录(A)输入一组堆叠的记忆层(B);每一层根据情境写入、遗忘和检索联想(C)。——图1,Binz & Schulz(2026),arXiv:2610.13603。
用七百万次选择来检验
他们用Psych-201拟合CORE。这是一个大型心理学实验集合:来自62项研究的137项实验,涵盖奖励学习、风险决策、类别学习、社会判断等——训练用的是80,452个实验场次中的7,036,442次选择,另有一些场次留作测试。
- 在从未见过的场次上,CORE在全部62项研究中预测选择的表现都优于同等规模的标准AI架构(Transformer)。
- 总体上,它还胜过了Centaur——一个在人类行为数据上微调过的大语言模型,参数量比CORE多五个数量级——在62项研究中的47项里获胜。
- 去掉任何一种成分都会让模型变差。影响最大的是分层,其次是遗忘,然后是音素,最后是预测误差。
像一名虚拟受试者
拟合数据还不够:一个心智模型还应该表现得像人。作者让CORE以受试者身份参与原始实验的模拟,检验已发表的效应是否再现。结果它重现了67个效应中的50个(75%)。
它在探索任务(11个中的11个)和奖励学习(11个中的10个)上表现最好,在语言和社会判断(12个中的7个)上最差。作者对这些失误作了解释:许多此类任务依赖人们在实验室之外获得的关于词语、数字和世界的知识——而CORE只见过实验记录。它在提前规划方面也有困难,因为它没有相应的机制。它未能重现的一些效应,在人类数据中本身也并不稳健。
它的内部设置看起来也颇具心理学意味。在一局游戏中,它的学习率随着证据积累而下降,正如贝叶斯学习理论所预测的那样。而它的记忆跨度在一局游戏中逐渐增长,然后在进入下一局的边界处骤然收缩——这正是人们把经验切分为事件的一种特征。
利益冲突。 数据处理流程依赖AI:每项实验由DeepSeek-V4-Flash转换为文字记录,并由Anthropic的Claude Fable 5.1核验;用于检验各效应的模拟器也是由一个自动化AI流程构建的。本文由Claude撰写。此外,作为对比对象的Centaur模型和Psych-201数据集,都是由第一作者主导的早期工作。作者声明不存在利益冲突。
迈向共享的心智模型
作者把CORE描述为介于经典认知模型和黑箱之间的一步:它的原理是可读的,但它学到的细节不是。它没有长期记忆,因为这些实验都不超过一小时。他们的目标不止于一个模型:而是用心理学的全部实验记录同时检验关于心智的理论,让这个领域变得“大于其各项实验之和”。