LA IA QUE LEE EL SELLO DEL HOSPITAL EN LUGAR DE LOS PULMONES
Un clasificador de radiografías de tórax puede aprender a leer el código que un hospital estampa en la esquina de cada imagen en lugar de la enfermedad de los pulmones. Entonces funciona bien con los datos de ese hospital y falla en silencio en el siguiente. Estudios anteriores lo documentaron en clasificadores de COVID-19 y de neumonía. Lo que no podían decir era qué parte del modelo hace esa lectura, ni si eliminar esa parte serviría de algo.
Las herramientas de explicación habituales —mapas de calor como Grad-CAM, el despliegue de la atención (attention rollout), LIME— muestran dónde miró un modelo. No identifican el componente responsable, ni pueden establecer una causa. Joshua Muhumuza y Cornelius Kalenzi, de la Universidad Makerere, tomaron prestado en cambio el instrumental de la interpretabilidad mecanicista, desarrollado para diseccionar modelos de lenguaje, y lo aplicaron a un Vision Transformer.
De un hospital universitario a una clínica de distrito
Los autores plantean lo que está en juego de forma concreta. Los clasificadores de radiografías basados en transformers se usan cada vez más para el cribado de tuberculosis y neumonía en entornos con pocos recursos; a menudo se entrenan en un gran hospital de referencia y se trasladan, sin volver a auditarlos, a hospitales de distrito o unidades móviles con otras máquinas, otro software y otras costumbres de etiquetado. Un modelo que aprendió el sello de su hospital de origen se degradaría en cuanto llegara a una clínica que no estampa nada, o que estampa otra cosa en otro sitio.
Una cabeza entre 144
El modelo estudiado, ViT-Base/16 (el punto de control público google/vit-base-patch16-224, preentrenado en ImageNet-21k), divide cada imagen en 196 parches y los procesa a través de 12 capas de 12 cabezas de atención cada una. El equipo puntuó las 144 cabezas según lo concentrada y lo amplia que era su atención.
La concentración aparece de repente en las capas 7 a 9. Una cabeza se distingue: L8H10, la cabeza 10 de la capa 8. Pone el 34,6 % de su atención en un solo parche, 2,8 veces más que cualquier otra cabeza. En una radiografía marcada con «D CLINO» en la esquina superior izquierda, coloca 0,346 de su atención en ese parche, 68 veces el nivel uniforme de 0,0051, mientras que los pulmones no reciben casi nada.
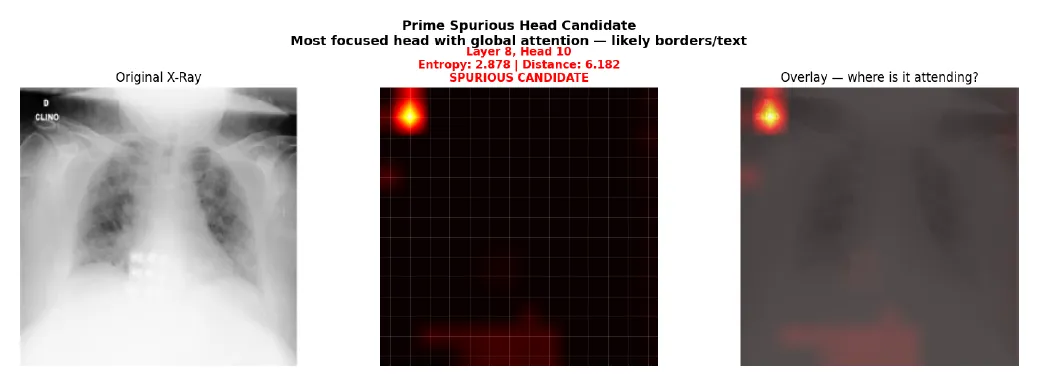
La cabeza L8H10 en la primera radiografía examinada: un único punto brillante sobre la anotación de la esquina, casi negro sobre los pulmones. — Figura 4, Muhumuza y Kalenzi (2026), arXiv:2610.21638.
En 200 radiografías de COVID-19, la cabeza se comporta así en 123 (el 62 %). En esas imágenes, la atención a la esquina es en promedio 57,5 veces la atención a los pulmones; en las demás, 0,77 veces. Los dos grupos no se solapan. Lo que predice ese comportamiento no es el brillo, sino el contraste local en la esquina, justo lo que producen unas letras oscuras sobre un fondo claro.
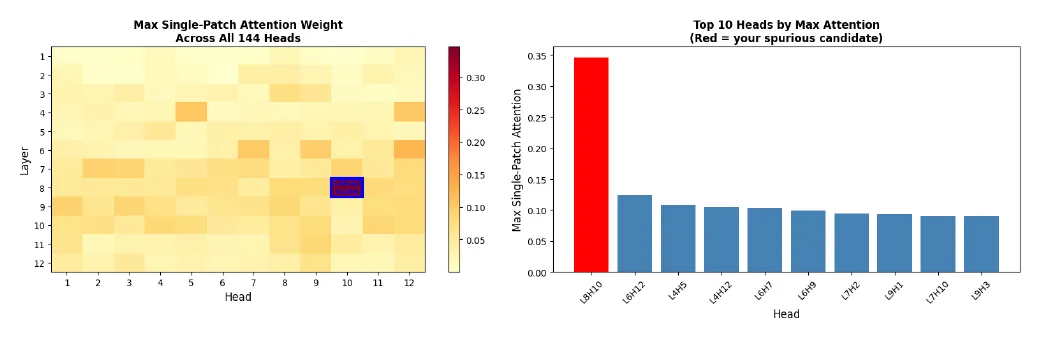
Atención máxima a un solo parche para cada cabeza: L8H10 (en rojo) está en 0,346; la siguiente, en 0,124. — Figura 3, Muhumuza y Kalenzi (2026), arXiv:2610.21638.
La prueba del borrado
Tapar la esquina con un gris uniforme no es una prueba limpia: un cuadrado gris uniforme tiene en sí mismo un contraste alto y atrae a la cabeza. Por eso los autores rellenaron la esquina (inpainting) con una textura de tejido realista. La atención a la esquina bajó entonces en 158 de las 200 imágenes (79 %). En las imágenes afectadas, la atención a los pulmones se multiplicó por 1,52; en las demás, no se movió (0,99 veces). Lo que activa la cabeza es el propio texto, no el brillo ni los bordes.
El patrón se repite en otros lugares: en el 79 % de 200 radiografías del conjunto de datos NIH ChestX-ray14, y en otras dos arquitecturas, DeiT-Base (cabeza L9H2, 88 %) y ViT-Large/16 (cabeza L8H8, 80 %).
El circuito que ninguna prueba ve
El resultado central es negativo. En un clasificador de radiografías de cinco clases construido sobre la misma arquitectura, desactivar L8H10 cambió el 5 % de las predicciones, pero con la misma frecuencia en imágenes normales que en las afectadas (p = 0,340). Un segundo clasificador de neumonía, entrenado de forma independiente, dio el mismo resultado nulo. Desactivar a la vez las tres cabezas sospechosas (L8H10, L7H2, L9H3) duplicó los cambios hasta el 10 %, de nuevo sin ningún efecto específico (p = 0,532).
Los autores lo interpretan como redundancia: la información está repartida entre muchos componentes, así que al eliminar los portadores más visibles, el resto sigue haciendo el trabajo. Reentrenar tampoco ayuda. Tras un ajuste fino completo con radiografías, 121 de las 123 imágenes afectadas (98,4 %) seguían activando la cabeza, porque el sello sigue siendo predictivo en datos donde las costumbres de etiquetado reflejan de qué hospital —y de qué enfermedades— procede una imagen.
Mirar dentro antes de desplegar
El peligro, escriben los autores, no es un diagnóstico erróneo, sino una vulnerabilidad oculta que se activa cuando un modelo cambia de hospital. Su recomendación: auditar las cabezas de atención, identificar a los portadores, verificarlos causalmente y hacerlo antes del despliegue, sobre todo entre instituciones distintas. Las únicas soluciones fiables que conocen están en los datos: entrenar con imágenes sin anotaciones, o penalizar las cabezas identificadas durante el entrenamiento.
También se exponen los límites. La región de la esquina y el umbral se fijaron para estos conjuntos de datos; las pruebas de ajuste fino usaron solo 200 imágenes; y el experimento decisivo —entrenar con imágenes anotadas frente a imágenes limpias del mismo tamaño— está aún por hacer.