肺ではなく病院のスタンプを読むAI
胸部X線の分類器は、肺の病気ではなく、病院がすべての画像の隅に押すコードを読むことを覚えてしまうことがある。するとその病院のデータではよい成績を出し、次の病院では黙って失敗する。これまでの研究は、COVID-19や肺炎の分類器でこれを記録してきた。それらが言えなかったのは、モデルのどの部分が読んでいるのか、そしてその部分を取り除けば役に立つのか、ということだった。
ふつうの説明ツール、たとえばGrad-CAMのようなヒートマップ、アテンションロールアウト、LIMEは、モデルがどこを見たかを示す。だが、責任のある構成要素を特定することはできず、因果関係を確かめることもできない。マケレレ大学のジョシュア・ムフムザ(Joshua Muhumuza)とコーネリアス・カレンジ(Cornelius Kalenzi)は、代わりに、言語モデルを解剖するために開発されたメカニスティック解釈可能性(mechanistic interpretability)の道具箱を借り、それをビジョントランスフォーマーに適用した。
教育病院から地域の診療所へ
著者らは、何が懸かっているのかを具体的に示している。トランスフォーマーに基づくX線分類器は、資源の乏しい環境で結核や肺炎のスクリーニングにますます使われるようになっている。多くの場合、大きな紹介先病院で訓練され、再監査なしに、機械もソフトウェアもラベルづけの習慣も異なる地方病院や移動診療車に移される。自分のいた病院のスタンプを覚えたモデルは、何もスタンプを押さない診療所や、別の場所に別のものを押す診療所に出会った瞬間に、性能が落ちてしまうだろう。
144個のうちの1つのヘッド
調べたモデルはViT-Base/16(ImageNet-21kで事前学習された公開チェックポイントgoogle/vit-base-patch16-224)で、各画像を196個のパッチに切り分け、それぞれ12個のアテンションヘッドをもつ12層で処理する。チームは144個のヘッドすべてを、その注意がどれだけ集中しているか、どれだけ遠くまで届くかで採点した。
集中は第7層から第9層で突然現れる。1つのヘッドが際立っている。第8層の10番目のヘッド、L8H10だ。それは注意の34.6% を1つのパッチに向ける。ほかのどのヘッドよりも2.8倍多い。左上の隅に「D CLINO」と記されたX線写真では、注意の0.346をそのパッチに向けている。一様な場合の水準0.0051の68倍だ。一方、肺にはほとんど何も向けられていない。
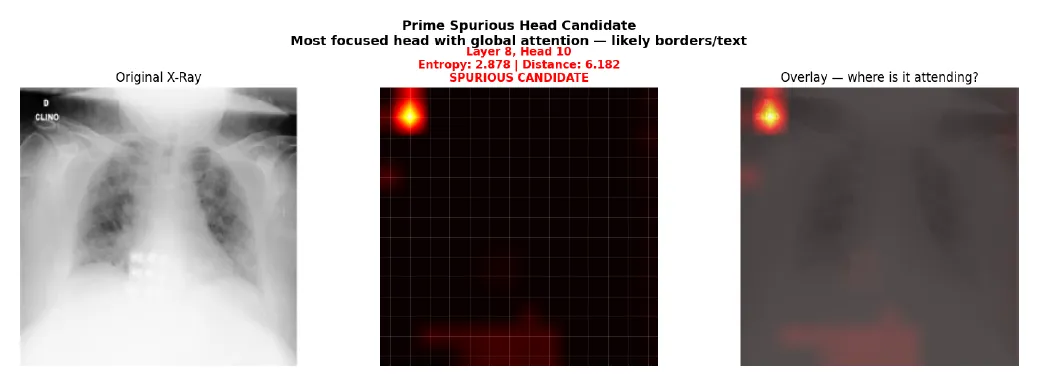
最初に調べたX線写真でのヘッドL8H10:隅の注記に明るい点が1つあり、肺の上はほぼ真っ黒。— Figure 4, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
200枚のCOVID-19のX線写真のうち、このヘッドがこうふるまうのは 123枚(62%) だ。それらの画像では、隅への注意は平均して肺への注意の57.5倍、それ以外の画像では0.77倍だった。2つのグループは重ならない。このふるまいを予測するのは明るさではなく、隅の局所的なコントラストだ。まさに、明るい背景の上の暗い文字が生み出すものである。
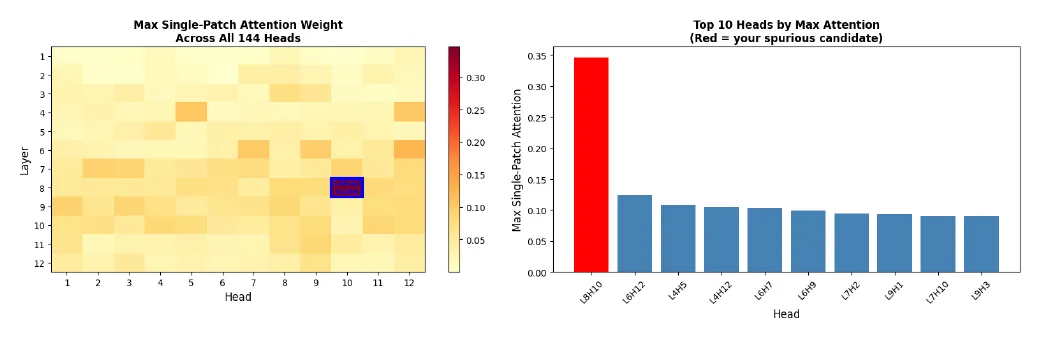
すべてのヘッドについての単一パッチへの最大注意:L8H10(赤)は0.346、次は0.124。— Figure 3, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
消すことによる証明
隅を一様な灰色で覆うのは、きれいな検証にはならない。一様な灰色の四角形そのものがコントラストの高いものであり、ヘッドを引きつけてしまうからだ。そこで著者らは代わりに隅をインペインティングし、本物らしい組織の質感で埋めた。すると隅への注意は、200枚のうち158枚(79%)で下がった。影響を受けた画像では肺への注意が1.52倍に増え、それ以外では動かなかった(0.99倍)。ヘッドを動かしているのは、明るさや輪郭ではなく、文字そのものなのだ。
このパターンはほかでも繰り返される。NIH ChestX-ray14データセットの200枚のX線写真の79%で、そして別の2つのアーキテクチャ、DeiT-Base(ヘッドL9H2、88%)とViT-Large/16(ヘッドL8H8、80%)でも。
誰のテストにも見えない回路
中心となる結果は否定的なものだ。同じアーキテクチャで構築した5クラスのX線分類器で、L8H10をオフにすると予測の5%が変わった。だが、その頻度は正常な画像でも影響を受けた画像でも同じだった(p = 0.340)。独立に訓練した2つめの肺炎分類器でも、同じく何の効果も見られなかった。疑わしい3つのヘッド(L8H10、L7H2、L9H3)を一度にすべてオフにすると、変化は倍の10%になったが、やはり特有の効果はなかった(p = 0.532)。
著者らはこれを冗長性と解釈する。情報は多くの構成要素に分散しているので、最も目立つ担い手を取り除いても、残りがその仕事を引き受けるのだ。再訓練も役に立たない。X線で完全に微調整した後でも、影響を受けた123枚のうち121枚(98.4%)が依然としてヘッドを作動させた。ラベルづけの習慣が、画像がどの病院から、つまりどの病気から来たかを反映しているデータでは、スタンプが予測に役立ち続けるからだ。
出荷する前に内部を見よ
著者らによれば、危険なのは1つの誤診ではなく、モデルが病院を移ったときにスイッチが入る、隠れた脆弱性だ。彼らの勧告はこうだ。アテンションヘッドを監査し、担い手を特定し、それを因果的に検証する。そしてそれを導入前に行う。とくに施設をまたぐ場合には。彼らが知る唯一の確実な対策は、データの段階にある。注記を取り除いた画像で訓練するか、特定したヘッドに訓練中にペナルティを課すことだ。
限界も述べられている。隅の領域としきい値は、これらのデータセットに合わせて設定された。微調整の検証には200枚の画像しか使っていない。そして決定的な実験、つまり注記のある画像と注記を取り除いた同じ数の画像で訓練して比べる実験は、まだ行われていない。