A IA QUE LÊ O CARIMBO DO HOSPITAL EM VEZ DOS PULMÕES
Um classificador de radiografias de tórax pode aprender a ler o código que um hospital carimba no canto de cada imagem em vez da doença nos pulmões. Ele então funciona bem com dados desse hospital e falha silenciosamente no seguinte. Estudos anteriores documentaram isso em classificadores de COVID-19 e de pneumonia. O que não conseguiam dizer era qual parte do modelo faz a leitura, e se remover essa parte ajudaria.
As ferramentas habituais de explicação — mapas de calor como o Grad-CAM, o attention rollout, o LIME — mostram para onde um modelo olhou. Não identificam o componente responsável, nem conseguem estabelecer causalidade. Joshua Muhumuza e Cornelius Kalenzi, da Universidade Makerere, recorreram em vez disso ao conjunto de ferramentas da interpretabilidade mecanicista, desenvolvido para dissecar modelos de linguagem, e o aplicaram a um Vision Transformer.
De um hospital universitário a uma clínica distrital
Os autores descrevem o que está em jogo de forma concreta. Classificadores de radiografias baseados em transformers são cada vez mais usados para rastrear tuberculose e pneumonia em contextos com poucos recursos, muitas vezes treinados num grande hospital de referência e transferidos, sem nova auditoria, para hospitais distritais ou unidades móveis com outras máquinas, outro software e outros hábitos de identificação das imagens. Um modelo que aprendeu o carimbo do seu hospital de origem se degradaria no momento em que encontrasse uma clínica que não carimba nada, ou carimba outra coisa, em outro lugar.
Uma cabeça em 144
O modelo estudado, o ViT-Base/16 (o checkpoint público google/vit-base-patch16-224, pré-treinado no ImageNet-21k), divide cada imagem em 196 fragmentos (patches) e os processa através de 12 camadas com 12 cabeças de atenção cada. A equipe avaliou as 144 cabeças segundo o grau de foco e o alcance da sua atenção.
O foco aparece de repente nas camadas 7 a 9. Uma cabeça se destaca: L8H10, a cabeça 10 da camada 8. Ela coloca 34,6% da sua atenção num único fragmento — 2,8 vezes mais do que qualquer outra cabeça. Numa radiografia marcada “D CLINO” no canto superior esquerdo, ela dedica 0,346 da sua atenção a esse fragmento, 68 vezes o nível uniforme de 0,0051, enquanto os pulmões não recebem quase nada.
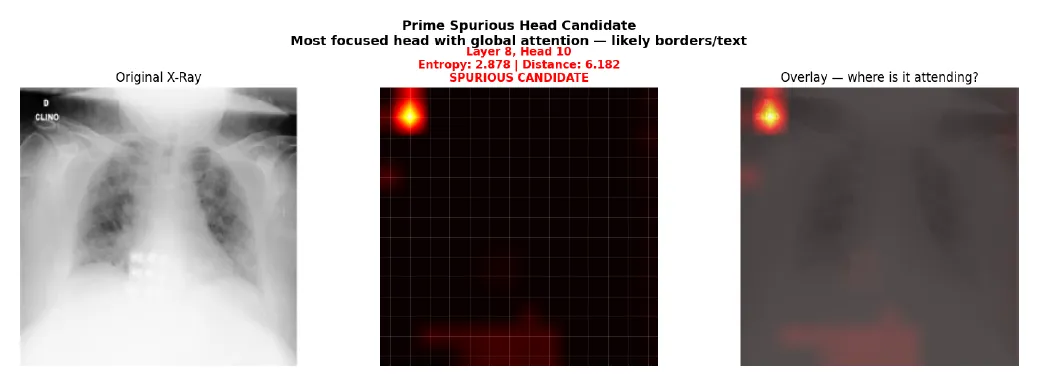
A cabeça L8H10 na primeira radiografia examinada: um ponto brilhante na anotação do canto, quase preto nos pulmões. — Figura 4, Muhumuza e Kalenzi (2026), arXiv:2610.21638.
Em 200 radiografias de COVID-19, a cabeça se comporta assim em 123 (62%). Nessas imagens, a atenção dada ao canto é em média 57,5 vezes a dada aos pulmões; nas outras, 0,77 vezes. Os dois grupos não se sobrepõem. O que prevê esse comportamento não é o brilho, mas o contraste local no canto — exatamente o que letras escuras sobre fundo claro produzem.
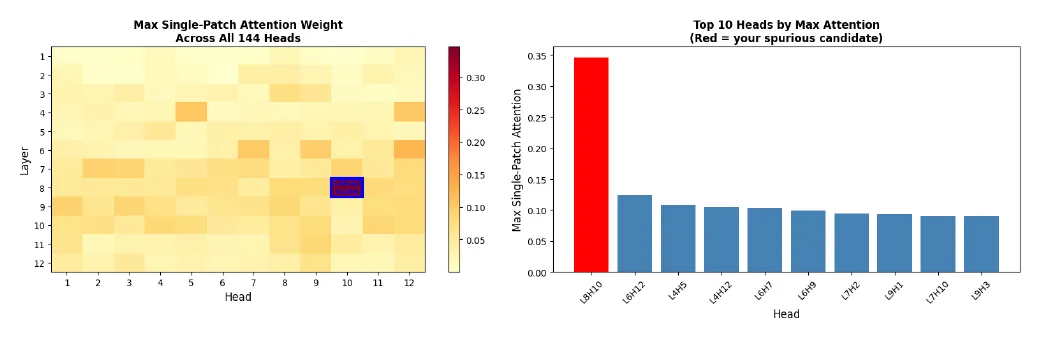
Atenção máxima num único fragmento para cada cabeça: L8H10 (vermelho) chega a 0,346, a seguinte a 0,124. — Figura 3, Muhumuza e Kalenzi (2026), arXiv:2610.21638.
A prova pelo apagamento
Mascarar o canto com cinza uniforme não é um teste limpo: um quadrado cinza uniforme tem, ele próprio, alto contraste e atrai a cabeça. Por isso, os autores fizeram inpainting do canto, preenchendo-o com uma textura realista de tecido. A atenção ao canto caiu então em 158 de 200 imagens (79%). Nas imagens afetadas, a atenção aos pulmões aumentou 1,52 vez; nas outras, não se alterou (0,99 vez). É o próprio texto, e não o brilho ou as bordas, que comanda a cabeça.
O padrão se repete em outros lugares: em 79% de 200 radiografias do conjunto de dados NIH ChestX-ray14 e em duas outras arquiteturas — DeiT-Base (cabeça L9H2, 88%) e ViT-Large/16 (cabeça L8H8, 80%).
O circuito que os testes de ninguém conseguem ver
O resultado central é negativo. Num classificador de radiografias de cinco classes construído sobre a mesma arquitetura, desligar a L8H10 alterou 5% das previsões — mas com a mesma frequência nas imagens normais e nas afetadas (p = 0,340). Um segundo classificador de pneumonia, treinado de forma independente, deu o mesmo resultado nulo. Desligar as três cabeças suspeitas de uma só vez (L8H10, L7H2, L9H3) dobrou as alterações para 10%, ainda sem efeito específico (p = 0,532).
Os autores interpretam isso como redundância: a informação está espalhada por muitos componentes, de modo que remover os portadores mais visíveis deixa o resto fazer o trabalho. Retreinar também não ajuda. Após um ajuste fino completo com radiografias, 121 das 123 imagens afetadas (98,4%) ainda acionavam a cabeça, porque o carimbo continua sendo preditivo em dados nos quais os hábitos de identificação acompanham o hospital — e as doenças — de onde vem cada imagem.
Olhe dentro antes de implantar
O perigo, escrevem os autores, não é um diagnóstico errado, mas uma vulnerabilidade oculta que se ativa quando um modelo muda de hospital. A sua recomendação: auditar as cabeças de atenção, identificar os portadores, verificá-los causalmente, e fazê-lo antes da implantação — sobretudo entre instituições diferentes. As únicas correções confiáveis que conhecem estão no nível dos dados: treinar com imagens sem anotações, ou penalizar as cabeças identificadas durante o treinamento.
Os limites também são declarados. A região do canto e o limiar foram definidos para estes conjuntos de dados; os testes de ajuste fino usaram apenas 200 imagens; e o experimento decisivo — treinar com imagens anotadas e com imagens sem anotações do mesmo tamanho — ainda está por fazer.