वह AI जो फेफड़ों के बजाय अस्पताल की मुहर पढ़ता है
छाती के एक्स-रे का कोई वर्गीकरणकर्ता फेफड़ों की बीमारी के बजाय वह कोड पढ़ना सीख सकता है जो अस्पताल हर चित्र के कोने में मुहर की तरह लगाता है। तब वह उस अस्पताल के डेटा पर अच्छा प्रदर्शन करता है और अगले अस्पताल में चुपचाप विफल हो जाता है। पहले के अध्ययनों ने कोविड-19 और निमोनिया वर्गीकरणकर्ताओं में यह दर्ज किया था। वे यह नहीं बता सके कि मॉडल का कौन-सा हिस्सा यह पढ़ाई करता है, और क्या उस हिस्से को हटाने से मदद मिलेगी।
व्याख्या के आम औज़ार — Grad-CAM जैसे हीट मैप, अटेंशन रोलआउट, LIME — दिखाते हैं कि मॉडल ने कहाँ देखा। वे ज़िम्मेदार घटक की पहचान नहीं करते, और कारण स्थापित नहीं कर सकते। मकेरेरे विश्वविद्यालय के जोशुआ मुहुमुज़ा (Joshua Muhumuza) और कॉर्नेलियस कालेंज़ी (Cornelius Kalenzi) ने इसके बजाय यांत्रिक व्याख्येयता (mechanistic interpretability) का औज़ार-बक्सा उधार लिया, जो भाषा मॉडलों की चीर-फाड़ के लिए विकसित हुआ था, और उसे एक विज़न ट्रांसफ़ॉर्मर (Vision Transformer) पर लागू किया।
एक शिक्षण अस्पताल से ज़िला क्लिनिक तक
लेखक दाँव को ठोस रूप में रखते हैं। ट्रांसफ़ॉर्मर-आधारित एक्स-रे वर्गीकरणकर्ता कम संसाधन वाले इलाक़ों में तपेदिक और निमोनिया की जाँच के लिए तेज़ी से इस्तेमाल हो रहे हैं; उन्हें अक्सर किसी बड़े रेफ़रल अस्पताल में प्रशिक्षित किया जाता है और बिना दोबारा जाँच के ज़िला अस्पतालों या चलती-फिरती इकाइयों में ले जाया जाता है, जहाँ मशीनें अलग, सॉफ़्टवेयर अलग और लेबल लगाने की आदतें अलग होती हैं। जिस मॉडल ने अपने मूल अस्पताल की मुहर सीख ली हो, उसका प्रदर्शन उसी पल गिर जाएगा जब वह किसी ऐसे क्लिनिक से मिलेगा जो कोई मुहर नहीं लगाता, या कहीं और कुछ और लगाता है।
144 में से एक हेड
अध्ययन किया गया मॉडल, ViT-Base/16 (सार्वजनिक चेकपॉइंट google/vit-base-patch16-224, ImageNet-21k पर पूर्व-प्रशिक्षित), हर चित्र को 196 पैचों में काटता है और उन्हें 12 परतों से गुज़ारता है, जिनमें से हर एक में 12 अटेंशन हेड हैं। टीम ने सभी 144 हेड को इस आधार पर अंक दिए कि उनका ध्यान कितना केंद्रित और कितनी दूर तक फैला था।
केंद्रण अचानक परत 7 से 9 में प्रकट होता है। एक हेड सबसे अलग है: L8H10, परत 8 का हेड 10। यह अपने ध्यान का 34.6% एक अकेले पैच पर लगाता है — किसी भी दूसरे हेड से 2.8 गुना ज़्यादा। ऊपरी बाएँ कोने में “D CLINO” लिखे एक एक्स-रे पर यह अपने ध्यान का 0.346 हिस्सा उस पैच पर लगाता है, जो 0.0051 के एकसमान स्तर का 68 गुना है, जबकि फेफड़ों को लगभग कुछ नहीं मिलता।
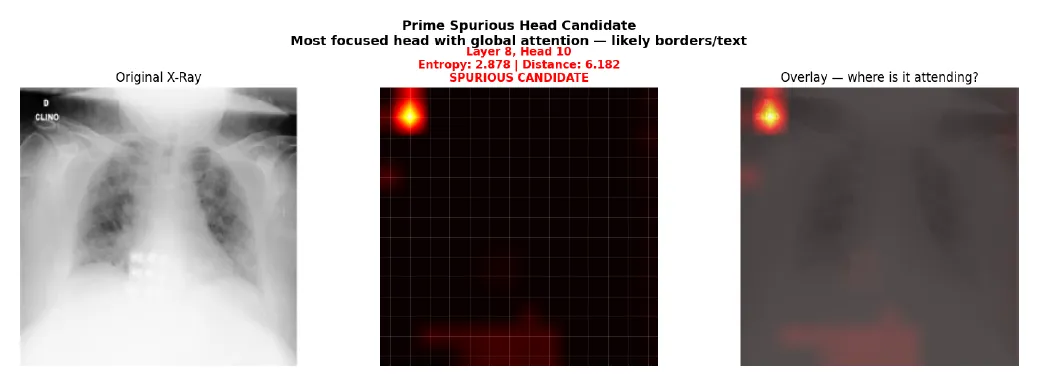
जाँचे गए पहले एक्स-रे पर हेड L8H10: कोने के एनोटेशन पर एक चमकीला धब्बा, फेफड़ों पर लगभग काला। — चित्र 4, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
कोविड-19 के 200 एक्स-रे में यह हेड 123 (62%) में ऐसा व्यवहार करता है। उन चित्रों में कोने पर ध्यान औसतन फेफड़ों पर ध्यान का 57.5 गुना है; बाक़ी में 0.77 गुना। दोनों समूह एक-दूसरे पर नहीं चढ़ते। इस व्यवहार का पूर्वानुमान चमक से नहीं, बल्कि कोने के स्थानीय कंट्रास्ट से होता है — ठीक वही जो हल्की पृष्ठभूमि पर गहरे अक्षर पैदा करते हैं।
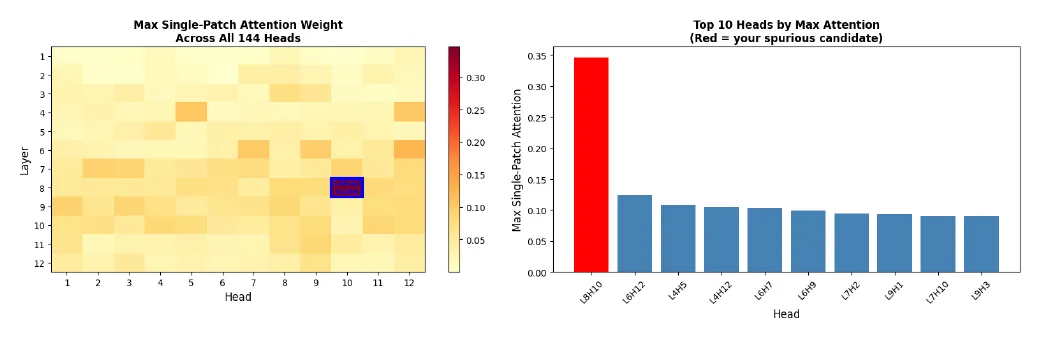
हर हेड के लिए अधिकतम एकल-पैच ध्यान: L8H10 (लाल) 0.346 पर है, अगला 0.124 पर। — चित्र 3, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
मिटाकर प्रमाण
कोने को सपाट स्लेटी रंग से ढकना साफ़ परीक्षण नहीं है: एकसमान स्लेटी वर्ग ख़ुद ऊँचे कंट्रास्ट वाला होता है और हेड को आकर्षित करता है। इसलिए लेखकों ने कोने को इनपेंट (inpaint) किया, यानी उसे यथार्थवादी ऊतक-बनावट से भर दिया। तब 200 में से 158 चित्रों (79%) में कोने पर ध्यान गिर गया। प्रभावित चित्रों में फेफड़ों पर ध्यान 1.52 गुना बढ़ा; बाक़ी में यह नहीं हिला (0.99 गुना)। हेड को चलाने वाला ख़ुद लिखा हुआ पाठ है, न कि चमक या किनारे।
यह पैटर्न दूसरी जगहों पर भी दोहराया जाता है: NIH ChestX-ray14 डेटासेट के 200 एक्स-रे में से 79% में, और दो दूसरी संरचनाओं में — DeiT-Base (हेड L9H2, 88%) और ViT-Large/16 (हेड L8H8, 80%)।
वह परिपथ जिसे किसी का परीक्षण नहीं देख पाता
केंद्रीय परिणाम नकारात्मक है। उसी संरचना पर बने पाँच-वर्गीय एक्स-रे वर्गीकरणकर्ता में L8H10 को बंद करने से 5% पूर्वानुमान बदले — लेकिन सामान्य चित्रों पर उतनी ही बार जितनी बार प्रभावित चित्रों पर (p = 0.340)। एक दूसरे, स्वतंत्र रूप से प्रशिक्षित निमोनिया वर्गीकरणकर्ता ने भी वही शून्य परिणाम दिया। तीनों संदिग्ध हेड (L8H10, L7H2, L9H3) को एक साथ बंद करने से बदलाव दोगुने होकर 10% हो गए, फिर भी कोई विशिष्ट प्रभाव नहीं (p = 0.532)।
लेखक इसे अतिरेकता (redundancy) के रूप में पढ़ते हैं: सूचना कई घटकों में फैली है, इसलिए सबसे दिखने वाले वाहकों को हटाने पर बाक़ी काम कर लेते हैं। दोबारा प्रशिक्षण से भी मदद नहीं मिलती। एक्स-रे पर पूरी फ़ाइन-ट्यूनिंग के बाद भी 123 प्रभावित चित्रों में से 121 (98.4%) हेड को सक्रिय करते रहे, क्योंकि जिस डेटा में लेबल लगाने की आदतें यह दर्शाती हैं कि चित्र किस अस्पताल — और किन बीमारियों — से आया है, उसमें मुहर पूर्वानुमान-योग्य बनी रहती है।
तैनाती से पहले भीतर देखिए
लेखक लिखते हैं कि ख़तरा कोई एक ग़लत निदान नहीं, बल्कि एक छिपी हुई कमज़ोरी है जो मॉडल के अस्पताल बदलने पर सक्रिय हो जाती है। उनकी सिफ़ारिश: अटेंशन हेड की जाँच कीजिए, वाहकों की पहचान कीजिए, कार्य-कारण के स्तर पर उनकी पुष्टि कीजिए, और यह तैनाती से पहले कीजिए — ख़ासकर संस्थानों के पार। उन्हें ज्ञात एकमात्र भरोसेमंद समाधान डेटा के स्तर पर हैं: एनोटेशन हटाए गए चित्रों पर प्रशिक्षण, या प्रशिक्षण के दौरान पहचाने गए हेड पर दंड लगाना।
सीमाएँ भी बताई गई हैं। कोने का क्षेत्र और सीमा-मान इन डेटासेटों के लिए तय किए गए थे; फ़ाइन-ट्यूनिंग परीक्षणों में केवल 200 चित्र इस्तेमाल हुए; और निर्णायक प्रयोग — समान आकार के एनोटेशन वाले बनाम एनोटेशन-रहित चित्रों पर प्रशिक्षण — अभी किया जाना बाक़ी है।