फुफ्फुसांऐवजी रुग्णालयाचा शिक्का वाचणारी AI
छातीच्या क्ष-किरण प्रतिमांचे वर्गीकरण करणारे मॉडेल फुफ्फुसांतील आजाराऐवजी रुग्णालय प्रत्येक प्रतिमेच्या कोपऱ्यात मारत असलेला कोड वाचायला शिकू शकते. मग ते त्या रुग्णालयाच्या डेटावर चांगली कामगिरी करते आणि पुढच्या रुग्णालयात गुपचूप अपयशी ठरते. आधीच्या अभ्यासांनी COVID-19 आणि न्यूमोनिया वर्गीकरण-मॉडेलमध्ये याची नोंद केली होती. ते सांगू शकले नव्हते ते असे की मॉडेलचा कोणता भाग हे वाचन करतो, आणि तो भाग काढून टाकल्याने काही उपयोग होईल का.
नेहमीची स्पष्टीकरण-साधने — Grad-CAM सारखे उष्मा-नकाशे, attention rollout, LIME — मॉडेलने कुठे पाहिले ते दाखवतात. ती जबाबदार घटक ओळखत नाहीत, आणि कार्यकारणभाव प्रस्थापित करू शकत नाहीत. माकेरेरे विद्यापीठातील जोशुआ मुहुमुझा (Joshua Muhumuza) आणि कॉर्नेलियस कालेन्झी (Cornelius Kalenzi) यांनी त्याऐवजी भाषा-मॉडेलचे विच्छेदन करण्यासाठी विकसित केलेली यांत्रिक अर्थबोधकतेची (mechanistic interpretability) साधने उसनी घेतली, आणि ती एका व्हिजन ट्रान्सफॉर्मरवर वापरली.
शिक्षण-रुग्णालयापासून जिल्हा दवाखान्यापर्यंत
लेखक नेमके काय पणाला लागले आहे हे ठोसपणे मांडतात. ट्रान्सफॉर्मर-आधारित क्ष-किरण वर्गीकरण-मॉडेल अल्प-संसाधन परिस्थितीत क्षयरोग आणि न्यूमोनियाच्या तपासणीसाठी अधिकाधिक वापरले जात आहेत; अनेकदा ते एका मोठ्या संदर्भ-रुग्णालयात प्रशिक्षित होतात आणि पुनर्तपासणी न करता, वेगळी यंत्रे, वेगळे सॉफ्टवेअर आणि लेबल लावण्याच्या वेगळ्या सवयी असलेल्या जिल्हा रुग्णालयांत किंवा फिरत्या पथकांकडे नेले जातात. आपल्या मूळ रुग्णालयाचा शिक्का शिकलेले मॉडेल, काहीही शिक्का न मारणाऱ्या, किंवा दुसरेच काहीतरी दुसरीकडेच मारणाऱ्या दवाखान्याशी गाठ पडताच ढासळेल.
144 पैकी एक शीर्ष
अभ्यासलेले मॉडेल, ViT-Base/16 (ImageNet-21k वर पूर्वप्रशिक्षित सार्वजनिक checkpoint google/vit-base-patch16-224), प्रत्येक प्रतिमेचे 196 तुकडे (patches) करते आणि प्रत्येकी 12 अवधान-शीर्षे असलेल्या 12 स्तरांमधून त्यांची प्रक्रिया करते. संघाने सर्व 144 शीर्षांना त्यांचे लक्ष किती केंद्रित आणि किती दूरपर्यंत पोहोचणारे आहे यावरून गुण दिले.
केंद्रीकरण स्तर 7 ते 9 मध्ये अचानक दिसू लागते. एक शीर्ष इतरांपासून वेगळे उठून दिसते: L8H10, स्तर 8 चे 10 वे शीर्ष. ते आपल्या लक्षाचा 34.6% भाग एकाच तुकड्यावर ठेवते — इतर कोणत्याही शीर्षापेक्षा 2.8 पट जास्त. वरच्या डाव्या कोपऱ्यात “D CLINO” असे लिहिलेल्या क्ष-किरण प्रतिमेवर, ते आपल्या लक्षाचा 0.346 भाग त्या तुकड्यावर ठेवते, म्हणजे 0.0051 या समान पातळीच्या 68 पट, तर फुफ्फुसांना जवळजवळ काहीच मिळत नाही.
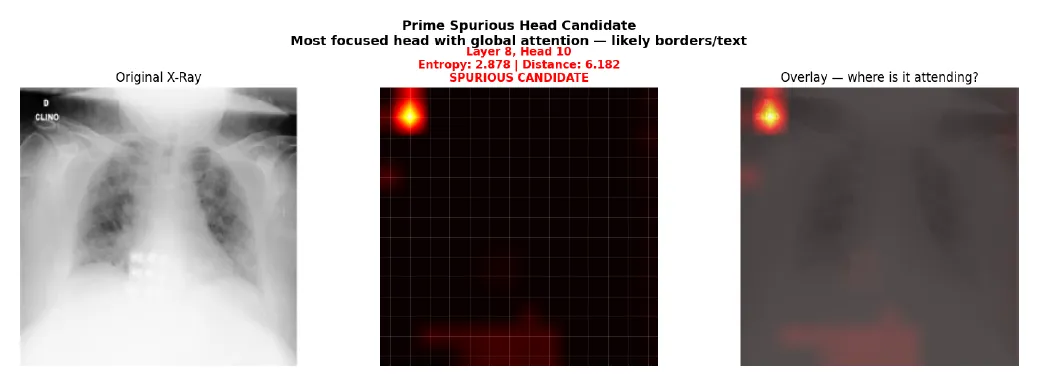
तपासलेल्या पहिल्या क्ष-किरण प्रतिमेवरील शीर्ष L8H10: कोपऱ्यातील टिपेवर एक तेजस्वी ठिपका, फुफ्फुसांवर जवळजवळ काळोख. — Figure 4, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
COVID-19 च्या 200 क्ष-किरण प्रतिमांपैकी, 123 (62%) प्रतिमांमध्ये हे शीर्ष असे वागते. त्या प्रतिमांमध्ये कोपऱ्यावरील लक्ष सरासरी फुफ्फुसांवरील लक्षाच्या 57.5 पट असते; इतरांमध्ये, 0.77 पट. हे दोन गट एकमेकांवर येत नाहीत. या वर्तनाचे भाकीत करणारी गोष्ट म्हणजे तेजस्विता नव्हे तर कोपऱ्यातील स्थानिक विरोधाभास (contrast) — नेमके तेच जे फिकट पार्श्वभूमीवरील गडद अक्षरे निर्माण करतात.
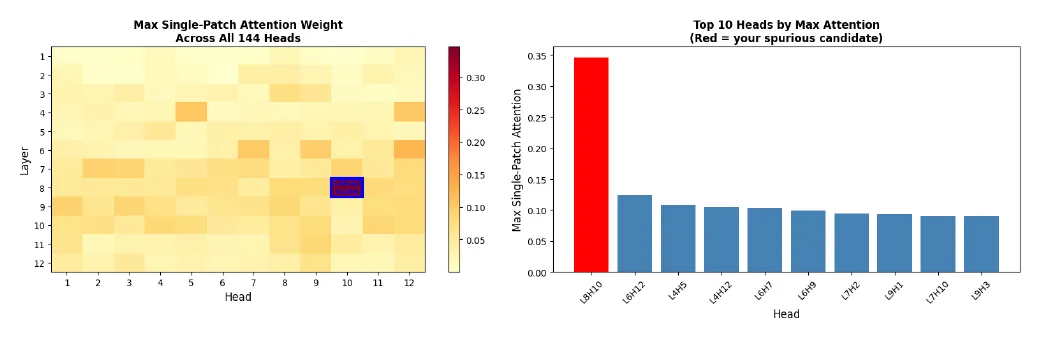
प्रत्येक शीर्षाचे एकाच तुकड्यावरील कमाल लक्ष: L8H10 (लाल) 0.346 वर, त्यानंतरचे 0.124 वर. — Figure 3, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
पुसून केलेली सिद्धता
कोपरा सपाट राखाडी रंगाने झाकणे ही स्वच्छ चाचणी नाही: एकसमान राखाडी चौकोन स्वतःच उच्च विरोधाभासाचा असतो आणि शीर्षाला आकर्षित करतो. म्हणून लेखकांनी त्याऐवजी कोपरा इनपेंट (inpainting) केला, म्हणजे खऱ्याखुऱ्या दिसणाऱ्या ऊतींच्या पोताने भरला. तेव्हा कोपऱ्यावरील लक्ष 200 पैकी 158 प्रतिमांमध्ये (79%) कमी झाले. प्रभावित प्रतिमांमध्ये फुफ्फुसांवरील लक्ष 1.52 पट वाढले; इतरांमध्ये ते हलले नाही (0.99 पट). तेजस्विता किंवा कडा नव्हे, तर मजकूरच शीर्षाला चालवतो.
हा आकृतिबंध इतरत्रही पुन्हा दिसतो: NIH ChestX-ray14 डेटासेटमधील 200 क्ष-किरण प्रतिमांपैकी 79% मध्ये, आणि इतर दोन रचनांमध्ये — DeiT-Base (शीर्ष L9H2, 88%) आणि ViT-Large/16 (शीर्ष L8H8, 80%).
कोणाच्याही चाचण्यांना न दिसणारे परिपथ
केंद्रीय निकाल नकारात्मक आहे. त्याच रचनेवर उभारलेल्या पाच-वर्गीय क्ष-किरण वर्गीकरण-मॉडेलमध्ये, L8H10 बंद केल्याने 5% भाकिते बदलली — पण सामान्य प्रतिमांवर आणि प्रभावित प्रतिमांवर तितक्याच वेळा (p = 0.340). स्वतंत्रपणे प्रशिक्षित केलेल्या दुसऱ्या न्यूमोनिया वर्गीकरण-मॉडेलनेही तोच शून्य-परिणाम दिला. तिन्ही संशयित शीर्षे (L8H10, L7H2, L9H3) एकाच वेळी बंद केल्यावर बदल दुप्पट होऊन 10% झाले, तरीही कोणताही विशिष्ट परिणाम नाही (p = 0.532).
लेखक याचा अर्थ अतिरेक (redundancy) असा लावतात: माहिती अनेक घटकांमध्ये पसरलेली असते, म्हणून सर्वांत दृश्य वाहक काढून टाकले तरी उरलेले घटक ते काम करतात. पुनर्प्रशिक्षणानेही उपयोग होत नाही. क्ष-किरण प्रतिमांवर संपूर्ण सूक्ष्म-समायोजन केल्यानंतरही, 123 पैकी 121 प्रभावित प्रतिमा (98.4%) शीर्ष सक्रिय करत होत्या, कारण ज्या डेटामध्ये लेबल लावण्याच्या सवयी प्रतिमा कोणत्या रुग्णालयातून — आणि कोणत्या आजारांतून — आली हे दर्शवतात, तिथे शिक्का भाकितासाठी उपयुक्त राहतो.
वापरात आणण्यापूर्वी आत डोकावा
लेखक लिहितात, धोका एखादे चुकीचे निदान हा नसून, मॉडेलने रुग्णालय बदलताच कार्यान्वित होणारी एक दडलेली असुरक्षितता हा आहे. त्यांची शिफारस: अवधान-शीर्षांचे लेखापरीक्षण करा, वाहक ओळखा, त्यांची कार्यकारणात्मक पडताळणी करा, आणि हे वापरात आणण्यापूर्वी करा — विशेषतः संस्थांच्या पलीकडे नेताना. त्यांना माहीत असलेले एकमेव विश्वसनीय उपाय डेटाच्या पातळीवर आहेत: टिपा काढून टाकलेल्या प्रतिमांवर प्रशिक्षण द्या, किंवा प्रशिक्षणादरम्यान ओळखलेल्या शीर्षांना दंड लावा.
मर्यादाही नमूद केल्या आहेत. कोपऱ्याचा प्रदेश आणि उंबरठा या डेटासेटसाठी ठरवले होते; सूक्ष्म-समायोजनाच्या चाचण्यांमध्ये फक्त 200 प्रतिमा वापरल्या; आणि निर्णायक प्रयोग — टिपा असलेल्या आणि टिपा काढलेल्या, समान संख्येच्या प्रतिमांवर प्रशिक्षण देऊन तुलना — अजून व्हायचा आहे.