AKCİĞERLER YERİNE HASTANE DAMGASINI OKUYAN YAPAY ZEKÂ
Bir göğüs röntgeni sınıflandırıcısı, akciğerlerdeki hastalık yerine hastanenin her görüntünün köşesine bastığı kodu okumayı öğrenebilir. O zaman o hastanenin verilerinde iyi performans gösterir ve bir sonrakinde sessizce başarısız olur. Önceki çalışmalar bunu COVID-19 ve zatürre sınıflandırıcıları için belgelemişti. Söyleyemedikleri şey, okumayı modelin hangi parçasının yaptığı ve o parçayı çıkarmanın işe yarayıp yaramayacağıydı.
Olağan açıklama araçları — Grad-CAM gibi ısı haritaları, attention rollout, LIME — bir modelin nereye baktığını gösterir. Sorumlu bileşeni belirlemezler ve nedensellik kuramazlar. Makerere Üniversitesi’nden Joshua Muhumuza ve Cornelius Kalenzi bunun yerine dil modellerini incelemek için geliştirilen mekanistik yorumlanabilirlik (mechanistic interpretability) araç takımını ödünç alıp bir Vision Transformer’a uyguladı.
Eğitim hastanesinden ilçe kliniğine
Yazarlar meseleyi somut biçimde ortaya koyuyor. Transformer tabanlı röntgen sınıflandırıcıları, kaynakları kısıtlı ortamlarda tüberküloz ve zatürre taraması için giderek daha çok kullanılıyor; çoğu zaman büyük bir sevk hastanesinde eğitilip yeniden denetlenmeden farklı makinelere, farklı yazılımlara ve farklı etiketleme alışkanlıklarına sahip ilçe hastanelerine ya da mobil birimlere taşınıyorlar. Kendi hastanesinin damgasını öğrenmiş bir model, hiçbir şey basmayan ya da başka bir yere başka bir şey basan bir klinikle karşılaştığı anda bozulur.
144 kafadan biri
İncelenen model ViT-Base/16 (ImageNet-21k üzerinde önceden eğitilmiş, kamuya açık google/vit-base-patch16-224 kontrol noktası), her görüntüyü 196 parçaya (patch) bölüyor ve bunları her birinde 12 dikkat kafası bulunan 12 katmandan geçiriyor. Ekip 144 kafanın tümünü, dikkatlerinin ne kadar odaklı ve ne kadar geniş erimli olduğuna göre puanladı.
Odaklanma 7 ile 9. katmanlarda birden ortaya çıkıyor. Bir kafa ayrı duruyor: L8H10, 8. katmanın 10. kafası. Dikkatinin %34,6’sını tek bir parçaya veriyor — başka herhangi bir kafanın 2,8 katı. Sol üst köşesinde “D CLINO” yazan bir röntgende dikkatinin 0,346’sını o parçaya veriyor; bu, 0,0051’lik düzgün düzeyin 68 katı; akciğerler ise neredeyse hiçbir şey almıyor.
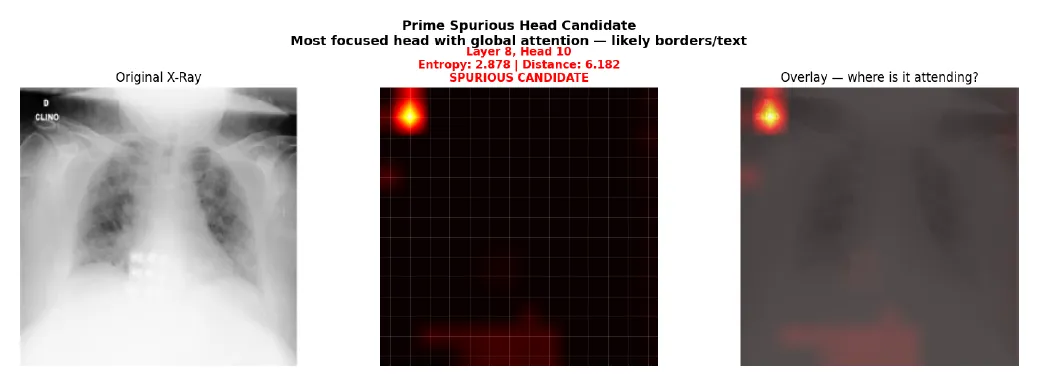
İncelenen ilk röntgende L8H10 kafası: köşedeki açıklama üzerinde tek parlak bir nokta, akciğerlerde neredeyse siyah. — Şekil 4, Muhumuza ve Kalenzi (2026), arXiv:2610.21638.
200 COVID-19 röntgeninde kafa bu şekilde davranıyor: 123’ünde (%62). Bu görüntülerde köşeye verilen dikkat, ortalamada akciğerlere verilen dikkatin 57,5 katı; diğerlerinde 0,77 katı. İki grup örtüşmüyor. Bu davranışı öngören şey parlaklık değil, köşedeki yerel kontrast — tam da açık bir zemin üzerindeki koyu harflerin ürettiği şey.
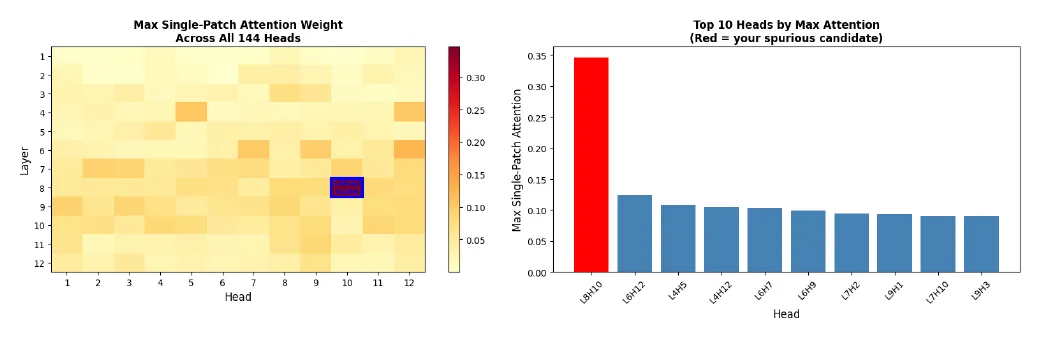
Her kafa için tek parçaya verilen en yüksek dikkat: L8H10 (kırmızı) 0,346’da, bir sonraki 0,124’te. — Şekil 3, Muhumuza ve Kalenzi (2026), arXiv:2610.21638.
Silerek kanıt
Köşeyi düz griyle örtmek temiz bir test değil: düzgün gri bir kare kendisi yüksek kontrastlıdır ve kafayı çeker. Bu yüzden yazarlar köşeyi bunun yerine gerçekçi doku dokusuyla doldurarak onardı (inpainting). Köşeye verilen dikkat bunun üzerine 200 görüntünün 158’inde (%79) düştü. Etkilenen görüntülerde akciğerlere verilen dikkat 1,52 kat arttı; diğerlerinde hiç kıpırdamadı (0,99 kat). Kafayı süren şey parlaklık ya da kenarlar değil, yazının kendisi.
Örüntü başka yerlerde de yineleniyor: NIH ChestX-ray14 veri setinden 200 röntgenin %79’unda ve iki başka mimaride — DeiT-Base (L9H2 kafası, %88) ve ViT-Large/16 (L8H8 kafası, %80).
Kimsenin testlerinin göremediği devre
Asıl sonuç olumsuz. Aynı mimari üzerine kurulmuş beş sınıflı bir röntgen sınıflandırıcısında L8H10’u kapatmak tahminlerin %5’ini değiştirdi — ama normal görüntülerde de etkilenenlerde olduğu kadar sık (p = 0,340). Bağımsız olarak eğitilmiş ikinci bir zatürre sınıflandırıcısı da aynı boş sonucu verdi. Şüpheli üç kafanın hepsini birden (L8H10, L7H2, L9H3) kapatmak değişiklikleri %10’a çıkardı, yine özgül bir etki olmaksızın (p = 0,532).
Yazarlar bunu yedeklilik (redundancy) olarak okuyor: bilgi birçok bileşene yayılmış, dolayısıyla en görünür taşıyıcıları çıkarmak işi geri kalanlara bırakıyor. Yeniden eğitim de işe yaramıyor. Röntgenler üzerinde tam ince ayardan sonra, etkilenen 123 görüntünün 121’i (%98,4) kafayı hâlâ tetikledi; çünkü etiketleme alışkanlıklarının bir görüntünün hangi hastaneden — ve hangi hastalıklardan — geldiğini izlediği verilerde damga öngörü gücünü koruyor.
Kullanıma sunmadan önce içine bakın
Yazarlara göre tehlike tek bir yanlış teşhis değil, bir model hastane değiştirdiğinde devreye giren gizli bir zafiyet. Önerileri: dikkat kafalarını denetlemek, taşıyıcıları belirlemek, bunları nedensel olarak doğrulamak ve bunu kullanıma sunmadan önce — özellikle kurumlar arasında — yapmak. Bildikleri tek güvenilir çözümler veri düzeyinde: açıklamalarından arındırılmış görüntülerle eğitmek ya da belirlenen kafaları eğitim sırasında cezalandırmak.
Sınırlar da belirtiliyor. Köşe bölgesi ve eşik bu veri setleri için ayarlandı; ince ayar testlerinde yalnızca 200 görüntü kullanıldı; ve belirleyici deney — aynı büyüklükte, açıklamalı ve arındırılmış görüntülerle eğitimi karşılaştırmak — henüz yapılmadı.