ИИ, КОТОРЫЙ ЧИТАЕТ БОЛЬНИЧНЫЙ ШТАМП ВМЕСТО ЛЁГКИХ
Классификатор рентгенограмм грудной клетки может научиться читать код, который больница проставляет в углу каждого снимка, а не болезнь в лёгких. Тогда он хорошо работает на данных этой больницы и тихо ошибается в следующей. Предыдущие исследования зафиксировали это у классификаторов COVID-19 и пневмонии. Чего они не могли сказать — какая часть модели этим чтением занимается и поможет ли её удаление.
Привычные инструменты объяснения — тепловые карты вроде Grad-CAM, attention rollout, LIME — показывают, куда смотрела модель. Они не указывают ответственный компонент и не могут установить причинность. Джошуа Мухумуза и Корнелиус Каленци из Университета Макерере вместо этого позаимствовали инструментарий механистической интерпретируемости, созданный для препарирования языковых моделей, и применили его к визуальному трансформеру (Vision Transformer).
Из университетской клиники — в районную больницу
Авторы конкретно описывают, что поставлено на карту. Классификаторы рентгенограмм на основе трансформеров всё шире используются для скрининга туберкулёза и пневмонии в условиях ограниченных ресурсов; часто их обучают в крупной больнице третьего уровня и переносят, без повторного аудита, в районные больницы или мобильные пункты с другими аппаратами, другим программным обеспечением и другими привычками маркировки снимков. Модель, выучившая штамп родной больницы, начнёт работать хуже в тот самый момент, когда попадёт в клинику, которая ничего не штампует — или штампует что-то другое и в другом месте.
Одна голова из 144
Изучаемая модель ViT-Base/16 (общедоступный чекпойнт google/vit-base-patch16-224, предобученный на ImageNet-21k) разрезает каждое изображение на 196 фрагментов (патчей) и пропускает их через 12 слоёв по 12 голов внимания в каждом. Команда оценила все 144 головы по тому, насколько сфокусировано их внимание и насколько далеко оно простирается.
Фокус резко появляется в слоях 7–9. Одна голова стоит особняком: L8H10, голова 10 слоя 8. Она уделяет 34,6% своего внимания одному-единственному фрагменту — в 2,8 раза больше, чем любая другая голова. На рентгенограмме с пометкой «D CLINO» в левом верхнем углу она отдаёт этому фрагменту 0,346 своего внимания — в 68 раз больше равномерного уровня 0,0051, — а лёгким не достаётся почти ничего.
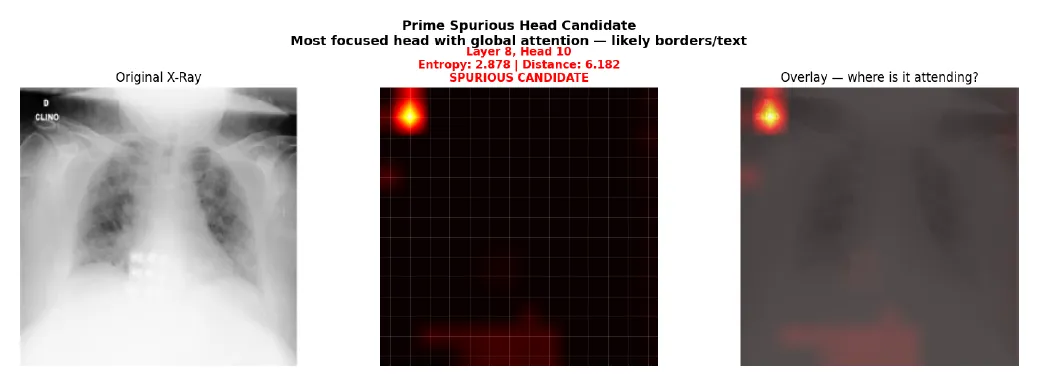
Голова L8H10 на первой изученной рентгенограмме: одно яркое пятно на угловой надписи, почти чёрный цвет на лёгких. — Рисунок 4, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
Из 200 рентгенограмм с COVID-19 голова ведёт себя так на 123 (62%). На этих снимках внимание к углу в среднем в 57,5 раза больше внимания к лёгким; на остальных — 0,77. Две группы не пересекаются. Такое поведение предсказывает не яркость, а локальный контраст в углу — ровно то, что дают тёмные буквы на светлом фоне.
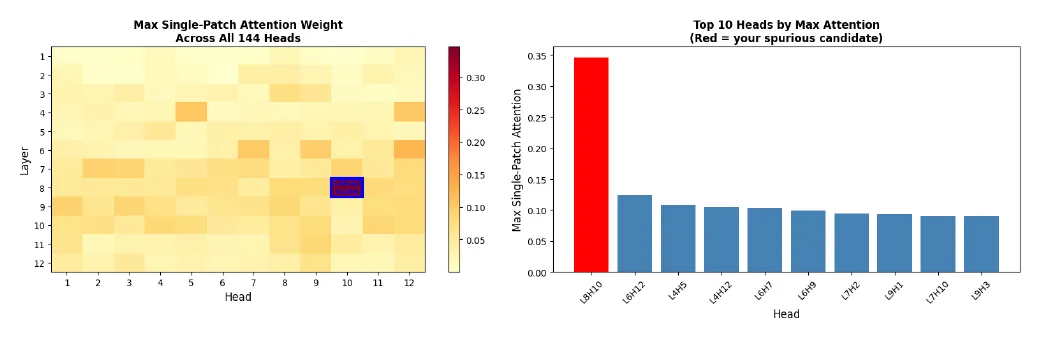
Максимальное внимание к одному фрагменту для каждой головы: L8H10 (красный) достигает 0,346, следующая — 0,124. — Рисунок 3, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
Доказательство стиранием
Закрыть угол однородным серым цветом — нечистый тест: однородный серый квадрат сам по себе высококонтрастен и притягивает голову. Поэтому авторы применили к углу инпейнтинг, заполнив его реалистичной текстурой тканей. Внимание к углу после этого упало на 158 из 200 снимков (79%). На затронутых снимках внимание к лёгким выросло в 1,52 раза; на остальных не изменилось (0,99). Голову направляет именно текст, а не яркость или края.
Закономерность повторяется и в других случаях: на 79% из 200 рентгенограмм набора данных NIH ChestX-ray14 и в двух других архитектурах — DeiT-Base (голова L9H2, 88%) и ViT-Large/16 (голова L8H8, 80%).
Цепь, которую не видят ничьи тесты
Главный результат — отрицательный. В пятиклассовом классификаторе рентгенограмм на той же архитектуре отключение L8H10 изменило 5% предсказаний — но одинаково часто на нормальных и на затронутых снимках (p = 0,340). Второй, независимо обученный классификатор пневмонии дал такой же нулевой результат. Одновременное отключение всех трёх подозрительных голов (L8H10, L7H2, L9H3) удвоило долю изменений до 10%, по-прежнему без специфического эффекта (p = 0,532).
Авторы объясняют это избыточностью: информация распределена по многим компонентам, и если убрать самых заметных её носителей, работу выполнят остальные. Переобучение тоже не помогает. После полного дообучения на рентгенограммах 121 из 123 затронутых снимков (98,4%) по-прежнему активировали голову, потому что штамп остаётся предсказательным признаком в данных, где привычки маркировки отражают, из какой больницы — и с какими болезнями — поступил снимок.
Загляните внутрь до внедрения
Опасность, пишут авторы, — не один неверный диагноз, а скрытая уязвимость, которая срабатывает, когда модель меняет больницу. Их рекомендация: проводить аудит голов внимания, выявлять носителей, проверять их причинную роль — и делать это до внедрения, особенно при переносе между учреждениями. Единственные надёжные способы исправления, которые им известны, лежат на уровне данных: обучать на снимках, очищенных от надписей, или штрафовать выявленные головы в ходе обучения.
Ограничения тоже названы. Угловая область и порог подбирались под эти наборы данных; в тестах дообучения использовалось всего 200 снимков; а решающий эксперимент — обучение на снимках с надписями и без них при одинаковом объёме данных — ещё предстоит провести.