الذكاء الاصطناعي الذي يقرأ ختم المستشفى بدلًا من الرئتين
قد يتعلم مصنِّف صور الأشعة السينية للصدر قراءة الرمز الذي يختم به المستشفى زاوية كل صورة بدلًا من المرض في الرئتين. فيؤدي أداءً جيدًا على بيانات ذلك المستشفى ثم يخفق بصمت في المستشفى التالي. وقد وثّقت دراسات سابقة ذلك في مصنِّفات كوفيد-19 والالتهاب الرئوي. لكنها لم تستطع أن تحدد أي جزء من النموذج يقوم بهذه القراءة، ولا ما إذا كان حذف ذلك الجزء سيفيد.
أدوات التفسير المعتادة — خرائط الحرارة مثل Grad-CAM، وتجميع الانتباه (attention rollout)، وLIME — تُظهر أين نظر النموذج. لكنها لا تحدد المكوّن المسؤول، ولا تستطيع إثبات السببية. فاستعار جوشوا موهوموزا (Joshua Muhumuza) وكورنيليوس كالينزي (Cornelius Kalenzi)، من جامعة ماكيريري، بدلًا من ذلك أدوات القابلية للتفسير الآلي (mechanistic interpretability)، التي طُوّرت لتشريح نماذج اللغة، وطبّقاها على محوّل رؤية (Vision Transformer).
من مستشفى تعليمي إلى عيادة في منطقة نائية
يطرح المؤلفان ما على المحك بشكل ملموس. فمصنِّفات الأشعة السينية القائمة على المحوّلات تُستخدم أكثر فأكثر لفحص السل والالتهاب الرئوي في البيئات محدودة الموارد، وكثيرًا ما تُدرَّب في مستشفى إحالة كبير ثم تُنقل، من دون إعادة تدقيق، إلى مستشفيات المناطق أو الوحدات المتنقلة التي تختلف فيها الأجهزة والبرمجيات وعادات وضع الملصقات. والنموذج الذي تعلّم ختم مستشفاه الأصلي سيتدهور أداؤه لحظة لقائه عيادة لا تختم شيئًا، أو تختم شيئًا آخر في مكان آخر.
رأس واحد من أصل 144
يقطّع النموذج المدروس، ViT-Base/16 (نقطة الحفظ العامة google/vit-base-patch16-224، المدرَّبة مسبقًا على ImageNet-21k)، كل صورة إلى 196 رقعة ويعالجها عبر 12 طبقة، في كلٍّ منها 12 رأس انتباه. ومنح الفريق درجات لكل الرؤوس الـ144 بحسب مدى تركيز انتباهها ومدى امتداده.
يظهر التركيز فجأة في الطبقات من 7 إلى 9. ويتميز رأس واحد: L8H10، أي الرأس 10 في الطبقة 8. فهو يضع 34.6% من انتباهه على رقعة واحدة — أي 2.8 مرة أكثر من أي رأس آخر. وعلى صورة أشعة كُتب في زاويتها العليا اليسرى «D CLINO»، يضع 0.346 من انتباهه على تلك الرقعة، أي 68 ضعف المستوى المنتظم البالغ 0.0051، بينما لا تكاد الرئتان تنالان شيئًا.
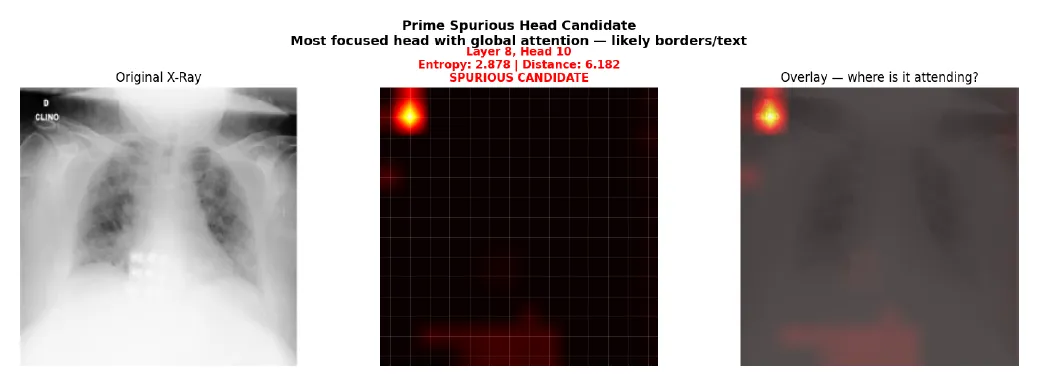
الرأس L8H10 على أول صورة أشعة فُحصت: بقعة ساطعة واحدة على التعليق المكتوب في الزاوية، وسواد شبه تام على الرئتين. — الشكل 4، Muhumuza وKalenzi (2026)، arXiv:2610.21638.
ومن بين 200 صورة أشعة لمرضى كوفيد-19، يتصرف الرأس على هذا النحو في 123 صورة (62%). وفي هذه الصور، يبلغ الانتباه إلى الزاوية في المتوسط 57.5 ضعف الانتباه إلى الرئتين؛ وفي الصور الأخرى 0.77 ضعفًا. ولا تتداخل المجموعتان. وما يتنبأ بهذا السلوك ليس السطوع بل التباين المحلي في الزاوية — وهو بالضبط ما تنتجه حروف داكنة على خلفية فاتحة.
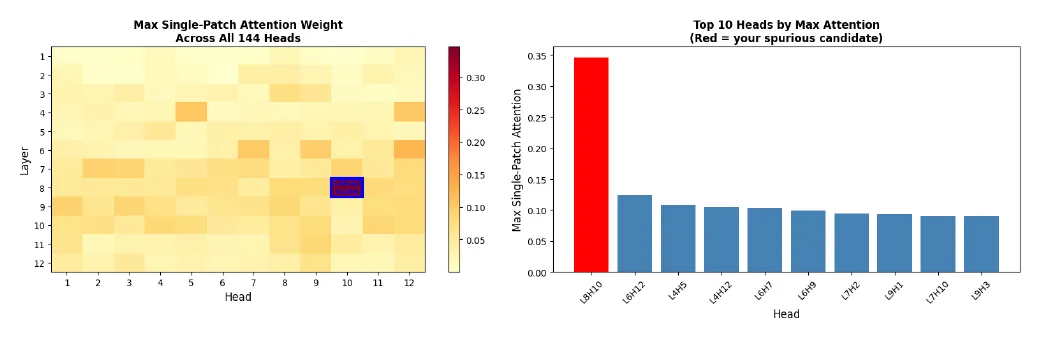
أقصى انتباه لرقعة واحدة لكل رأس: يبلغ L8H10 (بالأحمر) 0.346، والذي يليه 0.124. — الشكل 3، Muhumuza وKalenzi (2026)، arXiv:2610.21638.
البرهان بالمحو
إخفاء الزاوية بلون رمادي مسطّح ليس اختبارًا نظيفًا: فالمربع الرمادي المنتظم هو نفسه عالي التباين ويجذب الرأس. لذا لجأ المؤلفان إلى الترميم الرقمي (inpainting) للزاوية، فملآها بنسيج واقعي يحاكي الأنسجة. فانخفض الانتباه إلى الزاوية في 158 صورة من أصل 200 (79%). وفي الصور المتأثرة، ارتفع الانتباه إلى الرئتين 1.52 ضعفًا؛ أما في الصور الأخرى فلم يتحرك (0.99 ضعفًا). فالنص نفسه، لا السطوع ولا الحواف، هو ما يحرّك الرأس.
ويتكرر النمط في أماكن أخرى: في 79% من 200 صورة أشعة من مجموعة بيانات NIH ChestX-ray14، وفي بنيتين أخريين — DeiT-Base (الرأس L9H2، 88%) وViT-Large/16 (الرأس L8H8، 80%).
الدارة التي لا تراها اختبارات أحد
النتيجة المركزية سلبية. ففي مصنِّف أشعة سينية بخمس فئات مبني على البنية نفسها، غيّر إيقاف L8H10 نسبة 5% من التنبؤات — لكن بالتواتر نفسه في الصور الطبيعية والصور المتأثرة (p = 0.340). وأعطى مصنِّف ثانٍ للالتهاب الرئوي، دُرّب على نحو مستقل، النتيجة الصفرية نفسها. وإيقاف الرؤوس المشبوهة الثلاثة معًا (L8H10 وL7H2 وL9H3) ضاعف التغييرات إلى 10%، ومع ذلك بلا أثر خاص (p = 0.532).
يقرأ المؤلفان ذلك على أنه تكرار وظيفي (redundancy): فالمعلومة موزعة على مكوّنات كثيرة، وحذف أكثر حامليها وضوحًا يترك للبقية إنجاز المهمة. ولا تنفع إعادة التدريب أيضًا. فبعد ضبط دقيق كامل على صور الأشعة، ظلت 121 صورة من الصور المتأثرة الـ123 (98.4%) تُفعِّل الرأس، لأن الختم يبقى ذا قدرة تنبؤية في بيانات تعكس فيها عادات وضع الملصقات المستشفى الذي جاءت منه الصورة — والأمراض التي جاءت منها.
انظر إلى الداخل قبل النشر
يكتب المؤلفان أن الخطر ليس تشخيصًا خاطئًا واحدًا، بل ثغرة خفية تنشط حين ينتقل النموذج إلى مستشفى آخر. وتوصيتهما: تدقيق رؤوس الانتباه، وتحديد الحاملين، والتحقق منهم سببيًا، والقيام بذلك قبل النشر — ولا سيما عبر المؤسسات المختلفة. والحلول الموثوقة الوحيدة التي يعرفانها تقع على مستوى البيانات: التدريب على صور جُرّدت من التعليقات المكتوبة، أو معاقبة الرؤوس المحددة أثناء التدريب.
والحدود مذكورة أيضًا. فمنطقة الزاوية والعتبة حُدّدتا لهذه المجموعات من البيانات؛ واستخدمت اختبارات الضبط الدقيق 200 صورة فقط؛ أما التجربة الحاسمة — التدريب على صور تحمل تعليقات مقابل صور مجرّدة منها بالحجم نفسه — فلم تُجرَ بعد.