AI ĐỌC CON DẤU BỆNH VIỆN THAY VÌ ĐỌC PHỔI
Một bộ phân loại X-quang ngực có thể học cách đọc mã mà bệnh viện đóng dấu ở góc mỗi ảnh thay vì đọc bệnh trong phổi. Khi đó nó hoạt động tốt trên dữ liệu của bệnh viện đó và thất bại lặng lẽ ở bệnh viện kế tiếp. Các nghiên cứu trước đây đã ghi nhận điều này ở các bộ phân loại COVID-19 và viêm phổi. Điều họ không thể nói là bộ phận nào của mô hình thực hiện việc đọc, và liệu loại bỏ bộ phận đó có giúp ích hay không.
Các công cụ giải thích thông thường — bản đồ nhiệt như Grad-CAM, attention rollout, LIME — cho thấy mô hình đã nhìn vào đâu. Chúng không xác định được thành phần chịu trách nhiệm, và không thể thiết lập quan hệ nhân quả. Joshua Muhumuza và Cornelius Kalenzi, tại Đại học Makerere, thay vào đó đã mượn bộ công cụ của khả năng diễn giải cơ chế (mechanistic interpretability), vốn được phát triển để mổ xẻ các mô hình ngôn ngữ, và áp dụng nó cho một Vision Transformer.
Từ bệnh viện giảng dạy đến phòng khám huyện
Các tác giả trình bày mức độ hệ trọng một cách cụ thể. Các bộ phân loại X-quang dựa trên Transformer ngày càng được dùng để sàng lọc bệnh lao và viêm phổi ở những nơi thiếu nguồn lực, thường được huấn luyện tại một bệnh viện tuyến trên lớn rồi chuyển, mà không kiểm định lại, sang các bệnh viện huyện hoặc đơn vị lưu động với máy móc khác, phần mềm khác và thói quen dán nhãn khác. Một mô hình đã học con dấu của bệnh viện gốc sẽ suy giảm ngay khi gặp một phòng khám không đóng dấu gì, hoặc đóng một thứ khác, ở một chỗ khác.
Một đầu trong số 144
Mô hình được nghiên cứu, ViT-Base/16 (checkpoint công khai google/vit-base-patch16-224, được tiền huấn luyện trên ImageNet-21k), cắt mỗi ảnh thành 196 mảnh (patch) và xử lý chúng qua 12 tầng, mỗi tầng 12 đầu chú ý. Nhóm nghiên cứu chấm điểm cả 144 đầu theo mức độ tập trung và tầm vươn xa của sự chú ý.
Sự tập trung xuất hiện đột ngột ở các tầng 7 đến 9. Một đầu tách biệt hẳn: L8H10, đầu số 10 của tầng 8. Nó dồn 34,6% sự chú ý vào một mảnh duy nhất — gấp 2,8 lần bất kỳ đầu nào khác. Trên một phim X-quang có ghi “D CLINO” ở góc trên bên trái, nó đặt 0,346 sự chú ý vào mảnh đó, gấp 68 lần mức đồng đều 0,0051, trong khi phổi gần như không nhận được gì.
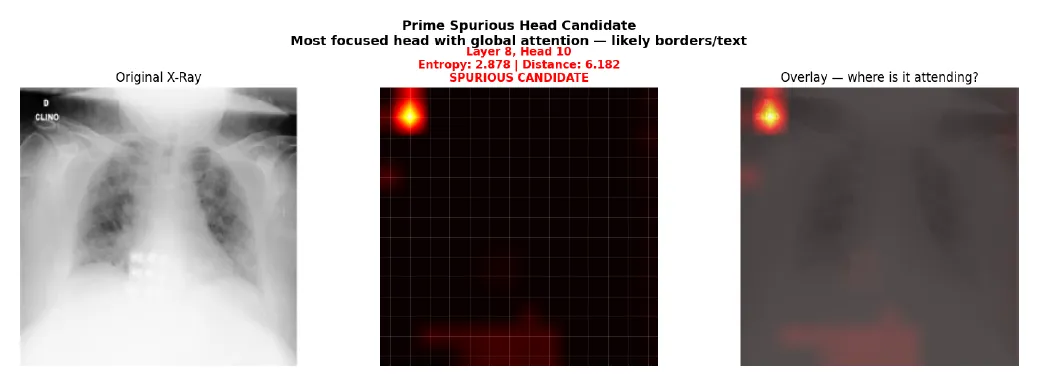
Đầu L8H10 trên phim X-quang đầu tiên được xem xét: một điểm sáng trên chú thích ở góc, gần như đen kịt trên phổi. — Figure 4, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
Trong 200 phim X-quang COVID-19, đầu này hành xử như vậy ở 123 phim (62%). Ở những ảnh đó, sự chú ý vào góc trung bình gấp 57,5 lần sự chú ý vào phổi; ở những ảnh còn lại, chỉ 0,77 lần. Hai nhóm không chồng lấn nhau. Điều dự báo hành vi này không phải độ sáng mà là độ tương phản cục bộ ở góc — đúng thứ mà chữ tối trên nền sáng tạo ra.
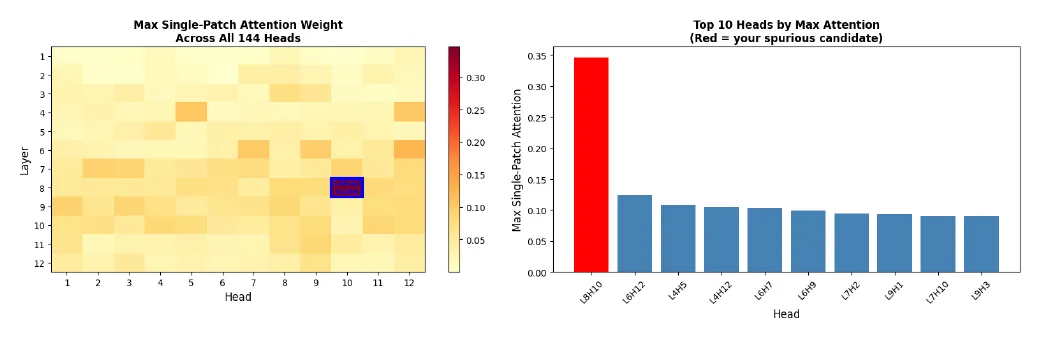
Sự chú ý cực đại vào một mảnh duy nhất của mọi đầu: L8H10 (đỏ) đạt 0,346, đầu kế tiếp 0,124. — Figure 3, Muhumuza and Kalenzi (2026), arXiv:2610.21638.
Chứng minh bằng cách xóa
Che góc ảnh bằng màu xám phẳng không phải là một phép thử sạch: một ô vuông xám đồng nhất tự nó đã có độ tương phản cao và thu hút đầu chú ý. Vì vậy các tác giả thay vào đó tô phục hồi (inpainting) góc ảnh, lấp đầy nó bằng kết cấu mô trông như thật. Sự chú ý vào góc khi đó giảm ở 158 trên 200 ảnh (79%). Ở những ảnh bị ảnh hưởng, sự chú ý vào phổi tăng 1,52 lần; ở những ảnh khác, nó không đổi (0,99 lần). Chính dòng chữ, chứ không phải độ sáng hay đường viền, điều khiển đầu chú ý.
Khuôn mẫu lặp lại ở những nơi khác: ở 79% trong 200 phim X-quang từ bộ dữ liệu NIH ChestX-ray14, và ở hai kiến trúc khác — DeiT-Base (đầu L9H2, 88%) và ViT-Large/16 (đầu L8H8, 80%).
Mạch mà không phép thử nào thấy được
Kết quả trung tâm là một kết quả âm tính. Trong một bộ phân loại X-quang năm lớp xây dựng trên cùng kiến trúc, tắt L8H10 làm thay đổi 5% số dự đoán — nhưng thường xuyên như nhau trên ảnh bình thường cũng như trên ảnh bị ảnh hưởng (p = 0,340). Một bộ phân loại viêm phổi thứ hai, được huấn luyện độc lập, cho cùng kết quả không có tác động. Tắt cùng lúc cả ba đầu đáng ngờ (L8H10, L7H2, L9H3) làm số thay đổi tăng gấp đôi lên 10%, vẫn không có tác động đặc hiệu nào (p = 0,532).
Các tác giả diễn giải điều này là tính dư thừa: thông tin được phân tán trên nhiều thành phần, nên loại bỏ những thành phần mang thông tin dễ thấy nhất thì phần còn lại vẫn làm được việc. Huấn luyện lại cũng không giúp gì. Sau khi tinh chỉnh toàn bộ trên ảnh X-quang, 121 trên 123 ảnh bị ảnh hưởng (98,4%) vẫn kích hoạt đầu chú ý, vì con dấu vẫn có giá trị dự báo trong những dữ liệu mà thói quen dán nhãn phản ánh việc ảnh đến từ bệnh viện nào — và từ bệnh nào.
Nhìn vào bên trong trước khi đưa vào sử dụng
Theo các tác giả, mối nguy không phải là một chẩn đoán sai, mà là một lỗ hổng ẩn giấu sẽ bật lên khi mô hình chuyển sang bệnh viện khác. Khuyến nghị của họ: kiểm định các đầu chú ý, xác định những thành phần mang thông tin, xác minh chúng theo quan hệ nhân quả, và làm điều đó trước khi triển khai — đặc biệt là giữa các cơ sở khác nhau. Những cách khắc phục đáng tin cậy duy nhất mà họ biết nằm ở cấp độ dữ liệu: huấn luyện trên ảnh đã được loại bỏ chú thích, hoặc phạt các đầu đã xác định trong quá trình huấn luyện.
Các giới hạn cũng được nêu rõ. Vùng góc và ngưỡng được đặt riêng cho các bộ dữ liệu này; các phép thử tinh chỉnh chỉ dùng 200 ảnh; và thí nghiệm quyết định — huấn luyện trên ảnh có chú thích so với ảnh đã loại bỏ chú thích với cùng số lượng — vẫn còn phải thực hiện.