وہ مصنوعی ذہانت جو پھیپھڑوں کے بجائے ہسپتال کی مہر پڑھتی ہے
سینے کے ایکس رے کی درجہ بندی کرنے والا ماڈل پھیپھڑوں کی بیماری کے بجائے وہ کوڈ پڑھنا سیکھ سکتا ہے جو ہسپتال ہر تصویر کے کونے پر لگاتا ہے۔ پھر وہ اس ہسپتال کے ڈیٹا پر اچھا کام کرتا ہے اور اگلے ہسپتال میں خاموشی سے ناکام ہو جاتا ہے۔ پچھلے مطالعوں نے COVID-19 اور نمونیا کی درجہ بندی کرنے والے ماڈلز میں یہ بات درج کی تھی۔ وہ یہ نہیں بتا سکے تھے کہ ماڈل کا کون سا حصہ یہ پڑھائی کرتا ہے، اور کیا اس حصے کو ہٹانے سے فائدہ ہو گا۔
وضاحت کے عام اوزار — Grad-CAM جیسے حرارتی نقشے، attention rollout، LIME — یہ دکھاتے ہیں کہ ماڈل نے کہاں دیکھا۔ وہ ذمہ دار جزو کی شناخت نہیں کرتے، اور سبب ثابت نہیں کر سکتے۔ ماکیریرے یونیورسٹی کے جوشوا موہوموزا اور کارنیلیس کالینزی نے اس کے بجائے میکانکی تفہیم پذیری (mechanistic interpretability) کا اوزاروں کا مجموعہ لیا، جو زبان کے ماڈلز کی چیر پھاڑ کے لیے بنایا گیا تھا، اور اسے ایک Vision Transformer پر لاگو کیا۔
تدریسی ہسپتال سے ضلعی کلینک تک
مصنفین داؤ پر لگی چیز کو ٹھوس انداز میں بیان کرتے ہیں۔ ٹرانسفارمر پر مبنی ایکس رے درجہ بندی کے ماڈل کم وسائل والے علاقوں میں تپِ دق اور نمونیا کی اسکریننگ کے لیے بڑھتی ہوئی تعداد میں استعمال ہو رہے ہیں، جنہیں اکثر کسی بڑے ریفرل ہسپتال میں تربیت دی جاتی ہے اور پھر دوبارہ جانچے بغیر ضلعی ہسپتالوں یا موبائل یونٹس میں منتقل کر دیا جاتا ہے، جہاں مشینیں مختلف، سافٹ ویئر مختلف اور لیبل لگانے کی عادتیں مختلف ہوتی ہیں۔ جس ماڈل نے اپنے آبائی ہسپتال کی مہر سیکھ لی ہو، اس کی کارکردگی اسی لمحے بگڑ جائے گی جب اس کا سامنا کسی ایسے کلینک سے ہو جو کوئی مہر نہیں لگاتا، یا کچھ اور، کہیں اور لگاتا ہے۔
144 میں سے ایک سر
زیرِ مطالعہ ماڈل، ViT-Base/16 (عوامی checkpoint یعنی google/vit-base-patch16-224، جسے ImageNet-21k پر پہلے سے تربیت دی گئی)، ہر تصویر کو 196 ٹکڑوں (patches) میں کاٹتا ہے اور انہیں 12 تہوں سے گزارتا ہے، جن میں سے ہر ایک میں 12 توجہ کے سر ہیں۔ ٹیم نے تمام 144 سروں کو اس بنیاد پر جانچا کہ ان کی توجہ کتنی مرکوز اور کتنی دور رس ہے۔
ارتکاز اچانک تہہ 7 سے 9 میں ظاہر ہوتا ہے۔ ایک سر سب سے الگ ہے: L8H10، یعنی تہہ 8 کا سر 10۔ یہ اپنی 34.6% توجہ ایک ہی ٹکڑے پر لگاتا ہے — کسی بھی دوسرے سر سے 2.8 گنا زیادہ۔ اوپری بائیں کونے میں “D CLINO” کے نشان والے ایک ایکس رے پر یہ اپنی 0.346 توجہ اسی ٹکڑے کو دیتا ہے، جو 0.0051 کی یکساں سطح کا 68 گنا ہے، جبکہ پھیپھڑوں کو تقریباً کچھ نہیں ملتا۔
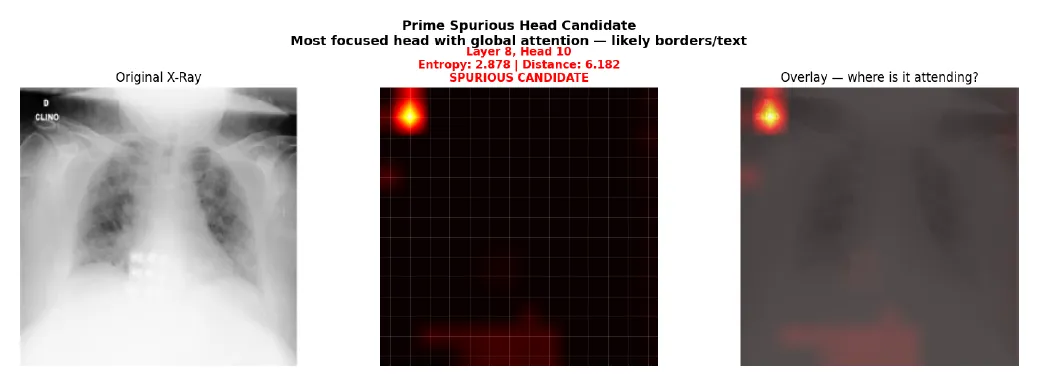
پہلے جانچے گئے ایکس رے پر سر L8H10: کونے کی تحریر پر ایک روشن نقطہ، پھیپھڑوں پر تقریباً سیاہی۔ — شکل 4، Muhumuza and Kalenzi (2026)، arXiv:2610.21638۔
COVID-19 کے 200 ایکس رے میں سے 123 (62%) میں یہ سر یہی رویہ دکھاتا ہے۔ ان تصویروں میں کونے پر توجہ اوسطاً پھیپھڑوں پر توجہ کا 57.5 گنا ہے؛ باقی میں 0.77 گنا۔ دونوں گروہ ایک دوسرے پر منطبق نہیں ہوتے۔ اس رویے کی پیش گوئی چمک سے نہیں بلکہ کونے کے مقامی تضاد (local contrast) سے ہوتی ہے — بالکل وہی جو ہلکے پس منظر پر گہرے حروف پیدا کرتے ہیں۔
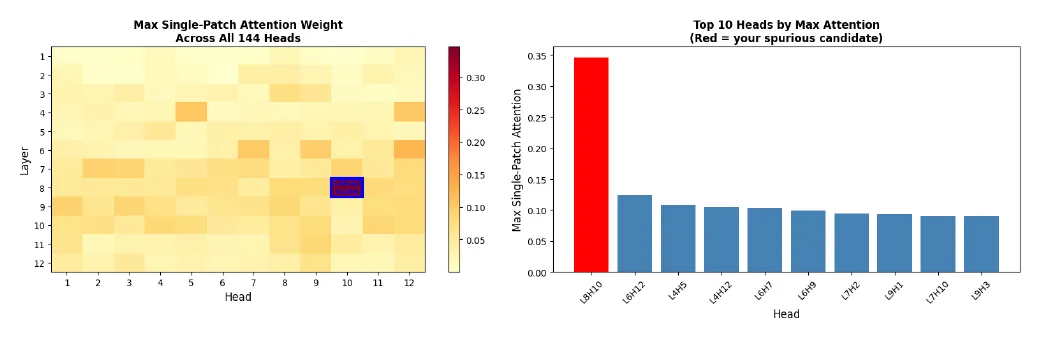
ہر سر کے لیے ایک ٹکڑے پر زیادہ سے زیادہ توجہ: L8H10 (سرخ) 0.346 پر ہے، اگلا 0.124 پر۔ — شکل 3، Muhumuza and Kalenzi (2026)، arXiv:2610.21638۔
مٹا کر ثبوت
کونے کو سادہ سرمئی رنگ سے ڈھانپنا صاف امتحان نہیں: یکساں سرمئی مربع خود بھی زیادہ تضاد رکھتا ہے اور سر کو اپنی طرف کھینچتا ہے۔ اس لیے مصنفین نے کونے کی ان پینٹنگ (inpainting) کی، یعنی اسے حقیقت سے قریب بافت کی ساخت سے بھر دیا۔ تب 200 میں سے 158 تصویروں (79%) میں کونے پر توجہ گر گئی۔ متاثرہ تصویروں میں پھیپھڑوں پر توجہ 1.52 گنا بڑھ گئی؛ باقی میں کوئی فرق نہیں پڑا (0.99 گنا)۔ سر کو چلانے والی چیز خود عبارت ہے، چمک یا کنارے نہیں۔
یہ نمونہ دوسری جگہوں پر بھی دہرایا جاتا ہے: NIH ChestX-ray14 ڈیٹا سیٹ کے 200 ایکس رے میں سے 79% میں، اور دو دوسری ساختوں میں — DeiT-Base (سر L9H2، 88%) اور ViT-Large/16 (سر L8H8، 80%)۔
وہ سرکٹ جسے کسی کی جانچیں نہیں دیکھ سکتیں
مرکزی نتیجہ منفی ہے۔ اسی ساخت پر بنے پانچ زمروں والے ایک ایکس رے درجہ بندی ماڈل میں L8H10 کو بند کرنے سے 5% پیش گوئیاں بدل گئیں — مگر عام تصویروں پر بھی اتنی ہی بار جتنی متاثرہ تصویروں پر (p = 0.340)۔ آزادانہ طور پر تربیت یافتہ ایک دوسرے نمونیا ماڈل نے بھی یہی صفر نتیجہ دیا۔ تینوں مشتبہ سروں (L8H10، L7H2، L9H3) کو ایک ساتھ بند کرنے سے تبدیلیاں دگنی ہو کر 10% ہو گئیں، پھر بھی کوئی مخصوص اثر نہیں تھا (p = 0.532)۔
مصنفین اسے فاضل پن (redundancy) سمجھتے ہیں: معلومات بہت سے اجزا میں پھیلی ہوئی ہے، اس لیے سب سے نمایاں حاملوں کو ہٹانے پر باقی اجزا کام سنبھال لیتے ہیں۔ دوبارہ تربیت بھی مدد نہیں کرتی۔ ایکس رے پر مکمل باریک تربیت (fine-tuning) کے بعد بھی 123 متاثرہ تصویروں میں سے 121 (98.4%) اس سر کو متحرک کرتی رہیں، کیونکہ مہر ایسے ڈیٹا میں پیش گوئی کی صلاحیت رکھتی ہے جہاں لیبل لگانے کی عادتیں یہ ظاہر کرتی ہیں کہ تصویر کس ہسپتال سے — اور کن بیماریوں سے — آئی ہے۔
استعمال سے پہلے اندر جھانکیں
مصنفین لکھتے ہیں کہ خطرہ ایک غلط تشخیص نہیں بلکہ ایک چھپی ہوئی کمزوری ہے جو ماڈل کے ہسپتال بدلنے پر جاگ اٹھتی ہے۔ ان کی سفارش: توجہ کے سروں کا جائزہ لیں، حاملوں کی شناخت کریں، ان کی سببی تصدیق کریں، اور یہ سب استعمال سے پہلے کریں — خاص طور پر مختلف اداروں کے درمیان۔ انہیں جو واحد قابلِ اعتماد حل معلوم ہیں وہ ڈیٹا کی سطح پر ہیں: ایسی تصویروں پر تربیت جن سے تحریریں ہٹا دی گئی ہوں، یا تربیت کے دوران شناخت شدہ سروں پر جرمانہ عائد کرنا۔
حدود بھی بیان کی گئی ہیں۔ کونے کا خطہ اور حد انہی ڈیٹا سیٹس کے لیے طے کی گئی تھی؛ باریک تربیت کی جانچوں میں صرف 200 تصویریں استعمال ہوئیں؛ اور فیصلہ کن تجربہ — ایک ہی سائز کی تحریر والی اور تحریر سے پاک تصویروں پر تربیت کا موازنہ — ابھی باقی ہے۔