DIE KI, DIE DEN KRANKENHAUSSTEMPEL LIEST STATT DER LUNGE
Ein Klassifikator für Thorax-Röntgenbilder kann lernen, den Code zu lesen, den ein Krankenhaus in die Ecke jedes Bildes stempelt, statt der Krankheit in der Lunge. Er funktioniert dann gut mit Daten aus diesem Krankenhaus und versagt still und leise im nächsten. Frühere Studien haben das für COVID-19- und Lungenentzündungs-Klassifikatoren dokumentiert. Was sie nicht sagen konnten: welcher Teil des Modells das Lesen übernimmt und ob es helfen würde, diesen Teil zu entfernen.
Die üblichen Erklärwerkzeuge – Heatmaps wie Grad-CAM, Attention Rollout, LIME – zeigen, wohin ein Modell geschaut hat. Sie identifizieren nicht die verantwortliche Komponente und können keine Ursache belegen. Joshua Muhumuza und Cornelius Kalenzi von der Makerere-Universität griffen stattdessen auf den Werkzeugkasten der mechanistischen Interpretierbarkeit zurück, der entwickelt wurde, um Sprachmodelle zu sezieren, und wandten ihn auf einen Vision Transformer an.
Vom Lehrkrankenhaus in die Bezirksklinik
Die Autoren beschreiben konkret, was auf dem Spiel steht. Transformer-basierte Röntgen-Klassifikatoren werden zunehmend für das Screening auf Tuberkulose und Lungenentzündung in ressourcenarmen Regionen eingesetzt – oft an einem großen Referenzkrankenhaus trainiert und dann ohne erneute Prüfung in Bezirkskrankenhäuser oder mobile Einheiten mit anderen Geräten, anderer Software und anderen Beschriftungsgewohnheiten verlegt. Ein Modell, das den Stempel seines Heimatkrankenhauses gelernt hat, würde in dem Moment schlechter werden, in dem es auf eine Klinik trifft, die nichts stempelt – oder etwas anderes, an anderer Stelle.
Ein Head von 144
Das untersuchte Modell, ViT-Base/16 (der öffentliche Checkpoint google/vit-base-patch16-224, vortrainiert auf ImageNet-21k), zerlegt jedes Bild in 196 Bildausschnitte (Patches) und verarbeitet sie in 12 Schichten mit je 12 Attention-Heads. Das Team bewertete alle 144 Heads danach, wie fokussiert und wie weitreichend ihre Aufmerksamkeit war.
Der Fokus taucht in den Schichten 7 bis 9 plötzlich auf. Ein Head sticht hervor: L8H10, Head 10 in Schicht 8. Er legt 34,6 % seiner Aufmerksamkeit auf einen einzigen Patch – 2,8-mal mehr als jeder andere Head. Auf einem Röntgenbild mit der Markierung „D CLINO“ in der oberen linken Ecke richtet er 0,346 seiner Aufmerksamkeit auf diesen Patch, das 68-Fache des gleichmäßigen Niveaus von 0,0051, während die Lunge fast nichts abbekommt.
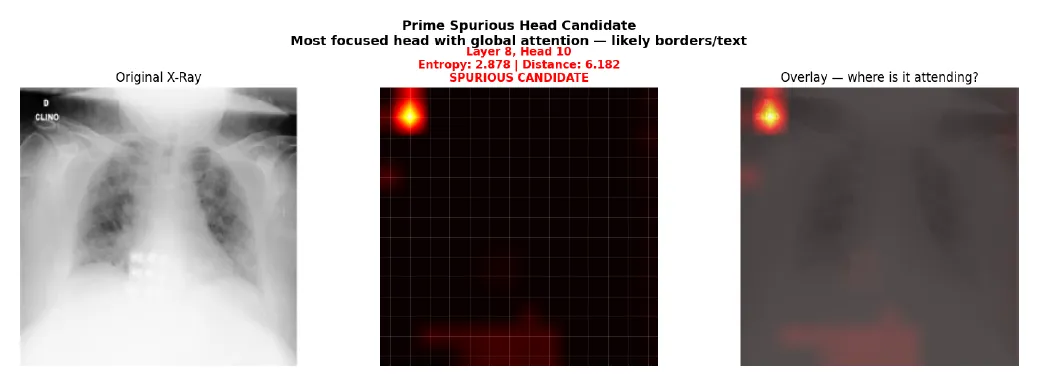
Head L8H10 beim ersten untersuchten Röntgenbild: ein heller Fleck auf der Beschriftung in der Ecke, fast schwarz auf der Lunge. — Abbildung 4, Muhumuza und Kalenzi (2026), arXiv:2610.21638.
Bei 200 COVID-19-Röntgenbildern verhält sich der Head in 123 (62 %) so. In diesen Bildern ist die Aufmerksamkeit auf die Ecke im Mittel 57,5-mal so groß wie die auf die Lunge; in den anderen 0,77-mal. Die beiden Gruppen überlappen sich nicht. Was dieses Verhalten vorhersagt, ist nicht die Helligkeit, sondern der lokale Kontrast in der Ecke – genau das, was dunkle Buchstaben auf hellem Grund erzeugen.
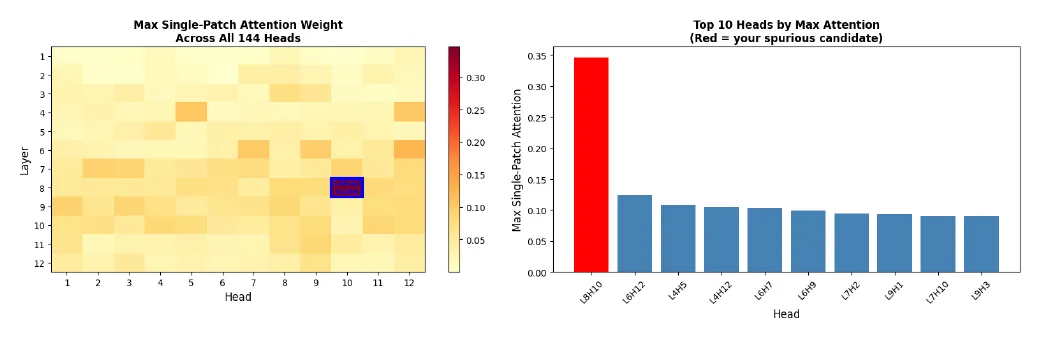
Maximale Aufmerksamkeit auf einen einzelnen Patch für jeden Head: L8H10 (rot) liegt bei 0,346, der nächste bei 0,124. — Abbildung 3, Muhumuza und Kalenzi (2026), arXiv:2610.21638.
Beweis durch Löschen
Die Ecke mit flachem Grau abzudecken, ist kein sauberer Test: Ein gleichmäßig graues Quadrat ist selbst kontrastreich und zieht den Head an. Deshalb haben die Autoren die Ecke stattdessen per Inpainting gefüllt, mit realistischer Gewebetextur. Die Aufmerksamkeit auf die Ecke sank daraufhin in 158 von 200 Bildern (79 %). In den betroffenen Bildern stieg die Aufmerksamkeit auf die Lunge um das 1,52-Fache; in den anderen blieb sie unverändert (0,99-fach). Es ist der Text selbst, nicht Helligkeit oder Kanten, der den Head antreibt.
Das Muster wiederholt sich anderswo: bei 79 % von 200 Röntgenbildern aus dem Datensatz NIH ChestX-ray14 und in zwei weiteren Architekturen – DeiT-Base (Head L9H2, 88 %) und ViT-Large/16 (Head L8H8, 80 %).
Der Schaltkreis, den keine Tests sehen
Das zentrale Ergebnis ist negativ. In einem Röntgen-Klassifikator mit fünf Klassen auf derselben Architektur änderte das Abschalten von L8H10 5 % der Vorhersagen – aber bei normalen Bildern genauso oft wie bei betroffenen (p = 0,340). Ein zweiter, unabhängig trainierter Lungenentzündungs-Klassifikator lieferte dasselbe Nullergebnis. Alle drei verdächtigen Heads gleichzeitig abzuschalten (L8H10, L7H2, L9H3), verdoppelte die Änderungen auf 10 %, weiterhin ohne spezifischen Effekt (p = 0,532).
Die Autoren deuten das als Redundanz: Die Information ist über viele Komponenten verteilt, sodass nach dem Entfernen der sichtbarsten Träger der Rest die Arbeit übernimmt. Auch Nachtrainieren hilft nicht. Nach vollständigem Feintuning auf Röntgenbildern lösten 121 der 123 betroffenen Bilder (98,4 %) den Head weiterhin aus, weil der Stempel in Daten aussagekräftig bleibt, in denen die Beschriftungsgewohnheiten verraten, aus welchem Krankenhaus – und mit welchen Krankheiten – ein Bild stammt.
Erst hineinschauen, dann ausliefern
Die Gefahr, schreiben die Autoren, ist nicht eine einzelne Fehldiagnose, sondern eine verborgene Schwachstelle, die anspringt, wenn ein Modell das Krankenhaus wechselt. Ihre Empfehlung: Attention-Heads prüfen, die Träger identifizieren, sie kausal verifizieren – und das vor dem Einsatz tun, besonders beim Wechsel zwischen Einrichtungen. Die einzigen zuverlässigen Abhilfen, die sie kennen, liegen auf der Datenebene: mit Bildern trainieren, aus denen die Beschriftungen entfernt wurden, oder die identifizierten Heads beim Training bestrafen.
Auch die Grenzen werden benannt. Eckbereich und Schwellenwert wurden für diese Datensätze festgelegt; die Feintuning-Tests nutzten nur 200 Bilder; und das entscheidende Experiment – Training mit beschrifteten gegenüber bereinigten Bildern gleicher Anzahl – steht noch aus.