L'IA QUI LIT LE TAMPON DE L'HÔPITAL AU LIEU DES POUMONS
Un classifieur de radios du thorax peut apprendre à lire le code qu’un hôpital tamponne dans le coin de chaque image plutôt que la maladie dans les poumons. Il fonctionne alors bien sur les données de cet hôpital et échoue en silence dans le suivant. Des études antérieures l’ont documenté pour des classifieurs de COVID-19 et de pneumonie. Ce qu’elles ne pouvaient pas dire, c’est quelle partie du modèle fait cette lecture, et si la retirer aiderait.
Les outils d’explication habituels — cartes de chaleur comme Grad-CAM, attention rollout, LIME — montrent où un modèle a regardé. Ils n’identifient pas le composant responsable et ne peuvent pas établir de cause. Joshua Muhumuza et Cornelius Kalenzi, de l’université Makerere, ont emprunté à la place la boîte à outils de l’interprétabilité mécaniste, développée pour disséquer les modèles de langage, et l’ont appliquée à un Vision Transformer.
Du grand hôpital au dispensaire
Les auteurs posent l’enjeu concrètement. Des classifieurs de radios fondés sur les Transformers servent de plus en plus au dépistage de la tuberculose et de la pneumonie dans des contextes à faibles ressources, souvent entraînés dans un grand hôpital de référence puis transférés, sans nouvel audit, vers des hôpitaux de district ou des unités mobiles, avec d’autres appareils, d’autres logiciels et d’autres habitudes d’annotation. Un modèle qui aurait appris le tampon de son hôpital d’origine se dégraderait dès qu’il rencontre une clinique qui ne tamponne rien, ou autre chose, ailleurs.
Une tête sur 144
Le modèle étudié, ViT-Base/16 (le modèle public google/vit-base-patch16-224, pré-entraîné sur ImageNet-21k), découpe chaque image en 196 carreaux et les traite dans 12 couches de 12 têtes d’attention chacune. L’équipe a noté les 144 têtes selon la concentration et la portée de leur attention.
La concentration apparaît brusquement dans les couches 7 à 9. Une tête se détache : L8H10, la tête 10 de la couche 8. Elle met 34,6 % de son attention sur un seul carreau — 2,8 fois plus que n’importe quelle autre tête. Sur une radio marquée « D CLINO » en haut à gauche, elle place 0,346 de son attention sur ce carreau, 68 fois le niveau uniforme de 0,0051, tandis que les poumons ne reçoivent presque rien.
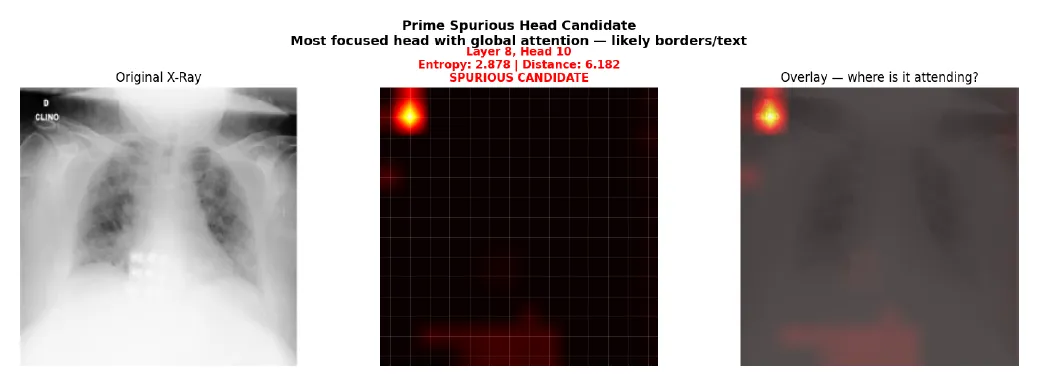
La tête L8H10 sur la première radio examinée : une tache brillante sur l’annotation du coin, presque du noir sur les poumons. — Figure 4, Muhumuza et Kalenzi (2026), arXiv:2610.21638.
Sur 200 radios de COVID-19, la tête se comporte ainsi dans 123 cas (62 %). Dans ces images, l’attention portée au coin vaut en moyenne 57,5 fois celle portée aux poumons ; dans les autres, 0,77 fois. Les deux groupes ne se chevauchent pas. Ce qui prédit ce comportement, ce n’est pas la luminosité mais le contraste local du coin — exactement ce que produisent des lettres sombres sur fond clair.
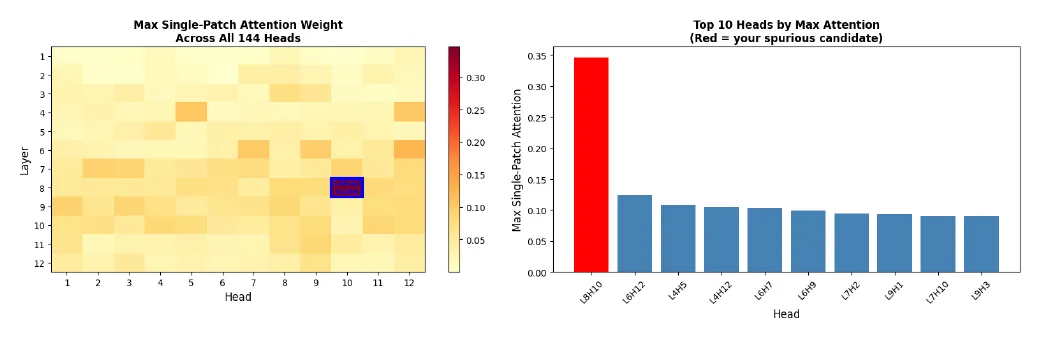
Attention maximale sur un seul carreau pour chaque tête : L8H10 (rouge) culmine à 0,346, la suivante à 0,124. — Figure 3, Muhumuza et Kalenzi (2026), arXiv:2610.21638.
La preuve par l’effacement
Masquer le coin avec un gris uniforme n’est pas un test propre : un carré gris uni est lui-même très contrasté et attire la tête. Les auteurs ont donc comblé le coin par inpainting, en le remplissant d’une texture de tissu réaliste. L’attention portée au coin a alors baissé dans 158 images sur 200 (79 %). Dans les images concernées, l’attention aux poumons a été multipliée par 1,52 ; dans les autres, elle n’a pas bougé (×0,99). C’est bien le texte, et non la luminosité ou les contours, qui pilote la tête.
Le phénomène se répète ailleurs : dans 79 % de 200 radios du jeu de données NIH ChestX-ray14, et dans deux autres architectures — DeiT-Base (tête L9H2, 88 %) et ViT-Large/16 (tête L8H8, 80 %).
Le circuit que les tests ne voient pas
Le résultat central est négatif. Dans un classifieur de radios à cinq classes bâti sur la même architecture, éteindre L8H10 a modifié 5 % des prédictions — mais aussi souvent sur les images normales que sur les images concernées (p = 0,340). Un second classifieur de pneumonie, entraîné indépendamment, donne le même résultat nul. Éteindre les trois têtes suspectes à la fois (L8H10, L7H2, L9H3) double les changements, à 10 %, toujours sans effet spécifique (p = 0,532).
Les auteurs y lisent de la redondance : l’information est répartie sur de nombreux composants, si bien qu’en retirant les porteurs les plus visibles, les autres font le travail. Le réentraînement n’aide pas davantage. Après un réglage fin complet sur des radios, 121 des 123 images concernées (98,4 %) déclenchent toujours la tête, parce que le tampon reste prédictif dans des données où les habitudes d’annotation suivent l’hôpital d’origine — et donc la fréquence des maladies.
Regarder dedans avant de déployer
Le danger, écrivent les auteurs, n’est pas une erreur de diagnostic isolée mais une vulnérabilité cachée, qui s’active quand un modèle change d’hôpital. Leur recommandation : auditer les têtes d’attention, identifier les porteurs, les vérifier causalement, et le faire avant tout déploiement — surtout d’un établissement à l’autre. Les seules parades fiables qu’ils connaissent se situent au niveau des données : entraîner sur des images débarrassées de leurs annotations, ou pénaliser les têtes identifiées pendant l’entraînement.
Les limites sont dites aussi. La région du coin et le seuil ont été fixés pour ces jeux de données ; les tests de réentraînement n’ont porté que sur 200 images ; et l’expérience décisive — entraîner sur des images annotées contre des images nettoyées, à taille égale — reste à faire.