فيديوهات الذكاء الاصطناعي قد تُصدر انبعاثات أكبر 75 مرة بحلول 2030
اكتب جملة، تحصل على مقطع فيديو: فتوليد الفيديو من النص يعمل اليوم على نطاق تجاري. ومن المعروف أصلًا أن كلفته لكل مقطع مرتفعة. فبحسب دراسة سابقة لديلافاند (Delavande) وزملاء، يستهلك توليد فيديو قصير من نص نحو 90 واط ساعة، أي قرابة 30 ضعف ما تستهلكه صورة و45,000 ضعف ما تستهلكه مهمة بسيطة لتصنيف النصوص. ولا تُصنع المقاطع على جهاز المستخدم نفسه: فكل طلب يُنفَّذ على رفوف من رقائق الذكاء الاصطناعي في مراكز البيانات.
لكن الكلفة لكل مقطع لا تقول الكثير عن المجموع. فهي لا تخبرنا كم مقطعًا يُنتج، ولا ما يتطلبه ذلك من عتاد، ولا كم من الماء يستهلك التبريد. ويمكن أن تتحسن الكفاءة لكل مقطع بينما تنمو البصمة الإجمالية.
وقد أخذ فريق يضم تريستان كوانيون (Tristan Coignion)، من جامعة ليل، مع A. Bugeau وG. Guennebaud في بوردو وA.-L. Ligozat في باريس-ساكليه، على عاتقه تقدير البصمة الكاملة لتوليد الفيديو بالذكاء الاصطناعي على مستوى العالم — لعام 2026 وحتى 2030.
إحصاء المقاطع
نادرًا ما يُفصح المزوّدون عن عدد الفيديوهات التي يولّدونها، فقاس الفريق ما استطاع قياسه. فقد مسح آليًا الموجز العام لـSora، خدمة الفيديو التابعة لـOpenAI، على مدى 54 يومًا بين فبراير وأبريل 2026: 3.3 مليون فيديو عام، أي نحو 22 مليونًا في السنة. وقد أغلقت OpenAI تجربتَي Sora على الويب وفي التطبيق بعد ذلك بوقت قصير. كما تابع الفريق العدّاد المباشر لدى HeyGen على مدى 90 يومًا: نحو 111 مليون فيديو في السنة، بما فيها الفيديوهات الخاصة.
وينشر ستة مزوّدين آخرين أعدادهم الخاصة. وأكبرهم بفارق كبير Grok Imagine، بنحو 3.8 مليار في السنة. ومجموع هذه الأرقام يعطي حصيلة قابلة للرصد تبلغ نحو 6.2 مليار فيديو في السنة. ويسحب النموذج حجم 2026 عشوائيًا بين 6.2 و9.5 مليار، بوسيط قدره 7.16 مليار.
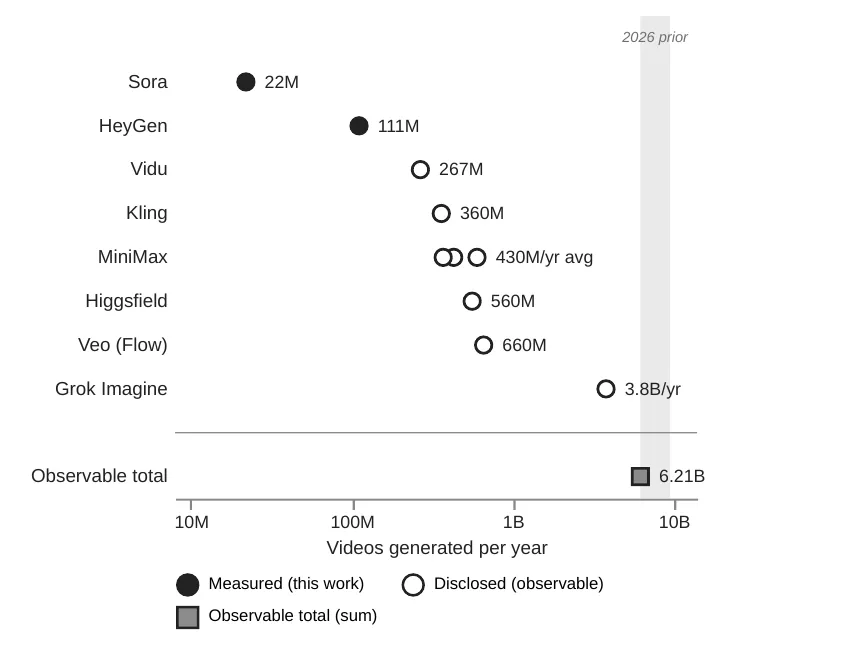
الفيديوهات المولّدة بالذكاء الاصطناعي سنويًا لكل خدمة: النقاط الممتلئة قاسها الفريق، والنقاط الفارغة أفصح عنها المزوّدون؛ والشريط المظلّل هو نطاق النموذج لعام 2026. — الشكل 1، Coignion وآخرون (2026)، arXiv:2611.17938.
فاتورة 2026
وانطلاقًا من ذلك، يحدد نموذج تصاعدي (bottom-up) حجم أسطول رقائق الذكاء الاصطناعي اللازم، ثم يستنتج منه الكهرباء والماء وغازات الدفيئة واستنزاف الموارد المعدنية، مُجريًا 10,000 محاكاة للإحاطة بعدم اليقين. ويشمل ذلك التدريب والتخزين؛ أما الصوت، وبثّ الفيديوهات إلى المشاهدين، فلا.
وبالنسبة إلى 2026، تكون النتيجة الوسيطة أسطولًا من 72,600 معالج رسوميات، و724 غيغاواط ساعة من الكهرباء، و124,300 طن من مكافئ CO₂. ولنأخذ غازات الدفيئة التي تستطيع البشرية إطلاقها كل عام دون تجاوز الحد المناخي للكوكب، ولنقسمها بالتساوي على كل فرد: فـ124,300 طن هي الحصة السنوية لنحو 126,000 شخص.
ولكل فيديو، تبلغ الكلفة الشاملة نحو 100 واط ساعة — أي 4.1 مرة قدر الـ24.4 واط ساعة التي تنفقها الرقاقة وحدها على عملية توليد واحدة. ويصنع الفارقَ وقتُ الخمول، والأعباء الإضافية للمباني، والتدريب، والتخزين. ويستأثر توليد الفيديوهات بنحو 69% من الانبعاثات، وتدريب النماذج بنسبة 31%، والتخزين بما يكاد لا يُذكر. ومصدر الكهرباء أهم من كمية استهلاكها: ففي الانبعاثات، تزن الكثافة الكربونية للشبكة الكهربائية 12 مرة أكثر من عدد الفيديوهات.
ثلاثة مستقبلات
ثم يمضي النموذج حتى 2030 وفق ثلاثة سيناريوهات، تشترك كلها في التقدم التقني المطّرد نفسه: رقائق أحدث وأكفأ، وبرمجيات تزداد كفاءتها بنحو 10% كل عام.
- المرجعي: يتضاعف عدد الفيديوهات في 2027 و2028 و2029، ثم ينمو بنسبة 60% في 2030 — أي 12.8 مرة إجمالًا، وهو مسار متواضع عن قصد. وتنمو الانبعاثات 74 مرة، لتبلغ نحو 9.2 مليون طن في 2030: أي ميزانية نحو 9.3 مليون شخص. ولماذا أسرع من الطلب؟ لأن الفيديوهات تصبح أطول وأعلى دقة، فترتفع الطاقة لكل فيديو من 24.4 إلى 214 واط ساعة.
- ركود الاستخدام: يبقى الحجم والدقة والمدة عند مستويات 2026. والانبعاثات تنخفض بنحو خُمسَيها. وهو السيناريو الوحيد الذي تتراجع فيه.
- التبنّي الواسع: ينمو الحجم 60 ضعفًا. وتبلغ الانبعاثات 42.9 مليون طن — أي ميزانية نحو 44 مليون شخص.
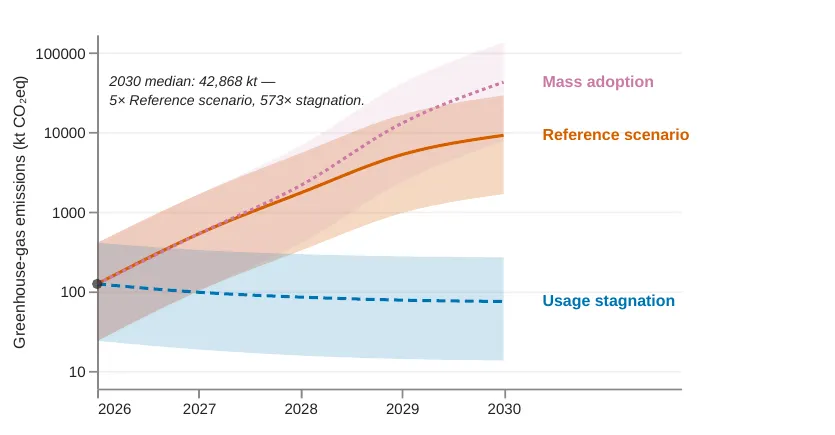
الانبعاثات وفق السيناريوهات الثلاثة، 2026–2030؛ الخطوط قيم وسيطة، والأشرطة نطاق 5–95%. — الشكل 6، Coignion وآخرون (2026)، arXiv:2611.17938.
الكفاءة لن تلحق بالركب
وشغّل الفريق النموذج أيضًا في الاتجاه المعاكس. ففي المسار المرجعي، حتى مكسب في الكفاءة بنسبة 30% كل عام يُبقي انبعاثات 2030 أعلى 27.5 مرة مما كانت عليه في 2026. وللإبقاء على الانبعاثات ثابتة، يلزم نحو 75% في السنة — أي قرابة سبعة أضعاف الـ10% التي يفترضها النموذج، وأكثر من أفضل كفاءة قيست على أي نموذج قيد الاستخدام الفعلي. أما هدف القطاع الرقمي نفسه، المتوافق مع اتفاق باريس، فيدعو إلى خفض بنسبة 45% في الانبعاثات بين 2020 و2030.
حدّ أدنى، لا سقف
يقدّم المؤلفون كل هذه الأرقام بوصفها حدودًا دنيا. فنموذج التوليد يبقى ثابتًا دون تغيير حتى 2030، في حين يُرجَّح أن تصبح النماذج الحقيقية أكثر تطلبًا؛ والبثّ والصوت واستخدامات الذكاء الاصطناعي الأخرى مستبعدة؛ والتدريب، وهو الجزء الأقل توثيقًا، مُعايَر على عدد قليل من النماذج المفتوحة الصغيرة. ويمكن للاستخدام أيضًا أن يتقلص بسرعة، كما أظهر إغلاق Sora. لكن وفق أرقام البحث، لا تتوقف البصمة عن النمو إلا إذا توقف عدد الفيديوهات، أو جودتها، عن النمو أيضًا.