انتشار ویدئوهای هوش مصنوعی ممکن است تا 2030 به 75 برابر برسد
جملهای تایپ کنید، یک کلیپ ویدئویی بگیرید: تولید ویدئو از متن اکنون در مقیاس تجاری انجام میشود. از پیش میدانیم که هزینهٔ آن به ازای هر کلیپ بالاست. بر پایهٔ مطالعهای پیشین از دلاوند (Delavande) و همکاران، تولید یک ویدئوی کوتاه از متن تقریباً 90 واتساعت مصرف میکند، نزدیک به 30 برابر یک تصویر و 45,000 برابر یک کار سادهٔ دستهبندی متن. و کلیپها روی دستگاه خود کاربر ساخته نمیشوند: هر درخواست روی قفسههایی از تراشههای هوش مصنوعی در مراکز داده اجرا میشود.
اما هزینه به ازای هر کلیپ چیز زیادی دربارهٔ کل نمیگوید. نمیگوید چند کلیپ ساخته میشود، چه سختافزاری لازم است، یا خنکسازی چه مقدار آب مصرف میکند. و کارایی به ازای هر کلیپ میتواند بهتر شود در حالی که ردپای کل بزرگتر میشود.
تریستان کوانیون (Tristan Coignion) در دانشگاه لیل (University of Lille)، همراه با A. Bugeau و G. Guennebaud در بوردو و A.-L. Ligozat در پاری-ساکله (Paris-Saclay)، برآن شدند تا کل ردپای تولید ویدئو با هوش مصنوعی را در سراسر جهان برآورد کنند — برای 2026 و تا 2030.
شمردن کلیپها
ارائهدهندگان بهندرت میگویند چند ویدئو تولید میکنند، پس تیم آنچه را میتوانست اندازه گرفت. این تیم فید عمومی Sora، سرویس ویدئوی OpenAI، را به مدت 54 روز میان فوریه و آوریل 2026 پیمایش کرد: 3.3 میلیون ویدئوی عمومی، یعنی حدود 22 میلیون در سال. OpenAI اندکی بعد نسخههای وب و اپلیکیشن Sora را تعطیل کرد. تیم همچنین شمارندهٔ زندهٔ HeyGen را به مدت 90 روز دنبال کرد: حدود 111 میلیون ویدئو در سال، با احتساب ویدئوهای خصوصی.
شش ارائهدهندهٔ دیگر شمارشهای خود را منتشر میکنند. بزرگترینشان با فاصلهٔ زیاد Grok Imagine است، با حدود 3.8 میلیارد در سال. روی هم، اینها مجموع مشاهدهپذیری حدود 6.2 میلیارد ویدئو در سال به دست میدهند. مدل حجم سال 2026 را از بازهٔ میان 6.2 و 9.5 میلیارد نمونهگیری میکند، با میانهٔ 7.16 میلیارد.
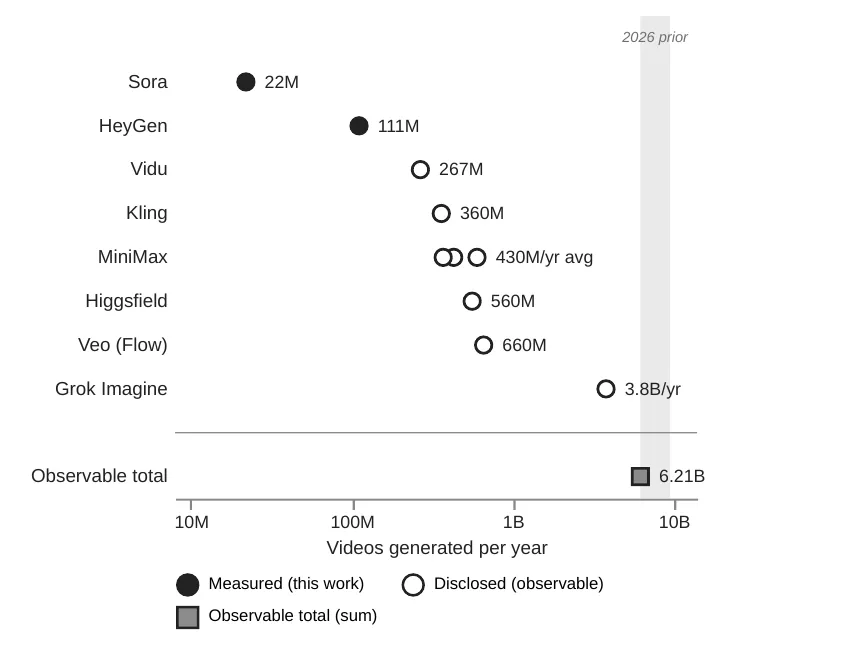
ویدئوهای هوش مصنوعی سالانه به تفکیک سرویس: نقطههای توپر را تیم اندازه گرفته است، نقطههای توخالی را ارائهدهندگان اعلام کردهاند؛ نوار سایهدار بازهٔ مدل برای 2026 است. — شکل 1، Coignion et al. (2026)، arXiv:2611.17938.
صورتحساب 2026
از آنجا، یک مدل پایینبهبالا اندازهٔ ناوگان تراشههای هوش مصنوعی لازم را برآورد میکند، سپس برق، آب، گازهای گلخانهای و تهیشدن منابع معدنی را به دست میآورد و 10,000 شبیهسازی اجرا میکند تا عدم قطعیت را در بر گیرد. آموزش و ذخیرهسازی به حساب آمدهاند؛ صدا، و پخش جریانی ویدئوها برای بینندگان، به حساب نیامدهاند.
برای 2026، نتیجهٔ میانه ناوگانی از 72,600 پردازندهٔ گرافیکی، 724 گیگاواتساعت برق و 124,300 تن معادل CO₂ است. مقدار گازهای گلخانهای را که بشر میتواند هر سال بیآنکه از حد اقلیمی سیاره بگذرد منتشر کند در نظر بگیرید و آن را بهطور برابر میان افراد تقسیم کنید: 124,300 تن سهم سالانهٔ حدود 126,000 نفر است.
به ازای هر ویدئو، هزینهٔ کامل به حدود 100 واتساعت میرسد — 4.1 برابر 24.4 واتساعتی که خود تراشه برای یک بار تولید صرف میکند. زمان بیکاری، سربارهای ساختمان، آموزش و ذخیرهسازی این تفاوت را میسازند. تولید ویدئوها حدود 69% انتشار را تشکیل میدهد، آموزش مدلها 31%، و ذخیرهسازی تقریباً هیچ. و اینکه برق از کجا میآید از اینکه چقدر مصرف میشود مهمتر است: برای انتشار، شدت کربنی شبکهٔ برق 12 برابر بیشتر از شمار ویدئوها وزن دارد.
سه آینده
سپس مدل تا 2030 تحت سه سناریو اجرا میشود، همه با پیشرفت فنی پیوستهٔ یکسان: تراشههای تازهتر و کاراتر و نرمافزاری که هر سال حدود 10% کاراتر میشود.
- مرجع: شمار ویدئوها در 2027، 2028 و 2029 دو برابر میشود، سپس در 2030 به اندازهٔ 60% رشد میکند — در مجموع 12.8 برابر، مسیری عمداً معتدل. انتشار 74 برابر میشود و در 2030 به حدود 9.2 میلیون تن میرسد: بودجهٔ حدود 9.3 میلیون نفر. چرا سریعتر از تقاضا؟ ویدئوها بلندتر و واضحتر میشوند، پس انرژی هر ویدئو از 24.4 به 214 واتساعت میرسد.
- ایستایی استفاده: حجم، وضوح و مدت در سطح 2026 میمانند. انتشار حدود دو پنجم کاهش مییابد. این تنها سناریویی است که در آن انتشار پایین میآید.
- پذیرش گسترده: حجم 60 برابر میشود. انتشار به 42.9 میلیون تن میرسد — بودجهٔ حدود 44 میلیون نفر.
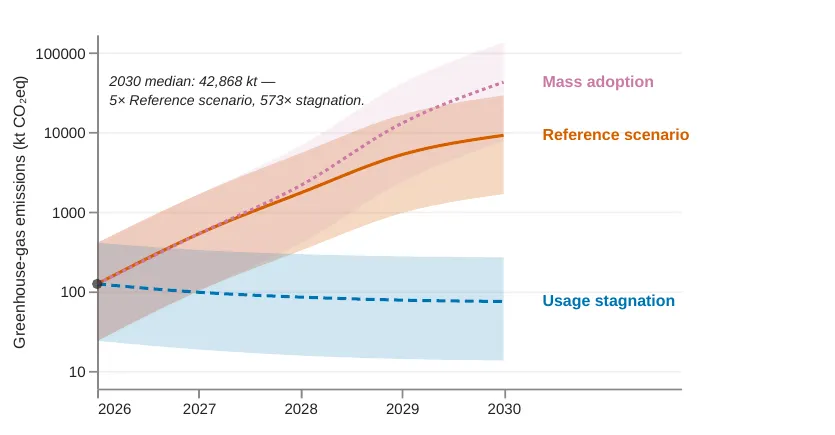
انتشار تحت سه سناریو، 2026–2030؛ خطوط میانهها هستند و نوارها بازهٔ 5–95%. — شکل 6، Coignion et al. (2026)، arXiv:2611.17938.
کارایی پا به پا نخواهد رسید
تیم مدل را وارونه نیز اجرا کرد. در مسیر مرجع، حتی با 30% بهبود کارایی در هر سال، انتشار 2030 همچنان 27.5 برابر بالاتر از 2026 میماند. ثابت نگه داشتن انتشار به حدود 75% در سال نیاز دارد — حدود هفت برابر 10% که مدل فرض میکند، و فراتر از بهترین کاراییای که تاکنون روی هر مدلِ در حال بهرهبرداری اندازهگیری شده است. هدف خود بخش دیجیتال، همراستا با توافق پاریس، خواستار کاهش 45% انتشار میان 2020 و 2030 است.
کف، نه سقف
نویسندگان همهٔ این ارقام را بهعنوان حدهای پایین ارائه میکنند. مدل تولید تا 2030 ثابت نگه داشته میشود، در حالی که مدلهای واقعی احتمالاً پرمصرفتر خواهند شد؛ پخش جریانی، صدا و دیگر کاربردهای هوش مصنوعی کنار گذاشته شدهاند؛ آموزش، که کمترین مستندات را دارد، بر پایهٔ چند مدل باز کوچک کالیبره شده است. استفاده نیز میتواند بهسرعت کوچک شود، همانطور که تعطیلی Sora نشان داد. اما بر پایهٔ اعداد مقاله، ردپا تنها زمانی از رشد بازمیایستد که شمار ویدئوها، یا کیفیتشان، نیز از رشد بازایستد.