LOS VÍDEOS DE IA PODRÍAN EMITIR 75 VECES MÁS DE AQUÍ A 2030
Escribe una frase y obtén un videoclip: la generación de vídeo a partir de texto funciona ya a escala comercial. Ya se sabe que su coste por clip es alto. Según un estudio anterior de Delavande y sus colegas, generar un vídeo corto a partir de texto consume unos 90 vatios hora, casi 30 veces lo que una imagen y 45.000 veces lo que una simple tarea de clasificación de texto. Y los clips no se crean en el propio dispositivo del usuario: cada petición se ejecuta en bastidores de chips de IA en centros de datos.
Pero un coste por clip dice poco del total. No indica cuántos clips se generan, qué hardware hace falta ni cuánta agua consume la refrigeración. Y la eficiencia por clip puede mejorar mientras la huella total crece.
Tristan Coignion, de la Universidad de Lille, con A. Bugeau y G. Guennebaud en Burdeos y A.-L. Ligozat en Paris-Saclay, se propusieron estimar la huella total de la generación de vídeo con IA en todo el mundo, para 2026 y hasta 2030.
Contar los clips
Los proveedores rara vez dicen cuántos vídeos generan, así que el equipo midió lo que pudo. Rastreó el feed público de Sora, el servicio de vídeo de OpenAI, durante 54 días entre febrero y abril de 2026: 3,3 millones de vídeos públicos, es decir, unos 22 millones al año. Poco después, OpenAI cerró la versión web y la aplicación de Sora. El equipo también siguió el contador en directo de HeyGen durante 90 días: unos 111 millones de vídeos al año, incluidos los privados.
Otros seis proveedores publican sus propias cifras. El mayor con diferencia es Grok Imagine, con unos 3.800 millones al año. Sumadas, dan un total observable de unos 6.200 millones de vídeos al año. El modelo muestrea su volumen de 2026 entre 6.200 y 9.500 millones, con una mediana de 7.160 millones.
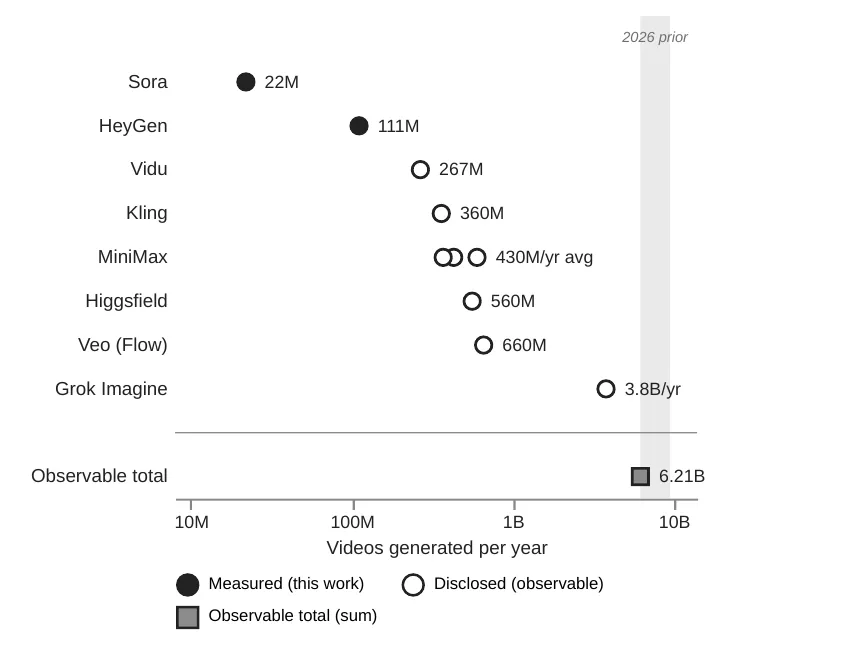
Vídeos de IA al año por servicio: puntos rellenos, medidos por el equipo; puntos vacíos, declarados por los proveedores; la banda sombreada es el rango del modelo para 2026. — Figura 1, Coignion et al. (2026), arXiv:2611.17938.
La factura de 2026
A partir de ahí, un modelo ascendente (bottom-up) dimensiona la flota de chips de IA necesaria y deduce después la electricidad, el agua, los gases de efecto invernadero y el agotamiento de los recursos minerales, con 10.000 simulaciones para captar la incertidumbre. Se incluyen el entrenamiento y el almacenamiento; el sonido y el streaming de los vídeos hacia los espectadores, no.
Para 2026, el resultado mediano es una flota de 72.600 procesadores gráficos, 724 gigavatios hora de electricidad y 124.300 toneladas de CO₂ equivalente. Si se toman los gases de efecto invernadero que la humanidad puede emitir cada año sin rebasar el límite climático del planeta y se reparten a partes iguales por persona, 124.300 toneladas son la asignación anual de unas 126.000 personas.
Por vídeo, el coste total asciende a unos 100 vatios hora: 4,1 veces los 24,4 vatios hora que gasta el chip por sí solo en una generación. La diferencia la marcan el tiempo inactivo, los consumos generales del edificio, el entrenamiento y el almacenamiento. Generar los vídeos supone alrededor del 69 % de las emisiones, entrenar los modelos el 31 %, y el almacenamiento casi nada. Y de dónde procede la electricidad importa más que cuánta se usa: para las emisiones, la intensidad de carbono de la red eléctrica pesa 12 veces más que el número de vídeos.
Tres futuros
Después, el modelo avanza hasta 2030 con tres escenarios, todos con el mismo progreso técnico constante: chips más nuevos y eficientes, y un software alrededor de un 10 % más eficiente cada año.
- Referencia: el número de vídeos se duplica en 2027, 2028 y 2029, y luego crece un 60 % en 2030: 12,8 veces en total, una trayectoria deliberadamente modesta. Las emisiones aumentan 74 veces y alcanzan unos 9,2 millones de toneladas en 2030: el presupuesto de unos 9,3 millones de personas. ¿Por qué más rápido que la demanda? Los vídeos se vuelven más largos y nítidos, así que la energía por vídeo pasa de 24,4 a 214 vatios hora.
- Estancamiento del uso: el volumen, la resolución y la duración se mantienen en los niveles de 2026. Las emisiones bajan unos dos quintos. Es el único escenario en que disminuyen.
- Adopción masiva: el volumen se multiplica por 60. Las emisiones alcanzan 42,9 millones de toneladas, el presupuesto de unos 44 millones de personas.
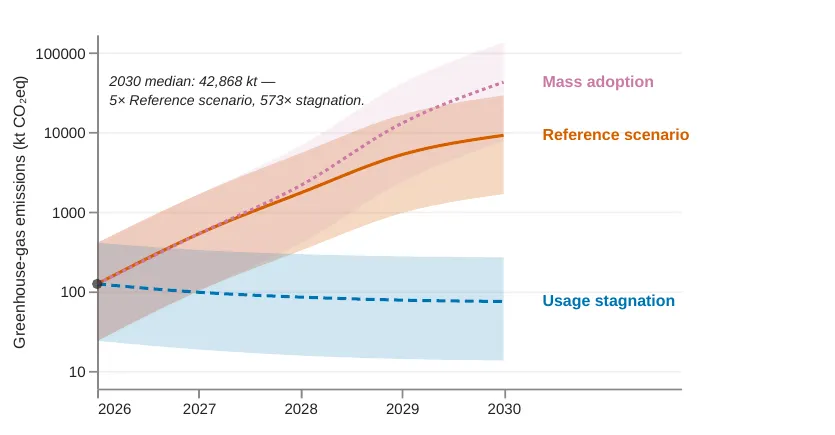
Emisiones en los tres escenarios, 2026–2030; las líneas son medianas y las bandas, el rango del 5–95 %. — Figura 6, Coignion et al. (2026), arXiv:2611.17938.
La eficiencia no dará alcance
El equipo también ejecutó el modelo a la inversa. En la trayectoria de referencia, incluso una ganancia de eficiencia del 30 % cada año deja las emisiones de 2030 27,5 veces por encima de las de 2026. Mantener las emisiones estables exigiría alrededor de un 75 % anual, unas siete veces el 10 % que supone el modelo, y más de lo que permite la mejor eficiencia medida en cualquier modelo en producción. El propio objetivo del sector digital, alineado con el Acuerdo de París, exige un recorte del 45 % de las emisiones entre 2020 y 2030.
Un suelo, no un techo
Los autores presentan todas estas cifras como cotas inferiores. El modelo de generación se mantiene fijo hasta 2030, mientras que los modelos reales probablemente serán más exigentes; el streaming, el sonido y otros usos de la IA quedan fuera; el entrenamiento, la parte peor documentada, se calibra con unos pocos modelos abiertos pequeños. El uso también puede reducirse rápido, como mostró el cierre de Sora. Pero con las cifras del artículo, la huella solo deja de crecer si el número de vídeos, o su calidad, deja también de crecer.