2030-এর মধ্যে AI ভিডিওর নিঃসরণ 75 গুণ বাড়তে পারে
একটি বাক্য লিখুন, পেয়ে যান একটি ভিডিও ক্লিপ: লেখা থেকে ভিডিও তৈরি (text-to-video) এখন বাণিজ্যিক মাত্রায় চলে। প্রতি ক্লিপে এর খরচ যে বেশি, তা আগে থেকেই জানা। Delavande ও সহকর্মীদের আগের একটি গবেষণা অনুযায়ী, লেখা থেকে একটি ছোট ভিডিও তৈরিতে লাগে মোটামুটি 90 ওয়াট-ঘণ্টা, যা একটি ছবির প্রায় 30 গুণ এবং একটি সাধারণ লেখা-শ্রেণিবিন্যাসের কাজের 45,000 গুণ। আর ক্লিপগুলো ব্যবহারকারীর নিজের যন্ত্রে তৈরি হয় না: প্রতিটি অনুরোধ চলে ডেটা সেন্টারে সারি সারি তাকে রাখা AI চিপে।
কিন্তু প্রতি ক্লিপের খরচ মোট পরিমাণ সম্পর্কে খুব কমই বলে। এটি জানায় না কতগুলো ক্লিপ তৈরি হয়, তার জন্য কোন হার্ডওয়্যার লাগে, বা শীতলীকরণে কতটা পানি খরচ হয়। আর প্রতি ক্লিপের দক্ষতা বাড়তে পারে, অথচ মোট পদচিহ্ন (footprint) বাড়তেই থাকে।
University of Lille-এর Tristan Coignion, বোর্দোর A. Bugeau ও G. Guennebaud এবং Paris-Saclay-এর A.-L. Ligozat-এর সঙ্গে মিলে, বিশ্বজুড়ে AI ভিডিও তৈরির সম্পূর্ণ পদচিহ্ন অনুমান করার কাজে নেমেছেন — 2026 সালের জন্য এবং 2030 পর্যন্ত।
ক্লিপ গোনা
সরবরাহকারীরা কদাচিৎই জানায় তারা কতগুলো ভিডিও তৈরি করে, তাই দলটি যা মাপা সম্ভব তা মেপেছে। ফেব্রুয়ারি থেকে এপ্রিল 2026-এর মধ্যে 54 দিন ধরে দলটি OpenAI-এর ভিডিও পরিষেবা Sora-র পাবলিক ফিড ঘেঁটে দেখেছে: 3.3 মিলিয়ন পাবলিক ভিডিও, অর্থাৎ বছরে প্রায় 22 মিলিয়ন। এর কিছু পরেই OpenAI Sora-র ওয়েব ও অ্যাপ পরিষেবা বন্ধ করে দেয়। দলটি 90 দিন ধরে HeyGen-এর লাইভ কাউন্টারও অনুসরণ করেছে: বছরে প্রায় 111 মিলিয়ন ভিডিও, ব্যক্তিগতগুলো সহ।
আরও ছয়টি সরবরাহকারী নিজেদের হিসাব প্রকাশ করে। এদের মধ্যে অনেক ব্যবধানে সবচেয়ে বড় Grok Imagine, বছরে প্রায় 3.8 বিলিয়ন। সব যোগ করলে পর্যবেক্ষণযোগ্য মোট দাঁড়ায় বছরে প্রায় 6.2 বিলিয়ন ভিডিও। মডেলটি 2026 সালের ভিডিওর সংখ্যা নেয় 6.2 থেকে 9.5 বিলিয়নের মধ্যে থেকে, যার মধ্যমা 7.16 বিলিয়ন।
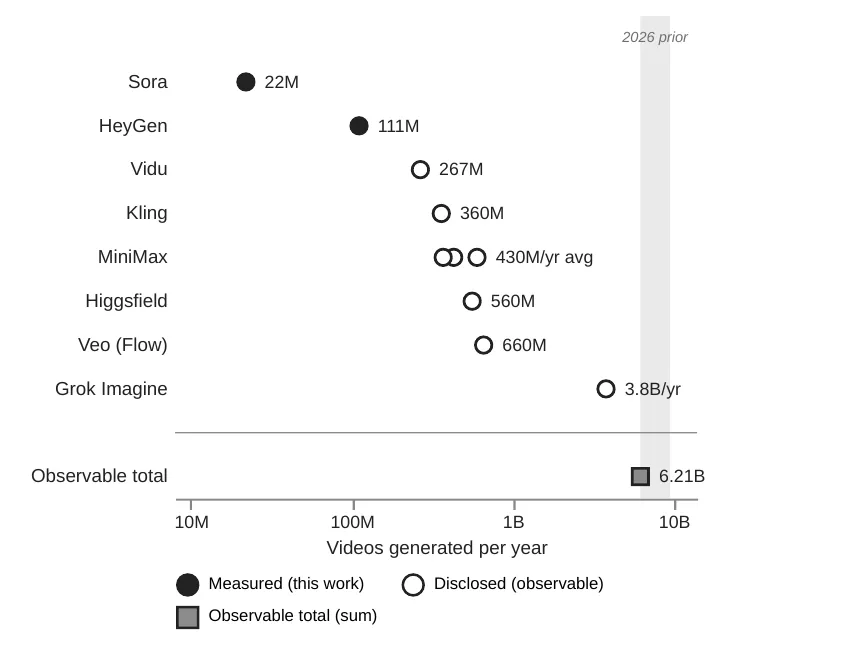
পরিষেবা অনুযায়ী বার্ষিক AI ভিডিও: ভরাট বিন্দু দলটির মাপা, ফাঁকা বিন্দু সরবরাহকারীদের প্রকাশিত; ছায়াঘেরা পট্টিটি 2026 সালের জন্য মডেলের পরিসর। — চিত্র 1, Coignion et al. (2026), arXiv:2611.17938.
2026 সালের বিল
সেখান থেকে একটি নিচ থেকে ওপরে গড়া (bottom-up) মডেল প্রয়োজনীয় AI চিপের বহরের আকার নির্ধারণ করে, তারপর বিদ্যুৎ, পানি, গ্রিনহাউস গ্যাস ও খনিজ সম্পদের ক্ষয় নির্ণয় করে, অনিশ্চয়তা ধরতে 10,000টি সিমুলেশন চালিয়ে। প্রশিক্ষণ ও সংরক্ষণ অন্তর্ভুক্ত; শব্দ, এবং দর্শকদের কাছে ভিডিও স্ট্রিমিং, অন্তর্ভুক্ত নয়।
2026 সালের জন্য মধ্যমা ফল হলো 72,600টি গ্রাফিক্স প্রসেসরের একটি বহর, 724 গিগাওয়াট-ঘণ্টা বিদ্যুৎ এবং 124,300 টন CO₂ সমতুল্য। গ্রহের জলবায়ু-সীমা না পেরিয়ে মানবজাতি প্রতি বছর যতটা গ্রিনহাউস গ্যাস নিঃসরণ করতে পারে, তা নিয়ে প্রতিজনের মধ্যে সমান ভাগে ভাগ করুন: 124,300 টন হলো প্রায় 126,000 মানুষের বার্ষিক বরাদ্দ।
প্রতি ভিডিওতে সব মিলিয়ে খরচ দাঁড়ায় প্রায় 100 ওয়াট-ঘণ্টা — একবার তৈরিতে শুধু চিপটি যে 24.4 ওয়াট-ঘণ্টা খরচ করে তার 4.1 গুণ। অলস সময়, ভবনের বাড়তি খরচ, প্রশিক্ষণ ও সংরক্ষণ এই পার্থক্য গড়ে দেয়। নিঃসরণের প্রায় 69% আসে ভিডিও তৈরি থেকে, মডেল প্রশিক্ষণ থেকে 31%, সংরক্ষণ থেকে প্রায় কিছুই না। আর বিদ্যুৎ কতটা ব্যবহার হয় তার চেয়ে বেশি গুরুত্বপূর্ণ বিদ্যুৎ কোথা থেকে আসে: নিঃসরণের ক্ষেত্রে বিদ্যুৎ-গ্রিডের কার্বন-তীব্রতার ওজন ভিডিওর সংখ্যার চেয়ে 12 গুণ বেশি।
তিনটি ভবিষ্যৎ
এরপর মডেলটি তিনটি দৃশ্যপটে 2030 পর্যন্ত চালানো হয়, সবগুলোতেই একই স্থির প্রযুক্তিগত অগ্রগতি ধরে: নতুন, আরও দক্ষ চিপ, এবং প্রতি বছর প্রায় 10% বেশি দক্ষ সফটওয়্যার।
- রেফারেন্স: ভিডিওর সংখ্যা 2027, 2028 ও 2029 সালে দ্বিগুণ হয়, তারপর 2030 সালে বাড়ে 60% — সব মিলিয়ে 12.8 গুণ, ইচ্ছাকৃতভাবে পরিমিত একটি পথ। নিঃসরণ বাড়ে 74 গুণ, 2030 সালে পৌঁছায় প্রায় 9.2 মিলিয়ন টনে: প্রায় 9.3 মিলিয়ন মানুষের বাজেট। চাহিদার চেয়ে দ্রুত কেন? ভিডিওগুলো হয় আরও দীর্ঘ ও আরও ঝকঝকে, তাই প্রতি ভিডিওর শক্তি বেড়ে যায় 24.4 থেকে 214 ওয়াট-ঘণ্টায়।
- ব্যবহারে স্থবিরতা: সংখ্যা, রেজোলিউশন ও দৈর্ঘ্য থাকে 2026-এর স্তরে। নিঃসরণ কমে প্রায় পাঁচ ভাগের দুই ভাগ। এটিই একমাত্র দৃশ্যপট যেখানে তা কমে।
- ব্যাপক গ্রহণ: সংখ্যা বাড়ে 60 গুণ। নিঃসরণ পৌঁছায় 42.9 মিলিয়ন টনে — প্রায় 44 মিলিয়ন মানুষের বাজেট।
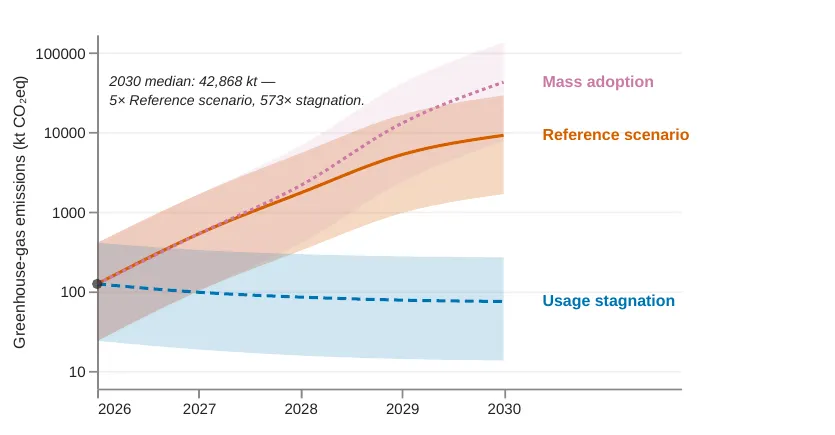
তিনটি দৃশ্যপটে নিঃসরণ, 2026–2030; রেখাগুলো মধ্যমা, পট্টিগুলো 5–95% পরিসর। — চিত্র 6, Coignion et al. (2026), arXiv:2611.17938.
দক্ষতা তাল মেলাতে পারবে না
দলটি মডেলটিকে উল্টো দিকেও চালিয়েছে। রেফারেন্স পথে, এমনকি প্রতি বছর 30% দক্ষতা বৃদ্ধিও 2030 সালের নিঃসরণকে 2026-এর চেয়ে 27.5 গুণ বেশি রেখে দেয়। নিঃসরণ স্থির রাখতে লাগবে বছরে প্রায় 75% — মডেলের ধরে নেওয়া 10%-এর প্রায় সাত গুণ, এবং বাস্তবে চালু থাকা যেকোনো মডেলে মাপা সেরা দক্ষতারও বাইরে। প্যারিস চুক্তির সঙ্গে সামঞ্জস্যপূর্ণ ডিজিটাল খাতের নিজস্ব লক্ষ্য 2020 থেকে 2030-এর মধ্যে নিঃসরণে 45% কাটছাঁট দাবি করে।
মেঝে, ছাদ নয়
লেখকেরা এই সব পরিসংখ্যানকে নিম্নসীমা হিসেবে উপস্থাপন করেন। ভিডিও-তৈরির মডেলটি 2030 পর্যন্ত অপরিবর্তিত ধরা হয়েছে, অথচ বাস্তবের মডেলগুলো সম্ভবত আরও বেশি সম্পদ দাবি করবে; স্ট্রিমিং, শব্দ ও AI-এর অন্যান্য ব্যবহার বাদ রাখা হয়েছে; প্রশিক্ষণ, যা সবচেয়ে কম নথিভুক্ত অংশ, ক্যালিব্রেট করা হয়েছে কয়েকটি ছোট ওপেন মডেলের ভিত্তিতে। ব্যবহার দ্রুত কমেও যেতে পারে, যেমনটা Sora বন্ধ হওয়ায় দেখা গেছে। কিন্তু গবেষণাপত্রের সংখ্যাগুলো অনুযায়ী, পদচিহ্নের বৃদ্ধি থামে কেবল তখনই, যখন ভিডিওর সংখ্যা, বা তাদের মান, বাড়াও থামে।