KI-VIDEOS KÖNNTEN BIS 2030 75-MAL MEHR EMISSIONEN VERURSACHEN
Einen Satz eintippen, einen Videoclip bekommen: Die Text-zu-Video-Generierung läuft inzwischen in kommerziellem Maßstab. Dass ihre Kosten pro Clip hoch sind, ist bereits bekannt. Laut einer früheren Studie von Delavande und Kollegen verbraucht die Erzeugung eines kurzen Videos aus Text rund 90 Wattstunden, fast 30-mal so viel wie ein Bild und 45.000-mal so viel wie eine einfache Textklassifikationsaufgabe. Und die Clips entstehen nicht auf dem eigenen Gerät der Nutzer: Jede Anfrage läuft auf Racks von KI-Chips in Rechenzentren.
Doch Kosten pro Clip sagen wenig über die Gesamtsumme. Sie verraten nicht, wie viele Clips erzeugt werden, welche Hardware das erfordert oder wie viel Wasser die Kühlung verbraucht. Und die Effizienz pro Clip kann sich verbessern, während der Gesamtfußabdruck wächst.
Tristan Coignion von der University of Lille machte sich zusammen mit A. Bugeau und G. Guennebaud in Bordeaux und A.-L. Ligozat in Paris-Saclay daran, den gesamten Fußabdruck der KI-Videogenerierung weltweit abzuschätzen – für 2026 und bis 2030.
Die Clips zählen
Anbieter sagen selten, wie viele Videos sie erzeugen, also maß das Team, was es messen konnte. Es durchsuchte 54 Tage lang, zwischen Februar und April 2026, den öffentlichen Feed von Sora, dem Videodienst von OpenAI: 3,3 Millionen öffentliche Videos, also etwa 22 Millionen pro Jahr. OpenAI stellte die Web- und App-Angebote von Sora kurz darauf ein. Außerdem verfolgte das Team 90 Tage lang den Live-Zähler von HeyGen: etwa 111 Millionen Videos pro Jahr, private eingeschlossen.
Sechs weitere Anbieter veröffentlichen eigene Zahlen. Der mit Abstand größte ist Grok Imagine mit etwa 3,8 Milliarden pro Jahr. Zusammengezählt ergeben sie eine beobachtbare Gesamtzahl von etwa 6,2 Milliarden Videos pro Jahr. Das Modell zieht sein Volumen für 2026 zwischen 6,2 und 9,5 Milliarden, mit einem Median von 7,16 Milliarden.
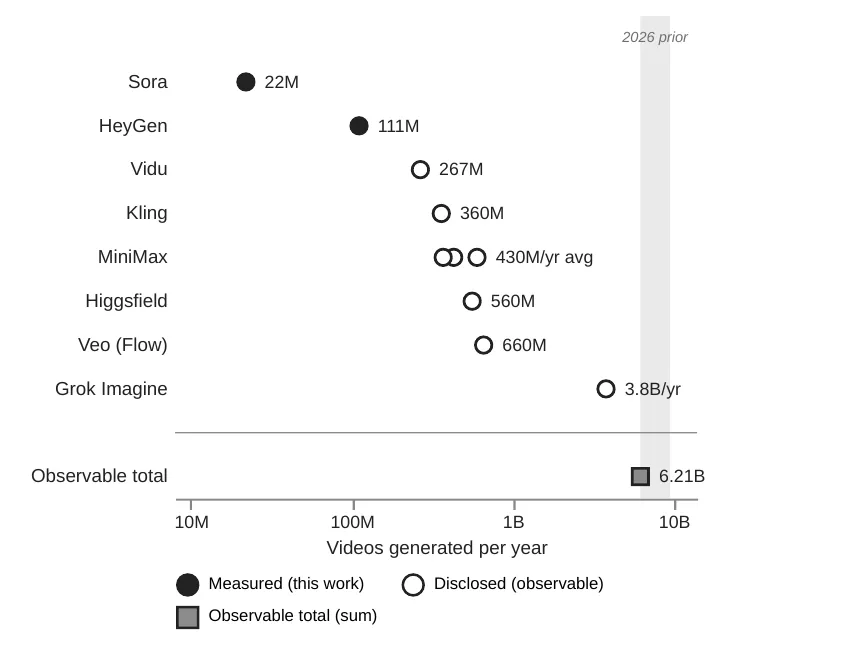
Jährliche KI-Videos pro Dienst: gefüllte Punkte vom Team gemessen, leere Punkte von den Anbietern angegeben; das schattierte Band ist die Spanne des Modells für 2026. — Abb. 1, Coignion et al. (2026), arXiv:2611.17938.
Die Rechnung für 2026
Davon ausgehend dimensioniert ein Bottom-up-Modell die benötigte Flotte von KI-Chips und leitet daraus Strom, Wasser, Treibhausgase und die Erschöpfung mineralischer Ressourcen ab, mit 10.000 Simulationen, um die Unsicherheit zu erfassen. Training und Speicherung sind eingeschlossen; Ton und das Streaming der Videos an die Zuschauer nicht.
Für 2026 ergibt der Median eine Flotte von 72.600 Grafikprozessoren, 724 Gigawattstunden Strom und 124.300 Tonnen CO₂-Äquivalent. Nimmt man die Treibhausgase, die die Menschheit jedes Jahr ausstoßen kann, ohne die Klimagrenze des Planeten zu überschreiten, und teilt sie gleichmäßig pro Person auf, dann sind 124.300 Tonnen das jährliche Budget von etwa 126.000 Menschen.
Pro Video belaufen sich die Gesamtkosten auf etwa 100 Wattstunden – das 4,1-Fache der 24,4 Wattstunden, die der Chip allein für eine Generierung aufwendet. Leerlaufzeiten, der Zusatzverbrauch der Gebäude, Training und Speicherung machen den Unterschied aus. Die Erzeugung der Videos verursacht etwa 69 % der Emissionen, das Training der Modelle 31 %, die Speicherung fast nichts. Und woher der Strom kommt, zählt mehr als wie viel davon verbraucht wird: Für die Emissionen wiegt die Kohlenstoffintensität des Stromnetzes 12-mal stärker als die Zahl der Videos.
Drei Zukünfte
Das Modell läuft dann bis 2030 unter drei Szenarien, alle mit demselben stetigen technischen Fortschritt: neuere, effizientere Chips und Software, die jedes Jahr etwa 10 % effizienter wird.
- Referenz: Die Zahl der Videos verdoppelt sich 2027, 2028 und 2029 und wächst 2030 dann um 60 % – insgesamt auf das 12,8-Fache, ein bewusst bescheidener Pfad. Die Emissionen wachsen auf das 74-Fache und erreichen 2030 etwa 9,2 Millionen Tonnen: das Budget von etwa 9,3 Millionen Menschen. Warum schneller als die Nachfrage? Die Videos werden länger und schärfer, also steigt die Energie pro Video von 24,4 auf 214 Wattstunden.
- Nutzungsstagnation: Volumen, Auflösung und Dauer bleiben auf dem Stand von 2026. Die Emissionen sinken um etwa zwei Fünftel. Es ist das einzige Szenario, in dem sie zurückgehen.
- Massenverbreitung: Das Volumen wächst auf das 60-Fache. Die Emissionen erreichen 42,9 Millionen Tonnen – das Budget von etwa 44 Millionen Menschen.
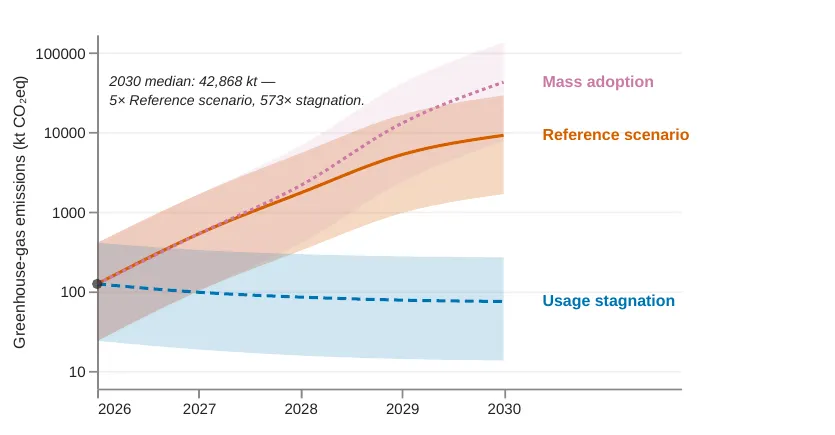
Emissionen in den drei Szenarien, 2026–2030; Linien sind Mediane, Bänder der Bereich 5–95 %. — Abb. 6, Coignion et al. (2026), arXiv:2611.17938.
Die Effizienz holt nicht auf
Das Team ließ das Modell auch rückwärts laufen. Im Referenzpfad lässt selbst ein Effizienzgewinn von 30 % pro Jahr die Emissionen 2030 27,5-mal über denen von 2026 liegen. Um die Emissionen konstant zu halten, bräuchte es etwa 75 % pro Jahr – rund siebenmal so viel wie die 10 %, die das Modell annimmt, und mehr als die beste Effizienz, die je an einem Produktionsmodell gemessen wurde. Das eigene Ziel des Digitalsektors, im Einklang mit dem Pariser Abkommen, verlangt eine Senkung um 45 % der Emissionen zwischen 2020 und 2030.
Eine Untergrenze, keine Obergrenze
Die Autoren stellen all diese Zahlen als Untergrenzen dar. Das Generierungsmodell bleibt bis 2030 unverändert, während reale Modelle wahrscheinlich anspruchsvoller werden; Streaming, Ton und andere KI-Anwendungen bleiben außen vor; das Training, der am wenigsten dokumentierte Teil, ist an einigen wenigen kleinen offenen Modellen kalibriert. Die Nutzung kann auch schnell schrumpfen, wie die Schließung von Sora gezeigt hat. Doch nach den Zahlen des Artikels hört der Fußabdruck nur dann auf zu wachsen, wenn auch die Zahl der Videos oder ihre Qualität aufhört zu wachsen.