到2030年,AI视频的排放可能增至75倍
输入一句话,得到一段视频:文本生成视频如今已在商业规模上运行。众所周知,它每段视频的成本已经很高。根据Delavande及其同事此前的一项研究,从文本生成一段短视频大约消耗90瓦时,几乎是生成一张图像的30倍,是一项简单文本分类任务的45,000倍。而且这些视频并不是在用户自己的设备上生成的:每个请求都在数据中心里一排排AI芯片机架上运行。
但每段视频的成本几乎说明不了总量。它无法告诉我们生成了多少段视频、这需要什么样的硬件,或者冷却要用多少水。而且每段视频的效率可以提高,与此同时总足迹却在增长。
里尔大学的Tristan Coignion,与波尔多的A. Bugeau和G. Guennebaud以及巴黎-萨克雷的A.-L. Ligozat一起,着手估算全球AI视频生成的全部足迹——涵盖2026年,并一直延伸到2030年。
数一数视频
服务商很少公布自己生成了多少视频,所以团队测量了能测量的东西。团队在2026年2月到4月之间,用54天抓取了OpenAI的视频服务Sora的公开信息流:330万条公开视频,约合每年2200万条。此后不久,OpenAI关闭了Sora的网页版和应用。团队还跟踪了HeyGen的实时计数器90天:约每年1.11亿条视频,包括私密视频在内。
另外六家服务商公布了它们自己的数量。其中遥遥领先的是Grok Imagine,每年约38亿条。把这些加起来,可观测的总量约为每年62亿条视频。模型把2026年的数量取在62亿到95亿之间,中位数为71.6亿。
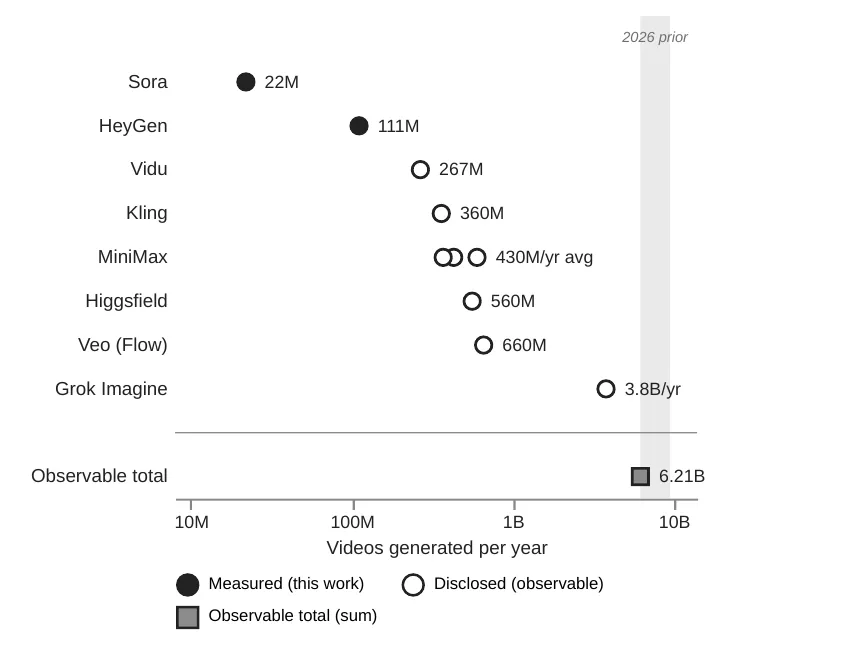
各服务每年生成的AI视频:实心点为团队测得,空心点为服务商公布;阴影带是模型对2026年的取值范围。——图1,Coignion等(2026),arXiv:2611.17938。
2026年的账单
在此基础上,一个自下而上的模型估算出所需AI芯片队伍的规模,再推算出电力、水、温室气体和矿产资源的耗竭,并运行10,000次模拟来把握不确定性。训练和存储计算在内;声音以及向观众流式传输视频则不在其中。
2026年的中位结果是:一支由72,600个图形处理器组成的队伍、724吉瓦时的电力,以及124,300吨CO₂当量。把人类每年在不突破地球气候限度的前提下可以排放的温室气体按人均平分:124,300吨就是约126,000人一年的排放额度。
每段视频的全部成本约为100瓦时——是芯片单独完成一次生成所耗24.4瓦时的4.1倍。闲置时间、建筑开销、训练和存储造成了这一差距。生成视频约占排放的69%,训练模型占31%,存储几乎可以忽略不计。而且电力来自哪里比用了多少更重要:就排放而言,电网碳强度的分量是视频数量的12倍。
三种未来
接着,模型在三种情景下一直运行到2030年,三者都采用同样稳定的技术进步:更新、更高效的芯片,以及每年效率提高约10%的软件。
- 参考情景:视频数量在2027、2028和2029年各翻一番,然后在2030年增长60%——总共增至12.8倍,这是一条刻意保守的路径。排放增至74倍,到2030年达到约920万吨:约相当于930万人的预算。为什么比需求增长得更快?视频变得更长、更清晰,所以每段视频的能耗从24.4瓦时升至214瓦时。
- 使用停滞:数量、分辨率和时长都保持在2026年的水平。排放下降约五分之二。这是排放唯一下降的情景。
- 大规模采用:数量增至60倍。排放达到4290万吨——约相当于4400万人的预算。
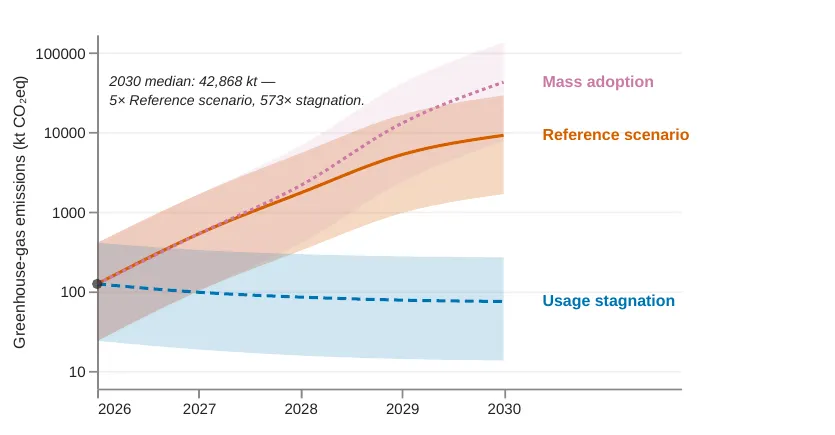
三种情景下的排放,2026–2030年;线条为中位数,色带为5–95%范围。——图6,Coignion等(2026),arXiv:2611.17938。
效率追不上
团队还把模型倒过来运行。在参考路径下,即使每年效率提高30%,2030年的排放仍是2026年的27.5倍。要让排放保持不变,大约需要每年75%——约为模型所假设的10%的七倍,而且超过了在任何投入生产的模型上测得的最佳效率。数字行业自己的目标与《巴黎协定》一致,要求在2020年到2030年间把排放削减45%。
是下限,而不是上限
作者把所有这些数字都视为下限。生成模型被固定不变直到2030年,而真实的模型很可能会变得更加耗费资源;流式传输、声音以及其他AI用途都没有计入;训练是记录最少的部分,只用几个小型开放模型来校准。正如Sora的关闭所表明的,使用量也可能迅速萎缩。但按照论文的数字,只有当视频数量或者视频质量也停止增长时,足迹才会停止增长。