VÍDEOS DE IA PODEM EMITIR 75 VEZES MAIS ATÉ 2030
Digite uma frase, receba um clipe de vídeo: a geração de vídeo a partir de texto já funciona em escala comercial. Já se sabe que seu custo por clipe é alto. Segundo um estudo anterior de Delavande e colegas, gerar um vídeo curto a partir de texto consome cerca de 90 watts-hora, quase 30 vezes o de uma imagem e 45.000 vezes o de uma simples tarefa de classificação de texto. E os clipes não são feitos no próprio aparelho do usuário: cada pedido roda em racks de chips de IA em centros de dados.
Mas um custo por clipe diz pouco sobre o total. Ele não diz quantos clipes são feitos, que hardware isso exige, nem quanta água o resfriamento usa. E a eficiência por clipe pode melhorar enquanto a pegada total cresce.
Tristan Coignion, da Universidade de Lille, com A. Bugeau e G. Guennebaud em Bordeaux e A.-L. Ligozat em Paris-Saclay, se propôs a estimar a pegada total da geração de vídeo por IA no mundo — para 2026 e até 2030.
Contando os clipes
Os provedores raramente dizem quantos vídeos geram, então a equipe mediu o que pôde. Ela percorreu o feed público do Sora, o serviço de vídeo da OpenAI, durante 54 dias entre fevereiro e abril de 2026: 3,3 milhões de vídeos públicos, ou cerca de 22 milhões por ano. A OpenAI encerrou as versões web e de aplicativo do Sora pouco depois. A equipe também acompanhou o contador ao vivo da HeyGen durante 90 dias: cerca de 111 milhões de vídeos por ano, incluindo os privados.
Seis outros provedores publicam suas próprias contagens. O maior, de longe, é o Grok Imagine, com cerca de 3,8 bilhões por ano. Somadas, essas contagens dão um total observável de cerca de 6,2 bilhões de vídeos por ano. O modelo sorteia seu volume de 2026 entre 6,2 e 9,5 bilhões, com mediana de 7,16 bilhões.
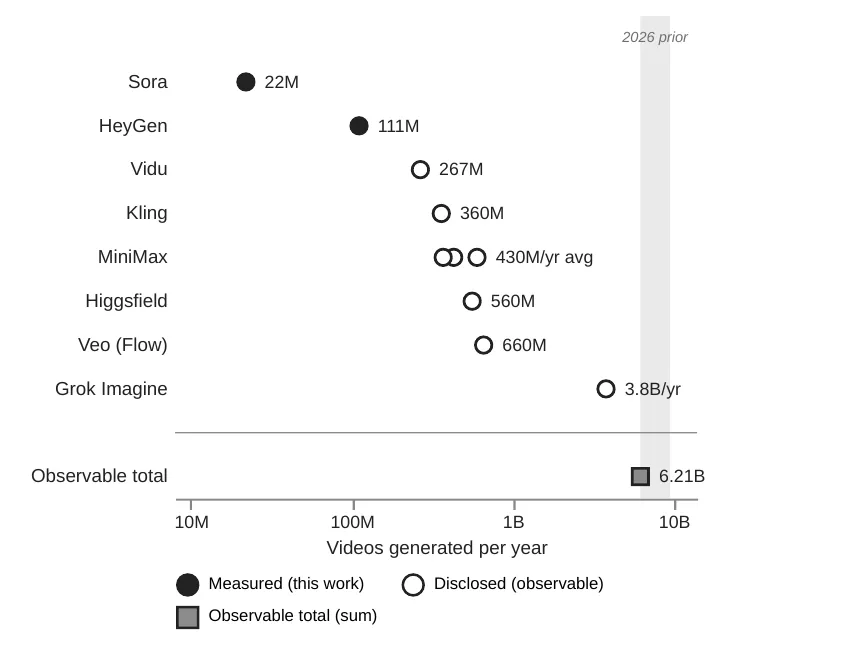
Vídeos de IA por ano e por serviço: pontos cheios medidos pela equipe, pontos vazios divulgados pelos provedores; a faixa sombreada é o intervalo do modelo para 2026. — Fig. 1, Coignion et al. (2026), arXiv:2611.17938.
A conta de 2026
A partir daí, um modelo de baixo para cima (bottom-up) dimensiona a frota de chips de IA necessária e depois deriva a eletricidade, a água, os gases de efeito estufa e o esgotamento de recursos minerais, rodando 10.000 simulações para captar a incerteza. O treinamento e o armazenamento estão incluídos; o som e a transmissão dos vídeos aos espectadores (streaming) não estão.
Para 2026, o resultado mediano é uma frota de 72.600 processadores gráficos, 724 gigawatts-hora de eletricidade e 124.300 toneladas de CO₂ equivalente. Pegue os gases de efeito estufa que a humanidade pode emitir a cada ano sem ultrapassar o limite climático do planeta e reparta-os igualmente por pessoa: 124.300 toneladas são a cota anual de cerca de 126.000 pessoas.
Por vídeo, o custo total chega a cerca de 100 watts-hora — 4,1 vezes os 24,4 watts-hora que o chip sozinho gasta numa geração. O tempo ocioso, o consumo adicional dos edifícios, o treinamento e o armazenamento fazem a diferença. Gerar os vídeos responde por cerca de 69% das emissões, treinar os modelos por 31%, o armazenamento por quase nada. E a origem da eletricidade importa mais do que a quantidade usada: para as emissões, a intensidade de carbono da rede elétrica pesa 12 vezes mais do que o número de vídeos.
Três futuros
O modelo então avança até 2030 em três cenários, todos com o mesmo progresso técnico constante: chips mais novos e mais eficientes e software cerca de 10% mais eficiente a cada ano.
- Referência: o número de vídeos dobra em 2027, 2028 e 2029, e depois cresce 60% em 2030 — 12,8 vezes no total, um caminho deliberadamente modesto. As emissões crescem 74 vezes, chegando a cerca de 9,2 milhões de toneladas em 2030: o orçamento de cerca de 9,3 milhões de pessoas. Por que mais rápido que a demanda? Os vídeos ficam mais longos e mais nítidos, então a energia por vídeo sobe de 24,4 para 214 watts-hora.
- Estagnação do uso: volume, resolução e duração ficam nos níveis de 2026. As emissões caem cerca de dois quintos. É o único cenário em que elas diminuem.
- Adoção em massa: o volume cresce 60 vezes. As emissões chegam a 42,9 milhões de toneladas — o orçamento de cerca de 44 milhões de pessoas.
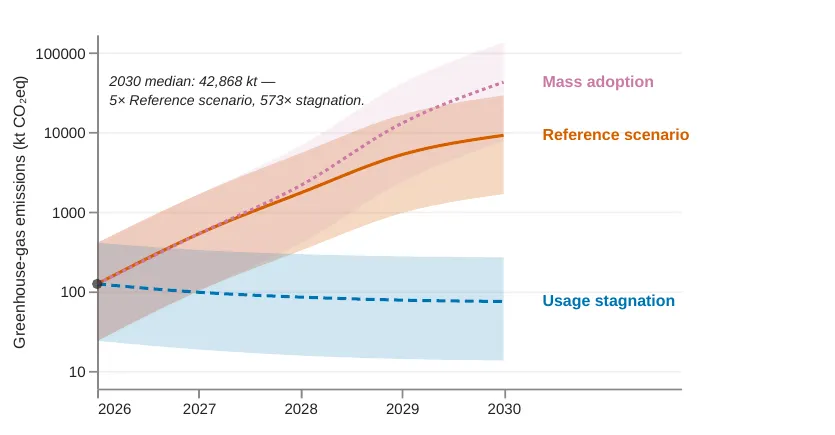
Emissões nos três cenários, 2026–2030; as linhas são medianas, as faixas o intervalo de 5–95%. — Fig. 6, Coignion et al. (2026), arXiv:2611.17938.
A eficiência não vai alcançar
A equipe também rodou o modelo ao contrário. No caminho de referência, mesmo um ganho de eficiência de 30% ao ano deixa as emissões de 2030 27,5 vezes acima das de 2026. Manter as emissões estáveis exigiria cerca de 75% ao ano — umas sete vezes os 10% que o modelo supõe, e além da melhor eficiência medida em qualquer modelo em produção. A meta do próprio setor digital, alinhada ao Acordo de Paris, prevê um corte de 45% nas emissões entre 2020 e 2030.
Um piso, não um teto
Os autores apresentam todos esses números como limites inferiores. O modelo de geração é mantido fixo até 2030, enquanto os modelos reais provavelmente ficarão mais exigentes; o streaming, o som e outros usos da IA ficam de fora; o treinamento, a parte menos documentada, é calibrado em alguns poucos modelos abertos pequenos. O uso também pode encolher rapidamente, como mostrou o fechamento do Sora. Mas, com os números do artigo, a pegada só para de crescer se o número de vídeos, ou sua qualidade, também parar de crescer.